


 家
能動的AIの拡張には高度な記憶システムが必要
エージェント型AIは単純なチャットボットから複雑なワークフロー管理への重要な転換点であり、その拡張には記憶アーキテクチャへの新たなアプローチが求められる。
基盤モデルが数兆のパラメータに成長し、コンテキストウィンドウが数百万トークンに拡大するにつれ、履歴を保持するための計算コストが、それを効果的に処理する能力を上回りつつある。
これらのシステムを導入する組織は現在、膨大な量の「長期記憶」(技術的にはキーバリュー(KV)キャッシュ)が現行ハードウェア設計の能力を超えるボトルネックに直面している。
既存インフラでは選択肢が限られています:推論コンテキストを希少な高帯域GPUメモリ(HBM)に保存するか、低速な汎用ストレージに移すかです。前者は大規模コンテキストではコストがかかりすぎ、後者はリアルタイムのエージェント的相互作用を不可能にする遅延を発生させます。
この拡大するギャップはエージェント型AIのスケーリングを阻害しており、NVIDIAはRubinアーキテクチャ内に推論コンテキストメモリストレージ(ICMS)プラットフォームを導入。AIメモリの一時的かつ高速な要求に特化した新たなストレージ層を構築した。
「AIはコンピューティングスタック全体を変革しつつあり、今やストレージ領域にも及んでいる」と黄氏は述べた。「AIは単一応答型チャットボットを超え、物理世界を理解し、長期にわたる推論を行い、事実に基づき、実用的なタスクにツールを活用し、短期記憶と長期記憶の両方を維持する知的な協力者へと進化した」
中核的な運用課題は、トランスフォーマーベースモデルの動作原理に起因する。生成される新たな単語ごとに会話全体を再計算するのを防ぐため、モデルは過去の状態をKVキャッシュに保存する。エージェント型ワークフローでは、このキャッシュがツールやセッションを跨ぐ永続的メモリとして機能し、シーケンス長に比例して拡張する。
これにより独自のデータカテゴリーが生成される。財務記録や顧客ログとは異なり、KVキャッシュは派生データである。即時性能には不可欠だが、エンタープライズファイルシステムのような堅牢な耐久性保証を必要としない。汎用ストレージシステム(標準CPU上で動作)はメタデータ管理やレプリケーションにエネルギーを消費するが、エージェント型ワークロードはこれらの恩恵を受けない。
GPU HBM(G1)から共有ストレージ(G4)に至る既存の階層構造は、次第に非効率化が進んでいる:
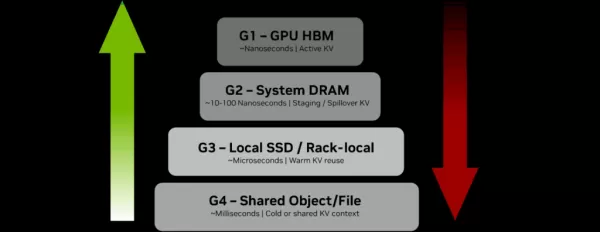
(出典: NVIDIA) コンテキストデータがGPU(G1)からシステムRAM(G2)、最終的に共有ストレージ(G4)へ移動するにつれ、効率は大幅に低下します。アクティブなコンテキストをG4層に転送するとミリ秒レベルの遅延が発生し、トークンあたりのエネルギーコストが上昇。データ待ちで高価なGPUがアイドル状態になります。
企業にとっては、インフラのオーバーヘッドに電力が消費され、アクティブな推論タスクに電力が使われないため、総所有コスト(TCO)の増加につながります。
AIファクトリー向け新メモリ階層
業界の解決策は、この階層にカスタム構築のレイヤーを追加することです。ICMSプラットフォームは「G3.5」層を創出します。これは大規模推論専用に設計されたイーサネット接続フラッシュストレージ層です。
この手法ではストレージをコンピューティングポッドに直接統合。NVIDIA BlueField-4データプロセッサを活用し、コンテキストデータ管理をホストCPUから移行させる。システムはポッドあたりペタバイト級の共有容量を提供し、エージェントが膨大な履歴を保持できるため、高価なHBMを消費せずにエージェント型AIのスケーリングを強化する。
運用上の利点はスループットとエネルギー使用量の両面で測定可能です。標準ストレージより高速でありながらHBMより低コストなこの中間層に関連コンテキストを保存することで、システムは事前にメモリをGPUへ「プリロード」できます。これによりGPUデコーダのアイドル時間が削減され、長コンテキストワークロードにおいて最大5倍のトークン毎秒処理能力(TPS)を実現します。
エネルギー効率の観点でも、同様に大きなメリットがあります。このアーキテクチャは汎用ストレージプロトコルのオーバーヘッドを排除するため、従来手法と比較して5倍の電力効率を実現します。
データプレーンの統合
このアーキテクチャの導入には、ITチームがストレージネットワークを捉える方法の転換が必要です。ICMSプラットフォームは、フラッシュストレージをローカルメモリのように扱うために必要な高帯域幅・低ジッター接続を実現するため、NVIDIA Spectrum-X Ethernetに依存しています。
エンタープライズインフラチームにとっての主要な統合ポイントはオーケストレーション層です。NVIDIA Dynamoや推論転送ライブラリ(NIXL)といったフレームワークが、異なる階層間でのKVブロックの移動を処理します。
これらのツールはストレージ層と連携し、AIモデルが必要とする正確なタイミングで適切なコンテキストがGPUメモリ(G1)またはホストメモリ(G2)にロードされることを保証します。NVIDIA DOCAフレームワークは、コンテキストキャッシュを主要リソースとして扱うKV通信層を提供することで、これをさらに支援します。
主要ストレージベンダーは既にこのアーキテクチャを採用しています。AIC、Cloudian、DDN、Dell Technologies、HPE、Hitachi Vantara、IBM、Nutanix、Pure Storage、Supermicro、VAST Data、WEKAなどの企業がBlueField-4搭載プラットフォームを開発中です。これらのソリューションは今年後半に提供開始が見込まれています。
エージェント型AIのスケーリングに向けたインフラの再定義
専用コンテキストメモリ層の採用は、キャパシティプランニングとデータセンター設計に影響を与えます。
- データの再分類:CIOはKVキャッシュを独自のデータタイプとして認識すべきである。これは「一時的だがレイテンシに敏感」であり、「耐久性がありコールドな」コンプライアンスデータとは異なる。G3.5層が前者を管理することで、耐久性のあるG4ストレージは長期ログやアーティファクトに集中できる。
- オーケストレーションの成熟度:成功はワークロードをインテリジェントに割り当てるソフトウェアに依存する。本システムはトポロジー認識型オーケストレーション(NVIDIA Grove経由)により、ジョブをキャッシュされたコンテキストの近くに配置し、ネットワーク間でのデータ移動を削減する。
- 電力密度:同一ラックスペースにより多くの実効容量を詰め込むことで、組織は既存施設の寿命を延長できる。ただしこれにより平方メートルあたりの演算密度が増加するため、冷却と電力分配の綿密な計画が不可欠となる。
エージェント型AIへの移行にはデータセンターの物理的再設計が不可欠である。計算処理と低速な永続ストレージを完全に分離する従来の手法は、膨大な記憶容量を持つエージェントのリアルタイム検索要件には不適である。
専用のコンテキスト層を導入することで、企業はモデルメモリの増大とGPU HBMコストを分離できる。このエージェント型AIアーキテクチャでは、複数のエージェントが低消費電力の大容量メモリプールを共有できるため、複雑なクエリ処理コストが削減され、高スループット推論のサポートによりスケーラビリティが向上する。
組織が次期インフラ投資を準備するにあたり、メモリ階層の効率性を評価することは、GPU自体の選択と同様に重要となる。
関連記事:2025年のAIチップ戦争:企業リーダーが学んだサプライチェーンの現実
業界リーダーからAIとビッグデータを学びたい方へ。アムステルダム、カリフォルニア、ロンドンで開催される「AI & Big Data Expo」をチェック。TechExの一環として開催されるこの包括的イベントは、他の主要技術イベントと同時開催されます。詳細はこちら。
AI NewsはTechForge Mediaが運営しています。その他の今後のエンタープライズ技術イベントやウェビナーはこちらからご覧ください。
関連記事
 Anthropic、ClaudeのAIコーディングツールを日本に拡大し、海外成長を促進
Anthropic、米国の主要な人工知能企業は、グローバルな展開を強化している。水曜日、同社は東京で「Code with Claude」と題された大規模な開発者向けイベントを開催し、約500人のソフトウェアエンジニアが集まった。この取り組みは、Claude AIツールおよび関連製品を日本市場に積極的に導入することを目的としており、自律的なコーディング機能による企業生産性の向上という中核的な利点を強調している。自動化されたコード生成への重点本イベントにおいて、Anthropicは複雑なプログラ
インドのソフトウェア大手が採用を縮小し、AI エージェントの拡大に伴い解雇はないと約束
人工知能が従来の労働集約型ビジネスモデルを再構築する中、インドを代表するソフトウェアアウトソーシング企業であるタタ・コンサルテーション・サービスズ(TCS)は、その戦略的対応を明らかにしました。火曜日の定時株主総会において、会長は人間と機械の協働に関するビジョンを提示し、AI時代における同社の workforce 戦略を明確にしました。人員整理は行わないが、採用は鈍化TCSの会長は、AI導入により人員整理を行う計画はないものの、全体的な採用ペースは鈍化すると明確に述べました。TCSは以前、1
中国はGaokam中にAIモデルをロックし、即時の宿題支援をブロックしている
2026年の大学入試(Gaokao)が間近に迫る中、試験期間中にAIツールの利用停止に関する噂がインターネット上で激しい議論を巻き起こしている。世間の懸念に応えるため、主要なAIプラットフォームおよび教育アプリは、完全な禁止ではなく、試験関連機能に対して対象を絞った「時間制限ロック」を実施する方針を明らかにした。これらのプラットフォームは、正確な時間ベースの制御メカニズムを採用している。公式の試験時間中には、写真による問題解決や問題分析などの機能が一時的に無効化される。しかし、日常の会話機能や
関連特集おすすめ
デザインとアート
 クリエイティブな実験に最適なAIスタイル転送ツール
2026年版 クリエイティブな実験に最適な、最新・最高評価のAIスタイル転送ツール!XIX.AIは、実地テストと厳格なランキングを通じて卓越した結果をもたらす、強力で画期的な「必試」ツールを厳選しました。これらのトップソリューションは、コンテンツ制作を加速させ、無限の創造的可能性を切り拓くことで、クリエイターの生産性を大幅に向上させます。 今すぐチェックして、あなたにぴったりのツールを見つけ、今日から創作を始めましょう!
 9 ツール
 xix.ai
漫画制作
ビジュアルストーリーテリングに最適なAI吹き出しツール
2026年版、ビジュアルストーリーテリングに最適な高評価AIダイアログバブルツールがXIX.AIに登場!この厳選コレクションには、クリエイターの生産性を高め、創作上のボトルネックを解消する、画期的な強力ツールが揃っています。 無料版と有料版の比較、実地テストの結果、最新のランキングを確認して、魅力的なビジュアルストーリーを構築するのに最適な、ぜひ試すべきソリューションを見つけましょう。今すぐチェックして、あなたにぴったりのツールを発見してください!
10 ツール
xix.ai
ミーティングアシスタント
AI会議要約ツールのトップ選定:決定事項とフォローアップを明確に把握
2026年版:意思決定の追跡を明確にし、フォローアップを容易にする、高評価のAI会議要約ツールベストセレクション。この厳選リストでは、会議メモの自動化、重要なアクション項目の特定、すべてのプロジェクトにわたるチーム連携の効率化を通じて、生産性を劇的に向上させる、強力で画期的なソリューションをご紹介します。 無料版と有料版の比較、実地テストの結果、毎週更新されるランキングを参考に、最適なツールを見つけてください。今すぐチェックして、AIの力を最大限に活用しましょう!
9 ツール
xix.ai
データ分析
最強のAIデータクリーニングツール:欠損値や重複データを迅速に修正
2026年最新かつ最も評価の高いAIデータクリーニングツールをご紹介。欠損値や重複データを迅速に修正できるこれらのツールは、生産性を大幅に向上させる強力なソリューションです。各ツールは信頼性を確保するため、厳格な実環境でのテストを経ています。無料版と有料版の比較情報もご用意しており、あなたのニーズに最も合ったツールを見つけ出せます。今すぐXIX.AIで詳細を確認し、AI活用の強みを最大限に引き出しましょう。
11 ツール
xix.ai
デザインとアート
アーティストのための最高のAIクリエイティブアイディエーションツール:ビジュアルブロックを打破する
2026年最新版・最高評価のAIクリエイティブ発想ツールは、XIX.AIによって厳選され、クリエイターが視覚的な壁を打破し、創造性を即座に高めることを支援します。これらの革新的なツールは、実際のテスト結果、無料版と有料版の詳細比較、そして週次更新されるランキングを提供しています。コンテンツ制作を加速し、AIによる優位性を解き放つための最適なツールを見つけてください。今すぐ探索しましょう!
14 ツール
xix.ai
作曲
TikTokのBGM、Reelsの音声、クリエイター向けプロモーション音楽向けのAIビートメーカー
2026年最新版!TikTokのBGM、Reelsの音声、クリエイター向けプロモーション音楽に最適なAIビートメーカー集!XIX.AIは、あらゆるコンテンツのニーズに応える完璧な音楽を提供するため、実地テストを経て選りすぐられた、画期的な高機能ツールのランキングを厳選しました。 無料版と有料版の詳細な比較データ、毎週更新されるランキング、そして創造性と生産性を高めるためにぜひ試すべきツールが満載です。今すぐチェックして、あなたにぴったりのツールを見つけましょう!
11 ツール
xix.ai

 コメント (0)
0/500
エージェント型AIは単純なチャットボットから複雑なワークフロー管理への重要な転換点であり、その拡張には記憶アーキテクチャへの新たなアプローチが求められる。
基盤モデルが数兆のパラメータに成長し、コンテキストウィンドウが数百万トークンに拡大するにつれ、履歴を保持するための計算コストが、それを効果的に処理する能力を上回りつつある。
これらのシステムを導入する組織は現在、膨大な量の「長期記憶」(技術的にはキーバリュー(KV)キャッシュ)が現行ハードウェア設計の能力を超えるボトルネックに直面している。
既存インフラでは選択肢が限られています:推論コンテキストを希少な高帯域GPUメモリ(HBM)に保存するか、低速な汎用ストレージに移すかです。前者は大規模コンテキストではコストがかかりすぎ、後者はリアルタイムのエージェント的相互作用を不可能にする遅延を発生させます。
この拡大するギャップはエージェント型AIのスケーリングを阻害しており、NVIDIAはRubinアーキテクチャ内に推論コンテキストメモリストレージ(ICMS)プラットフォームを導入。AIメモリの一時的かつ高速な要求に特化した新たなストレージ層を構築した。
「AIはコンピューティングスタック全体を変革しつつあり、今やストレージ領域にも及んでいる」と黄氏は述べた。「AIは単一応答型チャットボットを超え、物理世界を理解し、長期にわたる推論を行い、事実に基づき、実用的なタスクにツールを活用し、短期記憶と長期記憶の両方を維持する知的な協力者へと進化した」
中核的な運用課題は、トランスフォーマーベースモデルの動作原理に起因する。生成される新たな単語ごとに会話全体を再計算するのを防ぐため、モデルは過去の状態をKVキャッシュに保存する。エージェント型ワークフローでは、このキャッシュがツールやセッションを跨ぐ永続的メモリとして機能し、シーケンス長に比例して拡張する。
これにより独自のデータカテゴリーが生成される。財務記録や顧客ログとは異なり、KVキャッシュは派生データである。即時性能には不可欠だが、エンタープライズファイルシステムのような堅牢な耐久性保証を必要としない。汎用ストレージシステム(標準CPU上で動作)はメタデータ管理やレプリケーションにエネルギーを消費するが、エージェント型ワークロードはこれらの恩恵を受けない。
GPU HBM(G1)から共有ストレージ(G4)に至る既存の階層構造は、次第に非効率化が進んでいる:
コンテキストデータがGPU(G1)からシステムRAM(G2)、最終的に共有ストレージ(G4)へ移動するにつれ、効率は大幅に低下します。アクティブなコンテキストをG4層に転送するとミリ秒レベルの遅延が発生し、トークンあたりのエネルギーコストが上昇。データ待ちで高価なGPUがアイドル状態になります。
企業にとっては、インフラのオーバーヘッドに電力が消費され、アクティブな推論タスクに電力が使われないため、総所有コスト(TCO)の増加につながります。
AIファクトリー向け新メモリ階層
業界の解決策は、この階層にカスタム構築のレイヤーを追加することです。ICMSプラットフォームは「G3.5」層を創出します。これは大規模推論専用に設計されたイーサネット接続フラッシュストレージ層です。
この手法ではストレージをコンピューティングポッドに直接統合。NVIDIA BlueField-4データプロセッサを活用し、コンテキストデータ管理をホストCPUから移行させる。システムはポッドあたりペタバイト級の共有容量を提供し、エージェントが膨大な履歴を保持できるため、高価なHBMを消費せずにエージェント型AIのスケーリングを強化する。
運用上の利点はスループットとエネルギー使用量の両面で測定可能です。標準ストレージより高速でありながらHBMより低コストなこの中間層に関連コンテキストを保存することで、システムは事前にメモリをGPUへ「プリロード」できます。これによりGPUデコーダのアイドル時間が削減され、長コンテキストワークロードにおいて最大5倍のトークン毎秒処理能力(TPS)を実現します。
エネルギー効率の観点でも、同様に大きなメリットがあります。このアーキテクチャは汎用ストレージプロトコルのオーバーヘッドを排除するため、従来手法と比較して5倍の電力効率を実現します。
データプレーンの統合
このアーキテクチャの導入には、ITチームがストレージネットワークを捉える方法の転換が必要です。ICMSプラットフォームは、フラッシュストレージをローカルメモリのように扱うために必要な高帯域幅・低ジッター接続を実現するため、NVIDIA Spectrum-X Ethernetに依存しています。
エンタープライズインフラチームにとっての主要な統合ポイントはオーケストレーション層です。NVIDIA Dynamoや推論転送ライブラリ(NIXL)といったフレームワークが、異なる階層間でのKVブロックの移動を処理します。
これらのツールはストレージ層と連携し、AIモデルが必要とする正確なタイミングで適切なコンテキストがGPUメモリ(G1)またはホストメモリ(G2)にロードされることを保証します。NVIDIA DOCAフレームワークは、コンテキストキャッシュを主要リソースとして扱うKV通信層を提供することで、これをさらに支援します。
主要ストレージベンダーは既にこのアーキテクチャを採用しています。AIC、Cloudian、DDN、Dell Technologies、HPE、Hitachi Vantara、IBM、Nutanix、Pure Storage、Supermicro、VAST Data、WEKAなどの企業がBlueField-4搭載プラットフォームを開発中です。これらのソリューションは今年後半に提供開始が見込まれています。
エージェント型AIのスケーリングに向けたインフラの再定義
専用コンテキストメモリ層の採用は、キャパシティプランニングとデータセンター設計に影響を与えます。
- データの再分類:CIOはKVキャッシュを独自のデータタイプとして認識すべきである。これは「一時的だがレイテンシに敏感」であり、「耐久性がありコールドな」コンプライアンスデータとは異なる。G3.5層が前者を管理することで、耐久性のあるG4ストレージは長期ログやアーティファクトに集中できる。
- オーケストレーションの成熟度:成功はワークロードをインテリジェントに割り当てるソフトウェアに依存する。本システムはトポロジー認識型オーケストレーション(NVIDIA Grove経由)により、ジョブをキャッシュされたコンテキストの近くに配置し、ネットワーク間でのデータ移動を削減する。
- 電力密度:同一ラックスペースにより多くの実効容量を詰め込むことで、組織は既存施設の寿命を延長できる。ただしこれにより平方メートルあたりの演算密度が増加するため、冷却と電力分配の綿密な計画が不可欠となる。
エージェント型AIへの移行にはデータセンターの物理的再設計が不可欠である。計算処理と低速な永続ストレージを完全に分離する従来の手法は、膨大な記憶容量を持つエージェントのリアルタイム検索要件には不適である。
専用のコンテキスト層を導入することで、企業はモデルメモリの増大とGPU HBMコストを分離できる。このエージェント型AIアーキテクチャでは、複数のエージェントが低消費電力の大容量メモリプールを共有できるため、複雑なクエリ処理コストが削減され、高スループット推論のサポートによりスケーラビリティが向上する。
組織が次期インフラ投資を準備するにあたり、メモリ階層の効率性を評価することは、GPU自体の選択と同様に重要となる。
関連記事:2025年のAIチップ戦争:企業リーダーが学んだサプライチェーンの現実
業界リーダーからAIとビッグデータを学びたい方へ。アムステルダム、カリフォルニア、ロンドンで開催される「AI & Big Data Expo」をチェック。TechExの一環として開催されるこの包括的イベントは、他の主要技術イベントと同時開催されます。詳細はこちら。
AI NewsはTechForge Mediaが運営しています。その他の今後のエンタープライズ技術イベントやウェビナーはこちらからご覧ください。








 Anthropic、ClaudeのAIコーディングツールを日本に拡大し、海外成長を促進
Anthropic、米国の主要な人工知能企業は、グローバルな展開を強化している。水曜日、同社は東京で「Code with Claude」と題された大規模な開発者向けイベントを開催し、約500人のソフトウェアエンジニアが集まった。この取り組みは、Claude AIツールおよび関連製品を日本市場に積極的に導入することを目的としており、自律的なコーディング機能による企業生産性の向上という中核的な利点を強調している。自動化されたコード生成への重点本イベントにおいて、Anthropicは複雑なプログラ
 インドのソフトウェア大手が採用を縮小し、AI エージェントの拡大に伴い解雇はないと約束
人工知能が従来の労働集約型ビジネスモデルを再構築する中、インドを代表するソフトウェアアウトソーシング企業であるタタ・コンサルテーション・サービスズ(TCS)は、その戦略的対応を明らかにしました。火曜日の定時株主総会において、会長は人間と機械の協働に関するビジョンを提示し、AI時代における同社の workforce 戦略を明確にしました。人員整理は行わないが、採用は鈍化TCSの会長は、AI導入により人員整理を行う計画はないものの、全体的な採用ペースは鈍化すると明確に述べました。TCSは以前、1
 中国はGaokam中にAIモデルをロックし、即時の宿題支援をブロックしている
2026年の大学入試(Gaokao)が間近に迫る中、試験期間中にAIツールの利用停止に関する噂がインターネット上で激しい議論を巻き起こしている。世間の懸念に応えるため、主要なAIプラットフォームおよび教育アプリは、完全な禁止ではなく、試験関連機能に対して対象を絞った「時間制限ロック」を実施する方針を明らかにした。これらのプラットフォームは、正確な時間ベースの制御メカニズムを採用している。公式の試験時間中には、写真による問題解決や問題分析などの機能が一時的に無効化される。しかし、日常の会話機能や

2026年版 クリエイティブな実験に最適な、最新・最高評価のAIスタイル転送ツール!XIX.AIは、実地テストと厳格なランキングを通じて卓越した結果をもたらす、強力で画期的な「必試」ツールを厳選しました。これらのトップソリューションは、コンテンツ制作を加速させ、無限の創造的可能性を切り拓くことで、クリエイターの生産性を大幅に向上させます。 今すぐチェックして、あなたにぴったりのツールを見つけ、今日から創作を始めましょう!
9 ツール
xix.ai

2026年版、ビジュアルストーリーテリングに最適な高評価AIダイアログバブルツールがXIX.AIに登場!この厳選コレクションには、クリエイターの生産性を高め、創作上のボトルネックを解消する、画期的な強力ツールが揃っています。 無料版と有料版の比較、実地テストの結果、最新のランキングを確認して、魅力的なビジュアルストーリーを構築するのに最適な、ぜひ試すべきソリューションを見つけましょう。今すぐチェックして、あなたにぴったりのツールを発見してください!
10 ツール
xix.ai

2026年版:意思決定の追跡を明確にし、フォローアップを容易にする、高評価のAI会議要約ツールベストセレクション。この厳選リストでは、会議メモの自動化、重要なアクション項目の特定、すべてのプロジェクトにわたるチーム連携の効率化を通じて、生産性を劇的に向上させる、強力で画期的なソリューションをご紹介します。 無料版と有料版の比較、実地テストの結果、毎週更新されるランキングを参考に、最適なツールを見つけてください。今すぐチェックして、AIの力を最大限に活用しましょう!
9 ツール
xix.ai

2026年最新かつ最も評価の高いAIデータクリーニングツールをご紹介。欠損値や重複データを迅速に修正できるこれらのツールは、生産性を大幅に向上させる強力なソリューションです。各ツールは信頼性を確保するため、厳格な実環境でのテストを経ています。無料版と有料版の比較情報もご用意しており、あなたのニーズに最も合ったツールを見つけ出せます。今すぐXIX.AIで詳細を確認し、AI活用の強みを最大限に引き出しましょう。
11 ツール
xix.ai

2026年最新版・最高評価のAIクリエイティブ発想ツールは、XIX.AIによって厳選され、クリエイターが視覚的な壁を打破し、創造性を即座に高めることを支援します。これらの革新的なツールは、実際のテスト結果、無料版と有料版の詳細比較、そして週次更新されるランキングを提供しています。コンテンツ制作を加速し、AIによる優位性を解き放つための最適なツールを見つけてください。今すぐ探索しましょう!
14 ツール
xix.ai

2026年最新版!TikTokのBGM、Reelsの音声、クリエイター向けプロモーション音楽に最適なAIビートメーカー集!XIX.AIは、あらゆるコンテンツのニーズに応える完璧な音楽を提供するため、実地テストを経て選りすぐられた、画期的な高機能ツールのランキングを厳選しました。 無料版と有料版の詳細な比較データ、毎週更新されるランキング、そして創造性と生産性を高めるためにぜひ試すべきツールが満載です。今すぐチェックして、あなたにぴったりのツールを見つけましょう!
11 ツール
xix.ai












