


 Дом
Расширение агентного ИИ требует передовых систем памяти
Агентный ИИ знаменует собой значительный переход от простых чат-ботов к управлению сложными рабочими процессами, а его масштабирование требует нового подхода к архитектуре памяти.
По мере того как базовые модели растут до триллионов параметров, а контекстные окна расширяются до миллионов токенов, вычислительные затраты на сохранение истории превышают наши возможности по ее эффективной обработке.
Организации, внедряющие эти системы, сейчас сталкиваются с узким местом, когда огромный объем «долгосрочной памяти» (технически кэш Key-Value (KV)) превышает возможности современных аппаратных конструкций.
Существующая инфраструктура предлагает ограниченный выбор: хранить контекст вывода в ограниченной памяти GPU с высокой пропускной способностью (HBM) или переместить его в более медленное хранилище общего назначения. Первый вариант становится слишком дорогостоящим для больших контекстов, а второй вводит задержку, которая делает взаимодействие агентов в реальном времени непрактичным.
Чтобы преодолеть этот растущий разрыв, который мешает масштабированию агентного ИИ, NVIDIA запустила платформу Inference Context Memory Storage (ICMS) в рамках своей архитектуры Rubin, представив новый уровень хранения, созданный специально для временных высокоскоростных требований памяти ИИ.
«ИИ трансформирует весь вычислительный стек, а теперь и хранилище», — заявил Хуанг. «ИИ эволюционировал от чат-ботов с однократным ответом до интеллектуальных помощников, которые понимают физический мир, размышляют в течение длительных периодов времени, остаются основанными на фактах, используют инструменты для практических задач и сохраняют как краткосрочную, так и долгосрочную память».
Основная операционная проблема связана с тем, как функционируют модели на основе трансформаторов. Чтобы избежать пересчета всего разговора для каждого нового сгенерированного слова, модели сохраняют предыдущие состояния в кэше KV. В агентных рабочих процессах этот кэш служит постоянной памятью для всех инструментов и сеансов, расширяясь прямо пропорционально длине последовательности.
Это создает уникальную категорию данных. В отличие от финансовых отчетов или журналов клиентов, кэш KV является производными данными; он имеет решающее значение для немедленной производительности, но не требует надежных гарантий долговечности, характерных для корпоративных файловых систем. Системы хранения общего назначения, работающие на стандартных процессорах, потребляют энергию на управление метаданными и репликацию, от чего агентские рабочие нагрузки не получают никакой выгоды.
Существующая иерархия, от GPU HBM (G1) до общего хранилища (G4), становится все более неэффективной:
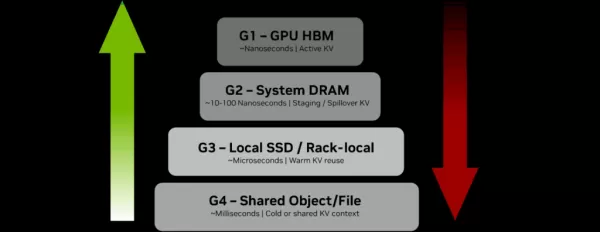
(Источник: NVIDIA) По мере перемещения контекстных данных из GPU (G1) в системную RAM (G2) и, наконец, в общее хранилище (G4), эффективность значительно снижается. Передача активного контекста на уровень G4 влечет за собой задержки на уровне миллисекунд и повышает энергозатраты на токен, в результате чего дорогостоящие GPU простаивают в ожидании данных.
Для предприятий это приводит к увеличению совокупной стоимости владения (TCO), поскольку энергия расходуется на накладные расходы инфраструктуры, а не на активные задачи логического вывода.
Новый уровень памяти для фабрики ИИ
Решение для отрасли заключается в добавлении в эту иерархию специально созданного уровня. Платформа ICMS создает уровень «G3.5» — подключенный по Ethernet уровень флэш-памяти, специально разработанный для крупномасштабного вывода.
Этот метод интегрирует хранилище непосредственно в вычислительный модуль. Используя процессор данных NVIDIA BlueField-4, платформа переносит управление этими контекстными данными с хост-процессора. Система предлагает петабайты общей емкости на каждый модуль, улучшая масштабируемость агентного ИИ, позволяя агентам хранить огромные объемы истории без использования дорогостоящей HBM.
Операционное преимущество измеримо как по пропускной способности, так и по энергопотреблению. Храня соответствующий контекст в этом промежуточном уровне, который быстрее стандартного хранилища, но более доступен по цене, чем HBM, система может заранее «предварительно загрузить» память обратно в GPU. Это сокращает время простоя декодера GPU, позволяя увеличить количество токенов в секунду (TPS) до 5 раз в рабочих нагрузках с длинным контекстом.
С точки зрения энергопотребления преимущества не менее значительны. Поскольку архитектура устраняет накладные расходы, связанные с протоколами хранения общего назначения, она обеспечивает в 5 раз более высокую энергоэффективность по сравнению с традиционными подходами.
Интеграция плоскости данных
Развертывание этой архитектуры требует изменения подхода ИТ-команд к сетевым хранилищам. Платформа ICMS использует Ethernet NVIDIA Spectrum-X для обеспечения высокой пропускной способности и низкого джиттера, необходимых для работы с флэш-хранилищем практически как с локальной памятью.
Для команд, отвечающих за инфраструктуру предприятия, ключевым моментом интеграции является уровень оркестрации. Такие фреймворки, как NVIDIA Dynamo и Inference Transfer Library (NIXL), обрабатывают перемещение блоков KV между разными уровнями.
Эти инструменты работают с уровнем хранения, чтобы обеспечить загрузку правильного контекста в память GPU (G1) или память хоста (G2) именно тогда, когда это необходимо модели ИИ. Фреймворк NVIDIA DOCA дополнительно поддерживает это, предоставляя уровень связи KV, который обрабатывает кэш контекста как основной ресурс.
Ведущие поставщики систем хранения уже внедряют эту архитектуру. Такие компании, как AIC, Cloudian, DDN, Dell Technologies, HPE, Hitachi Vantara, IBM, Nutanix, Pure Storage, Supermicro, VAST Data и WEKA, разрабатывают платформы с BlueField-4. Ожидается, что эти решения будут доступны во второй половине этого года.
Переосмысление инфраструктуры для масштабирования агентного ИИ
Применение специального уровня контекстной памяти влияет на планирование емкости и проектирование центров обработки данных.
- Переклассификация данных: ИТ-директора должны признать кэш KV отдельным типом данных. Он является «временным, но чувствительным к задержкам», в отличие от «долговечных и холодных» данных, подлежащих нормативному регулированию. Уровень G3.5 управляет первым типом данных, позволяя долговечному хранилищу G4 сосредоточиться на долгосрочных журналах и артефактах.
- Зрелость оркестрации: успех зависит от программного обеспечения, которое может интеллектуально распределять рабочие нагрузки. Система использует оркестрацию с учетом топологии (через NVIDIA Grove) для размещения заданий вблизи их кэшированного контекста, что сокращает перемещение данных по сети.
- Плотность мощности: разместив больше полезной емкости в том же пространстве стойки, организации могут продлить срок службы своих текущих объектов. Однако это увеличивает плотность вычислений на квадратный метр, что требует тщательного планирования охлаждения и распределения мощности.
Переход к агентному ИИ требует физической перепроектировки центра обработки данных. Распространенная практика полного отделения вычислений от медленного постоянного хранилища не подходит для требований агентов с обширной памятью к извлечению данных в реальном времени.
Внедрив специализированный контекстный уровень, компании могут отделить рост памяти модели от стоимости GPU HBM. Эта агентская архитектура ИИ позволяет нескольким агентам совместно использовать большой пул памяти с низким энергопотреблением, снижая стоимость обработки сложных запросов и улучшая масштабируемость за счет поддержки высокопроизводительного мышления.
По мере того как организации готовятся к следующему раунду инвестиций в инфраструктуру, оценка эффективности иерархии памяти будет столь же важна, как и выбор самого GPU.
См. также: Война AI-чипов 2025 года: что руководители предприятий узнали о реальности цепочки поставок
Хотите узнать больше об ИИ и больших данных от лидеров отрасли? Посетите выставку AI & Big Data Expo, которая пройдет в Амстердаме, Калифорнии и Лондоне. Это комплексное мероприятие является частью TechEx и проходит одновременно с другими ведущими технологическими мероприятиями. Нажмите здесь для получения дополнительной информации.
AI News поддерживается TechForge Media. Узнайте о других предстоящих мероприятиях и вебинарах по корпоративным технологиям здесь.
Связанная статья
 Индийский технологический магнат инвестирует $30 млн в ИИ-аналог Microsoft Office
Серийный предприниматель Бхавин Турахия инвестирует $30 млн собственных средств, делая ставку на то, что сектор корпоративного искусственного интеллекта всё ещё имеет место для новых игроков. Его последний стартап, Neo, основан на ключевой идее: уста
Бывший главный научный сотрудник OpenAI Илья представляет SSI и раскрывает первую модель
Искусственный интеллект достиг еще одной важной вехи. После своего ухода из OpenAI бывший главный научный сотрудник Илья Сутскер основал компанию Safe Superintelligence Inc. (SSI), которая недавно раскрыла детали своей первой модели. Сообщения в зару
Lovable Leads Atech's Seed Round as AI Ambient Coding Officially Enters the Hardware Field
14 мая 2026 года платформа разработки приложений на базе искусственного интеллекта Lovable объявила о своем участии в раундеSeed-финансирования на сумму $800 000 для датского стартапа в области аппаратного обеспечения Atech. При ведущем участии Lovab
Рекомендации по связанным специальным темам
чат-бот
 Лучшие инструменты для тренировки разговоров с помощью ИИ для подготовки к собеседованиям
2026 г. — новейшие, лучшие и наиболее высоко оцененные инструменты для тренировки разговорных навыков с помощью ИИ для подготовки к собеседованиям уже доступны на XIX.AI! Эта тщательно отобранная подборка включает мощные, революционные инструменты, прошедшие строгие реальные испытания и обеспечивающие точную обратную связь. Вы найдете сравнение бесплатных и платных вариантов, а также подробные рейтинги, которые помогут вам выбрать наиболее подходящий инструмент, повышающий вашу уверенность и навыки. Исследуйте сейчас, чтобы найти идеальный инструмент для успешного прохождения собеседований!
 12 инструментов
 xix.ai
Дизайн и искусство
Лучшие инструменты для переноса стилей с помощью ИИ для творческих экспериментов
2026: лучшие и самые популярные инструменты для переноса стиля с помощью ИИ для творческих экспериментов! XIX.AI подготовила подборку мощных, революционных инструментов, которые обязательно стоит попробовать: они демонстрируют исключительные результаты, подтвержденные реальными тестами и тщательным рейтингом. Эти ведущие решения помогают творческим людям значительно повысить продуктивность, ускоряя создание контента и открывая безграничные творческие возможности. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент и начать творить уже сегодня!
9 инструментов
xix.ai
Создание комиксов
Лучшие инструменты для создания диалоговых пузырей с помощью ИИ для визуального повествования
2026 года: самые новые и лучшие инструменты с ИИ для создания диалоговых пузырей в визуальном сторителлинге представлены на XIX.AI! В этой тщательно подобранной подборке представлены мощные, революционные инструменты, которые помогут творческим людям повысить продуктивность и преодолеть творческие кризисы. Ознакомьтесь со сравнением бесплатных и платных версий, посмотрите тесты в реальных условиях и изучите последние рейтинги, чтобы найти решения, которые обязательно стоит попробовать и которые идеально подходят для создания увлекательных визуальных историй. Исследуйте коллекцию прямо сейчас, чтобы найти свой идеальный инструмент!
10 инструментов
xix.ai
Помощник по встречам
Лучшие инструменты для составления отчетов о встречах с использованием ИИ: четкое отслеживание решений и последующих действий
2026: Последние версии лучших инструментов для составления отчетов о встречах с помощью ИИ, обеспечивающих четкое отслеживание решений и удобное выполнение последующих действий. В этом тщательно подобранном списке представлены мощные, революционные решения, которые значительно повышают продуктивность за счет автоматизации ведения протоколов встреч, выявления ключевых задач и оптимизации координации работы команды по всем проектам. Получите сравнение бесплатных и платных версий, а также результаты реальных тестов и еженедельно обновляемые рейтинги, которые помогут вам найти идеальный инструмент. Ознакомьтесь с ними прямо сейчас, чтобы раскрыть потенциал искусственного интеллекта!
9 инструментов
xix.ai
Анализ данных
Лучшие инструменты для очистки данных с использованием ИИ: быстрое устранение пропущенных значений и дубликатов
2026 год: лучшие и наиболее высоко оценённые инструменты для очистки данных с ИИ, предназначенные для быстрого устранения пропущенных значений и дубликатов. В этом тщательно отобранном списке представлены мощные решения, способные кардинально повысить производительность. Каждый инструмент прошёл строгие тестирования в реальных условиях для обеспечения надёжности. Получите бесплатное сравнение версий с платной и найдите инструмент, который наилучшим образом соответствует вашим потребностям. Ознакомьтесь с ним прямо сейчас на сайте XIX.AI, чтобы раскрыть полный потенциал работы с ИИ.
11 инструментов
xix.ai
Дизайн и искусство
Лучшие инструменты для творческого мышления на основе ИИ для художников: преодоление визуальных блоков
В 2026 году лучшие и наиболее популярные инструменты для творческого мышления с использованием ИИ для художников были отобраны XIX.AI, чтобы помочь создателям преодолеть визуальные блоки и мгновенно повысить креативность. Эти мощные инструменты, меняющие правила игры, предлагают реальные тесты, подробное сравнение бесплатных и платных версий, а также еженедельно обновляемые рейтинги. Найдите идеальный инструмент для ускорения создания контента и откройте свой ИИ-преимущество уже сегодня. Исследуйте сейчас!
14 инструментов
xix.ai

 Комментарии (0)
Агентный ИИ знаменует собой значительный переход от простых чат-ботов к управлению сложными рабочими процессами, а его масштабирование требует нового подхода к архитектуре памяти.
По мере того как базовые модели растут до триллионов параметров, а контекстные окна расширяются до миллионов токенов, вычислительные затраты на сохранение истории превышают наши возможности по ее эффективной обработке.
Организации, внедряющие эти системы, сейчас сталкиваются с узким местом, когда огромный объем «долгосрочной памяти» (технически кэш Key-Value (KV)) превышает возможности современных аппаратных конструкций.
Существующая инфраструктура предлагает ограниченный выбор: хранить контекст вывода в ограниченной памяти GPU с высокой пропускной способностью (HBM) или переместить его в более медленное хранилище общего назначения. Первый вариант становится слишком дорогостоящим для больших контекстов, а второй вводит задержку, которая делает взаимодействие агентов в реальном времени непрактичным.
Чтобы преодолеть этот растущий разрыв, который мешает масштабированию агентного ИИ, NVIDIA запустила платформу Inference Context Memory Storage (ICMS) в рамках своей архитектуры Rubin, представив новый уровень хранения, созданный специально для временных высокоскоростных требований памяти ИИ.
«ИИ трансформирует весь вычислительный стек, а теперь и хранилище», — заявил Хуанг. «ИИ эволюционировал от чат-ботов с однократным ответом до интеллектуальных помощников, которые понимают физический мир, размышляют в течение длительных периодов времени, остаются основанными на фактах, используют инструменты для практических задач и сохраняют как краткосрочную, так и долгосрочную память».
Основная операционная проблема связана с тем, как функционируют модели на основе трансформаторов. Чтобы избежать пересчета всего разговора для каждого нового сгенерированного слова, модели сохраняют предыдущие состояния в кэше KV. В агентных рабочих процессах этот кэш служит постоянной памятью для всех инструментов и сеансов, расширяясь прямо пропорционально длине последовательности.
Это создает уникальную категорию данных. В отличие от финансовых отчетов или журналов клиентов, кэш KV является производными данными; он имеет решающее значение для немедленной производительности, но не требует надежных гарантий долговечности, характерных для корпоративных файловых систем. Системы хранения общего назначения, работающие на стандартных процессорах, потребляют энергию на управление метаданными и репликацию, от чего агентские рабочие нагрузки не получают никакой выгоды.
Существующая иерархия, от GPU HBM (G1) до общего хранилища (G4), становится все более неэффективной:
По мере перемещения контекстных данных из GPU (G1) в системную RAM (G2) и, наконец, в общее хранилище (G4), эффективность значительно снижается. Передача активного контекста на уровень G4 влечет за собой задержки на уровне миллисекунд и повышает энергозатраты на токен, в результате чего дорогостоящие GPU простаивают в ожидании данных.
Для предприятий это приводит к увеличению совокупной стоимости владения (TCO), поскольку энергия расходуется на накладные расходы инфраструктуры, а не на активные задачи логического вывода.
Новый уровень памяти для фабрики ИИ
Решение для отрасли заключается в добавлении в эту иерархию специально созданного уровня. Платформа ICMS создает уровень «G3.5» — подключенный по Ethernet уровень флэш-памяти, специально разработанный для крупномасштабного вывода.
Этот метод интегрирует хранилище непосредственно в вычислительный модуль. Используя процессор данных NVIDIA BlueField-4, платформа переносит управление этими контекстными данными с хост-процессора. Система предлагает петабайты общей емкости на каждый модуль, улучшая масштабируемость агентного ИИ, позволяя агентам хранить огромные объемы истории без использования дорогостоящей HBM.
Операционное преимущество измеримо как по пропускной способности, так и по энергопотреблению. Храня соответствующий контекст в этом промежуточном уровне, который быстрее стандартного хранилища, но более доступен по цене, чем HBM, система может заранее «предварительно загрузить» память обратно в GPU. Это сокращает время простоя декодера GPU, позволяя увеличить количество токенов в секунду (TPS) до 5 раз в рабочих нагрузках с длинным контекстом.
С точки зрения энергопотребления преимущества не менее значительны. Поскольку архитектура устраняет накладные расходы, связанные с протоколами хранения общего назначения, она обеспечивает в 5 раз более высокую энергоэффективность по сравнению с традиционными подходами.
Интеграция плоскости данных
Развертывание этой архитектуры требует изменения подхода ИТ-команд к сетевым хранилищам. Платформа ICMS использует Ethernet NVIDIA Spectrum-X для обеспечения высокой пропускной способности и низкого джиттера, необходимых для работы с флэш-хранилищем практически как с локальной памятью.
Для команд, отвечающих за инфраструктуру предприятия, ключевым моментом интеграции является уровень оркестрации. Такие фреймворки, как NVIDIA Dynamo и Inference Transfer Library (NIXL), обрабатывают перемещение блоков KV между разными уровнями.
Эти инструменты работают с уровнем хранения, чтобы обеспечить загрузку правильного контекста в память GPU (G1) или память хоста (G2) именно тогда, когда это необходимо модели ИИ. Фреймворк NVIDIA DOCA дополнительно поддерживает это, предоставляя уровень связи KV, который обрабатывает кэш контекста как основной ресурс.
Ведущие поставщики систем хранения уже внедряют эту архитектуру. Такие компании, как AIC, Cloudian, DDN, Dell Technologies, HPE, Hitachi Vantara, IBM, Nutanix, Pure Storage, Supermicro, VAST Data и WEKA, разрабатывают платформы с BlueField-4. Ожидается, что эти решения будут доступны во второй половине этого года.
Переосмысление инфраструктуры для масштабирования агентного ИИ
Применение специального уровня контекстной памяти влияет на планирование емкости и проектирование центров обработки данных.
- Переклассификация данных: ИТ-директора должны признать кэш KV отдельным типом данных. Он является «временным, но чувствительным к задержкам», в отличие от «долговечных и холодных» данных, подлежащих нормативному регулированию. Уровень G3.5 управляет первым типом данных, позволяя долговечному хранилищу G4 сосредоточиться на долгосрочных журналах и артефактах.
- Зрелость оркестрации: успех зависит от программного обеспечения, которое может интеллектуально распределять рабочие нагрузки. Система использует оркестрацию с учетом топологии (через NVIDIA Grove) для размещения заданий вблизи их кэшированного контекста, что сокращает перемещение данных по сети.
- Плотность мощности: разместив больше полезной емкости в том же пространстве стойки, организации могут продлить срок службы своих текущих объектов. Однако это увеличивает плотность вычислений на квадратный метр, что требует тщательного планирования охлаждения и распределения мощности.
Переход к агентному ИИ требует физической перепроектировки центра обработки данных. Распространенная практика полного отделения вычислений от медленного постоянного хранилища не подходит для требований агентов с обширной памятью к извлечению данных в реальном времени.
Внедрив специализированный контекстный уровень, компании могут отделить рост памяти модели от стоимости GPU HBM. Эта агентская архитектура ИИ позволяет нескольким агентам совместно использовать большой пул памяти с низким энергопотреблением, снижая стоимость обработки сложных запросов и улучшая масштабируемость за счет поддержки высокопроизводительного мышления.
По мере того как организации готовятся к следующему раунду инвестиций в инфраструктуру, оценка эффективности иерархии памяти будет столь же важна, как и выбор самого GPU.
См. также: Война AI-чипов 2025 года: что руководители предприятий узнали о реальности цепочки поставок
Хотите узнать больше об ИИ и больших данных от лидеров отрасли? Посетите выставку AI & Big Data Expo, которая пройдет в Амстердаме, Калифорнии и Лондоне. Это комплексное мероприятие является частью TechEx и проходит одновременно с другими ведущими технологическими мероприятиями. Нажмите здесь для получения дополнительной информации.
AI News поддерживается TechForge Media. Узнайте о других предстоящих мероприятиях и вебинарах по корпоративным технологиям здесь.








 Индийский технологический магнат инвестирует $30 млн в ИИ-аналог Microsoft Office
Серийный предприниматель Бхавин Турахия инвестирует $30 млн собственных средств, делая ставку на то, что сектор корпоративного искусственного интеллекта всё ещё имеет место для новых игроков. Его последний стартап, Neo, основан на ключевой идее: уста
 Бывший главный научный сотрудник OpenAI Илья представляет SSI и раскрывает первую модель
Искусственный интеллект достиг еще одной важной вехи. После своего ухода из OpenAI бывший главный научный сотрудник Илья Сутскер основал компанию Safe Superintelligence Inc. (SSI), которая недавно раскрыла детали своей первой модели. Сообщения в зару
 Lovable Leads Atech's Seed Round as AI Ambient Coding Officially Enters the Hardware Field
14 мая 2026 года платформа разработки приложений на базе искусственного интеллекта Lovable объявила о своем участии в раундеSeed-финансирования на сумму $800 000 для датского стартапа в области аппаратного обеспечения Atech. При ведущем участии Lovab

2026 г. — новейшие, лучшие и наиболее высоко оцененные инструменты для тренировки разговорных навыков с помощью ИИ для подготовки к собеседованиям уже доступны на XIX.AI! Эта тщательно отобранная подборка включает мощные, революционные инструменты, прошедшие строгие реальные испытания и обеспечивающие точную обратную связь. Вы найдете сравнение бесплатных и платных вариантов, а также подробные рейтинги, которые помогут вам выбрать наиболее подходящий инструмент, повышающий вашу уверенность и навыки. Исследуйте сейчас, чтобы найти идеальный инструмент для успешного прохождения собеседований!
12 инструментов
xix.ai

2026: лучшие и самые популярные инструменты для переноса стиля с помощью ИИ для творческих экспериментов! XIX.AI подготовила подборку мощных, революционных инструментов, которые обязательно стоит попробовать: они демонстрируют исключительные результаты, подтвержденные реальными тестами и тщательным рейтингом. Эти ведущие решения помогают творческим людям значительно повысить продуктивность, ускоряя создание контента и открывая безграничные творческие возможности. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент и начать творить уже сегодня!
9 инструментов
xix.ai

2026 года: самые новые и лучшие инструменты с ИИ для создания диалоговых пузырей в визуальном сторителлинге представлены на XIX.AI! В этой тщательно подобранной подборке представлены мощные, революционные инструменты, которые помогут творческим людям повысить продуктивность и преодолеть творческие кризисы. Ознакомьтесь со сравнением бесплатных и платных версий, посмотрите тесты в реальных условиях и изучите последние рейтинги, чтобы найти решения, которые обязательно стоит попробовать и которые идеально подходят для создания увлекательных визуальных историй. Исследуйте коллекцию прямо сейчас, чтобы найти свой идеальный инструмент!
10 инструментов
xix.ai

2026: Последние версии лучших инструментов для составления отчетов о встречах с помощью ИИ, обеспечивающих четкое отслеживание решений и удобное выполнение последующих действий. В этом тщательно подобранном списке представлены мощные, революционные решения, которые значительно повышают продуктивность за счет автоматизации ведения протоколов встреч, выявления ключевых задач и оптимизации координации работы команды по всем проектам. Получите сравнение бесплатных и платных версий, а также результаты реальных тестов и еженедельно обновляемые рейтинги, которые помогут вам найти идеальный инструмент. Ознакомьтесь с ними прямо сейчас, чтобы раскрыть потенциал искусственного интеллекта!
9 инструментов
xix.ai

2026 год: лучшие и наиболее высоко оценённые инструменты для очистки данных с ИИ, предназначенные для быстрого устранения пропущенных значений и дубликатов. В этом тщательно отобранном списке представлены мощные решения, способные кардинально повысить производительность. Каждый инструмент прошёл строгие тестирования в реальных условиях для обеспечения надёжности. Получите бесплатное сравнение версий с платной и найдите инструмент, который наилучшим образом соответствует вашим потребностям. Ознакомьтесь с ним прямо сейчас на сайте XIX.AI, чтобы раскрыть полный потенциал работы с ИИ.
11 инструментов
xix.ai

В 2026 году лучшие и наиболее популярные инструменты для творческого мышления с использованием ИИ для художников были отобраны XIX.AI, чтобы помочь создателям преодолеть визуальные блоки и мгновенно повысить креативность. Эти мощные инструменты, меняющие правила игры, предлагают реальные тесты, подробное сравнение бесплатных и платных версий, а также еженедельно обновляемые рейтинги. Найдите идеальный инструмент для ускорения создания контента и откройте свой ИИ-преимущество уже сегодня. Исследуйте сейчас!
14 инструментов
xix.ai












