
option
Maison
Flash info
Contenu
RogerMartinez
RogerMartinez
6 février 2026

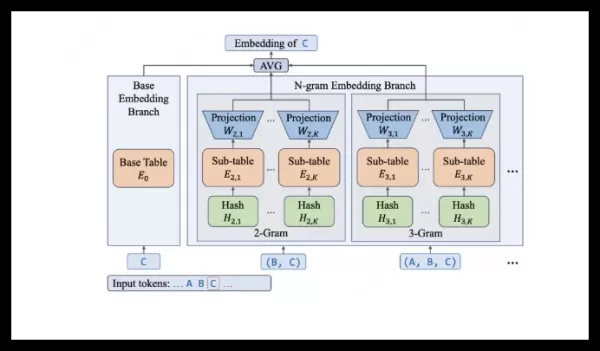
L'équipe LongCat de Meituan a présenté LongCat-Flash-Lite, un modèle linguistique utilisant une nouvelle approche d'expansion d'intégration au lieu de la mise à l'échelle des experts. Avec un total de 68,5 milliards de paramètres, il n'active que 2,9 à 4,5 milliards par inférence grâce à une couche d'intégration N-gram efficace. Les optimisations du système permettent d'atteindre des vitesses de 500 à 700 tokens/s. Il est en tête des benchmarks d'agents et de codage tels que SWE-Bench (54,4 %) et obtient un score de 85,52 sur MMLU. Le modèle est désormais entièrement open source.
L'équipe LongCat de Meituan a présenté LongCat-Flash-Lite, un modèle linguistique utilisant une nouvelle approche d'expansion d'intégration au lieu de la mise à l'échelle des experts. Avec un total de 68,5 milliards de paramètres, il n'active que 2,9 à 4,5 milliards par inférence grâce à une couche d'intégration N-gram efficace. Les optimisations du système permettent d'atteindre des vitesses de 500 à 700 tokens/s. Il est en tête des benchmarks d'agents et de codage tels que SWE-Bench (54,4 %) et obtient un score de 85,52 sur MMLU. Le modèle est désormais entièrement open source. L'équipe LongCat de Meituan a présenté LongCat-Flash-Lite, un modèle linguistique utilisant une nouvelle approche d'expansion d'intégration au lieu de la mise à l'échelle des experts. Avec un total de 68,5 milliards de paramètres, il n'active que 2,9 à 4,5 milliards par inférence grâce à une couche d'intégration N-gram efficace. Les optimisations du système permettent d'atteindre des vitesses de 500 à 700 tokens/s. Il est en tête des benchmarks d'agents et de codage tels que SWE-Bench (54,4 %) et obtient un score de 85,52 sur MMLU. Le modèle est désormais entièrement open source.
commentaires (0)
0/300
OR