
Option
Heim
Eilmeldung
Inhalt
RogerMartinez
RogerMartinez
6. Februar 2026

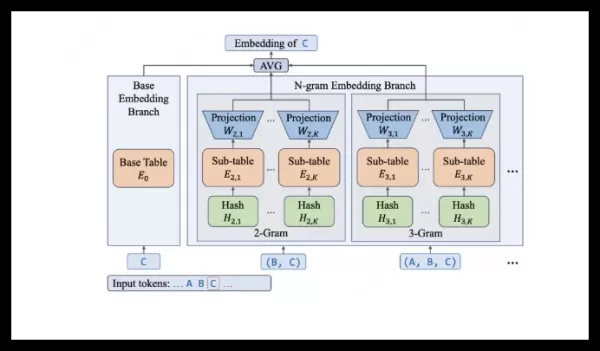
Das LongCat-Team von Meituan stellte LongCat-Flash-Lite vor, ein Sprachmodell, das anstelle von Skalierungsexperten einen neuartigen Ansatz zur Einbettungserweiterung verwendet. Mit insgesamt 68,5 Milliarden Parametern aktiviert es über eine effiziente N-Gram-Einbettungsschicht nur 2,9 bis 4,5 Milliarden pro Inferenz. Systemoptimierungen ermöglichen Geschwindigkeiten von 500 bis 700 Tokens/s. Es ist führend in Agenten- und Codierungs-Benchmarks wie SWE-Bench (54,4 %) und erreicht 85,52 Punkte bei MMLU. Das Modell ist nun vollständig Open Source.
Das LongCat-Team von Meituan stellte LongCat-Flash-Lite vor, ein Sprachmodell, das anstelle von Skalierungsexperten einen neuartigen Ansatz zur Einbettungserweiterung verwendet. Mit insgesamt 68,5 Milliarden Parametern aktiviert es über eine effiziente N-Gram-Einbettungsschicht nur 2,9 bis 4,5 Milliarden pro Inferenz. Systemoptimierungen ermöglichen Geschwindigkeiten von 500 bis 700 Tokens/s. Es ist führend in Agenten- und Codierungs-Benchmarks wie SWE-Bench (54,4 %) und erreicht 85,52 Punkte bei MMLU. Das Modell ist nun vollständig Open Source. Das LongCat-Team von Meituan stellte LongCat-Flash-Lite vor, ein Sprachmodell, das anstelle von Skalierungsexperten einen neuartigen Ansatz zur Einbettungserweiterung verwendet. Mit insgesamt 68,5 Milliarden Parametern aktiviert es über eine effiziente N-Gram-Einbettungsschicht nur 2,9 bis 4,5 Milliarden pro Inferenz. Systemoptimierungen ermöglichen Geschwindigkeiten von 500 bis 700 Tokens/s. Es ist führend in Agenten- und Codierungs-Benchmarks wie SWE-Bench (54,4 %) und erreicht 85,52 Punkte bei MMLU. Das Modell ist nun vollständig Open Source.
Kommentare (0)
0/300
OR