
opción
Hogar
Última hora
Contenido
RogerMartinez
RogerMartinez
6 de febrero de 2026

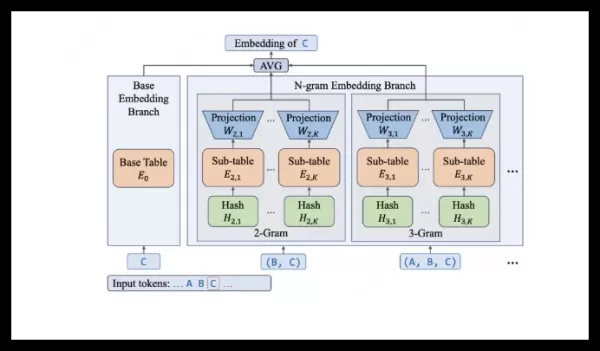
El equipo LongCat de Meituan presentó LongCat-Flash-Lite, un modelo lingüístico que utiliza un novedoso enfoque de expansión de incrustación en lugar de escalar expertos. Con un total de 68 500 millones de parámetros, solo activa entre 2900 y 4500 millones por inferencia a través de una eficiente capa de incrustación N-gram. Las optimizaciones del sistema permiten velocidades de 500-700 tokens/s. Lidera los benchmarks de agentes y codificación como SWE-Bench (54,4 %) y obtiene una puntuación de 85,52 en MMLU. El modelo es ahora totalmente de código abierto.
El equipo LongCat de Meituan presentó LongCat-Flash-Lite, un modelo lingüístico que utiliza un novedoso enfoque de expansión de incrustación en lugar de escalar expertos. Con un total de 68 500 millones de parámetros, solo activa entre 2900 y 4500 millones por inferencia a través de una eficiente capa de incrustación N-gram. Las optimizaciones del sistema permiten velocidades de 500-700 tokens/s. Lidera los benchmarks de agentes y codificación como SWE-Bench (54,4 %) y obtiene una puntuación de 85,52 en MMLU. El modelo es ahora totalmente de código abierto. El equipo LongCat de Meituan presentó LongCat-Flash-Lite, un modelo lingüístico que utiliza un novedoso enfoque de expansión de incrustación en lugar de escalar expertos. Con un total de 68 500 millones de parámetros, solo activa entre 2900 y 4500 millones por inferencia a través de una eficiente capa de incrustación N-gram. Las optimizaciones del sistema permiten velocidades de 500-700 tokens/s. Lidera los benchmarks de agentes y codificación como SWE-Bench (54,4 %) y obtiene una puntuación de 85,52 en MMLU. El modelo es ahora totalmente de código abierto.
comentario (0)
0/300
OR