


 Heim
MiniMax-Großmodell spricht Namen falsch aus – Xiyu Technology: Unzureichendes Training nach bestimmten Token
MiniMax hat kürzlich einen technischen Bericht veröffentlicht, der detailliert erläutert, warum seine M2-Modellserie Schwierigkeiten hatte, spezifische Namen wie „Ma Jiaqi“ korrekt zu generieren. Dieser scheinbare Fehler hebt einen systemischen Mangel im aktuellen Training großer Sprachmodelle hervor.
Token-Offset: Der gestauchte Vektorraum
Die Ursache liegt im Tokenizer, der Grundeinheit der Textverarbeitung. Der Name „Ma Jiaqi“ wird beispielsweise in zwei Tokens aufgeteilt: „Ma“ und „Jiaqi“. Obwohl das Modell diese während der Vorabtrainierungsphase erlernte, traten Probleme in der anschließenden Phase des instruktionsspezifischen Feintunings auf.
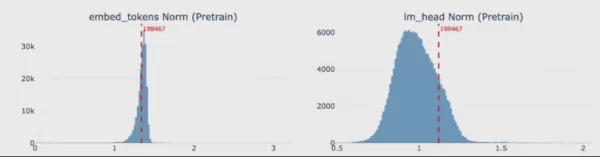
Während des Feintunings trat das Token „Jiaqi“ in den Dialogdaten so selten auf, dass es fast kein Training erhielt. Gleichzeitig wurden hochfrequente Tokens wie Code-Symbole und Tool-Aufrufe stark verstärkt, was den Repräsentationsraum für niedrigfrequente Tokens effektiv „stauchte“. Folglich drifteten diese Tokens von ihren korrekten Wahrscheinlichkeitsverteilungen ab, wodurch das Modell sie bei der Referenzierung bestimmter Prominenter durch phonetisch ähnliche Alternativen wie „Jiaqi“ oder „Qiqi“ ersetzte.
Über Chinesisch hinaus: Kettenreaktion aus Japanisch und Russisch
MiniMaxs Analyse ergab, dass diese „Token-Degradation“ weit verbreitet ist. Bei der Durchsuchung von etwa 200.000 Tokens des gesamten Vokabulars stellten sie fest, dass etwa 4,9 % einen signifikanten Leistungsabfall aufwiesen. Besonders betroffen waren japanische Tokens mit einer Degradationsrate von bis zu 29,7 %, was erklärt, warum das Modell gelegentlich russische oder koreanische Zeichen in japanische Gespräche mischt.
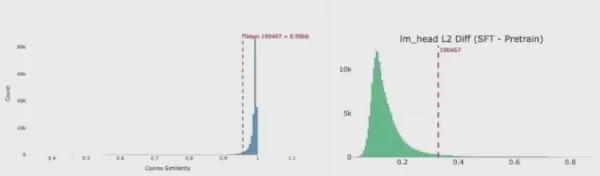
Neben Namen und Fremdsprachen sind von den betroffenen Tokens auch LaTeX-Markierungen, Wikipedia-Quellcodesymbole und sogar bestimmte SEO-Spam-Schlüsselwörter betroffen. Dies zeigt, dass Datensparsamkeit globale Auswirkungen hat: Wenn Trainingsdaten nach dem Training keine einheitliche Abdeckung für verschiedene Sprachen und spezifische Vokabulare bieten, wird die Generierungslogik des Modells verzerrt.
Systematische Reparatur: Etablierung einer „Mindestgarantie“ für 200.000 Tokens
Um dieses strukturelle Problem zu beheben, implementierte das F&E-Team eine präzise Reparaturstrategie. Sie generierten synthetische Daten, die das gesamte Vokabular abdeckten, und zwangen das Modell, „Wiederholungs“-Aufgaben auszuführen, wodurch sie eine „Mindestgarantie“ für die Generierungshäufigkeit jedes Tokens etablierten.
Die Daten nach der Reparatur zeigen deutliche Verbesserungen in der Stabilität der Ausgabe des gesamten Vokabulars des Modells. Die Rate japanischer Antworten, die fremdsprachige Zeichen enthielten, sank von 47 % auf nur noch 1 %. Das Team erforscht weiterhin tiefgreifende Optimierungen, wie etwa die Integration von Vorabtrainingsmaterialien in die Feintuning-Phase oder das direkte Entfernen redundanter Markierungen, die im Vokabular nicht mehr verwendet werden.
Dieser Vorfall hat erhebliche Reflexionen in der Branche ausgelöst: Während Tokenizer großer Modelle oft auf breiten Webkorpora aufgebaut sind, unterscheiden sich die Anwendungen im Downstream-Bereich stark. Die Sicherstellung einer ausreichenden Datenabdeckung auf Token-Ebene aus einer grundlegenden statistischen Perspektive bei gleichzeitiger Wahrung der semantischen Vielfalt bleibt eine kritische Herausforderung für die Verbesserung der Zuverlässigkeit großer Modelle.
Verwandter Artikel
 AliVideo stellt Wan3.0 vor und liefert ultra-lange Video-Generierung sowie multidimensionale Konsistenz
Am 24. August stellte Alibaba Wan3.0 vor, sein neuestes großes Video-Generierungsmodell. Diese Veröffentlichung stellt einen bedeutenden Fortschritt in Alibabas Videotechnologie dar und bietet erhebliche Verbesserungen in Bezug auf Dauer, universelle
Das Nvidia-H200-Geschäft in China übersteht den Trump-Xi-Gipfel, jedoch nicht wie erwartet.
Präsident Trump reiste nach Peking, wobei Jensen Huang in letzter Minute der Delegation beitrat und zwei Tage später mit vagen Äußerungen zu möglichen Entwicklungen bei Chipexporten abreiste. Es kam zu keinem Deal. Seit Trump im Dezember 2025 den Ver
Wie behebt man Core Web Vitals für die SEO-Ranking?
Das Erstellen visuell ansprechender Assets ist in der Spieleentwicklung von entscheidender Bedeutung. Pixel-Art, mit ihrer charmanten Retro-Ästhetik, bleibt eine beliebte Wahl. Mit dem Aufkommen von KI-Tools ist die Erstellung von Pixel-Art zugänglic
Empfehlungen zu verwandten Spezialthemen
Design & Kunst
 Die besten KI-Illustrationstools: Redaktionelle Szenen und Cover-Grafiken schneller erstellen
Die besten und am besten bewerteten KI-Illustrationstools 2026: Unsere sorgfältig zusammengestellte Liste enthält die leistungsstärksten Tools, mit denen Sie im Handumdrehen atemberaubende redaktionelle Szenen und auffällige Cover-Grafiken erstellen können. Jede Option wurde strengen Praxistests unterzogen und wird im Vergleich zwischen kostenlosen und kostenpflichtigen Versionen vorgestellt, damit Sie die perfekte Lösung für Ihren Arbeitsablauf finden können. Probieren Sie diese unverzichtbaren Lösungen noch heute aus, um Ihren KI-Vorteil zu nutzen und Ihre kreative Produktivität zu steigern. Entdecken Sie sie jetzt auf XIX.AI.
 10 Tools
 xix.ai
Bildung und Lernen
Die besten KI-Nachhilfelehrer für die Prüfungsvorbereitung: Üben Sie Mathematik, Naturwissenschaften und Englisch
Die besten und am besten bewerteten KI-Nachhilfetools für die Prüfungsvorbereitung des Jahres 2026 finden Sie hier auf XIX.AI! Unsere sorgfältig zusammengestellte Liste enthält leistungsstarke, bahnbrechende Tools, die einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, Tests aus der Praxis sowie wöchentlich aktualisierte Rankings bieten. Sie helfen Ihnen dabei, Ihre Schreibeffizienz zu steigern, das Erlernen komplexer Themen zu vereinfachen und Ihr akademisches Potenzial voll auszuschöpfen. Entdecken Sie jetzt Ihr perfektes Tool zur Prüfungsvorbereitung und legen Sie noch heute los, um Ihren KI-Vorteil zu nutzen!
10 Tools
xix.ai
Finanzen
KI-Budgetplanungstools für das persönliche Geldmanagement
2026 Neueste Besten Top-Bewertete KI-Budgetplanungs-Tools für persönliches Geldmanagement sind hier auf XIX.AI! Diese kuratierte Sammlung bietet leistungsstarke, revolutionäre Lösungen, die Ihnen helfen, reale Tests durchzuführen, Ausgaben Gewohnheiten zu verstehen und personalisierte Pläne zu erstellen, um die Produktivität zu steigern. Genießen Sie einen kostenlosen vs. bezahlten Vergleich sowie detaillierte Rankings. Unbedingt auszuprobierende Tools, die darauf ausgelegt sind, das Geldmanagement zu vereinfachen und Ihre KI-Vorteile freizuschalten. Entdecken Sie jetzt!
11 Tools
xix.ai
Gesundheit Wellness
KI-gestützte Schlafüberwachungsassistenten: Verbessern Sie Ihre Erholung durch bessere Gewohnheiten vor dem Schlafengehen
2026 – Die neuesten, besten und am höchsten bewerteten AI-Geräte zur Schlafüberwachung, sorgfältig ausgewählt für eine optimale Erholung. Dieser vollständig aktualisierte wöchentliche Leitfaden präsentiert leistungsstarke Tools mit praktischen Tests, einem Vergleich von kostenlosen und kostenpflichtigen Optionen sowie detaillierten Ranglisten, um Ihnen die beste Lösung zu zeigen, die die Schlafqualität verbessert und bessere Gewohnheiten zum Zubettgehen fördert. Entdecken Sie ihn jetzt auf XIX.AI, um Ihren Vorteil durch KI zu nutzen.
10 Tools
xix.ai
Datenanalyse
KI-gestützte SQL-Copilots für Produkt- und Umsatzanalysen
Die besten und am besten bewerteten KI-SQL-Copilots für Produkt- und Umsatzanalysen im Jahr 2026! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die anhand wöchentlich aktualisierter Rankings in der Praxis getestet werden. Diese Tools helfen Anwendern dabei, ihre Produktivität erheblich zu steigern, indem sie die Datenanalyse beschleunigen, komplexe Abfragen optimieren und präzise Erkenntnisse liefern, um intelligentere Geschäftsentscheidungen zu ermöglichen. Entdecken Sie jetzt das perfekte Tool, um Ihren KI-Vorteil voll auszuschöpfen!
14 Tools
xix.ai
Bildung und Lernen
Die besten KI-Hausaufgabenhelfer, die wirklich etwas vermitteln: Lerne Konzepte, nicht nur Antworten
2026: Die aktuell besten und am besten bewerteten KI-Hausaufgabenhelfer, die nicht nur Antworten liefern, sondern auch Kernkonzepte vermitteln – leistungsstarke Tools für Schüler und Studenten. Eine kuratierte Liste, die Sie unbedingt ausprobieren sollten. Wöchentlich aktualisiert. Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten. Praxistests. Genaue Rankings, die Ihnen helfen, Ihr volles Lernpotenzial auszuschöpfen. Entdecken Sie jetzt das perfekte Tool für intelligenteres Lernen.
10 Tools
xix.ai

 Kommentare (0)
MiniMax hat kürzlich einen technischen Bericht veröffentlicht, der detailliert erläutert, warum seine M2-Modellserie Schwierigkeiten hatte, spezifische Namen wie „Ma Jiaqi“ korrekt zu generieren. Dieser scheinbare Fehler hebt einen systemischen Mangel im aktuellen Training großer Sprachmodelle hervor.
Token-Offset: Der gestauchte Vektorraum
Die Ursache liegt im Tokenizer, der Grundeinheit der Textverarbeitung. Der Name „Ma Jiaqi“ wird beispielsweise in zwei Tokens aufgeteilt: „Ma“ und „Jiaqi“. Obwohl das Modell diese während der Vorabtrainierungsphase erlernte, traten Probleme in der anschließenden Phase des instruktionsspezifischen Feintunings auf.
Während des Feintunings trat das Token „Jiaqi“ in den Dialogdaten so selten auf, dass es fast kein Training erhielt. Gleichzeitig wurden hochfrequente Tokens wie Code-Symbole und Tool-Aufrufe stark verstärkt, was den Repräsentationsraum für niedrigfrequente Tokens effektiv „stauchte“. Folglich drifteten diese Tokens von ihren korrekten Wahrscheinlichkeitsverteilungen ab, wodurch das Modell sie bei der Referenzierung bestimmter Prominenter durch phonetisch ähnliche Alternativen wie „Jiaqi“ oder „Qiqi“ ersetzte.
Über Chinesisch hinaus: Kettenreaktion aus Japanisch und Russisch
MiniMaxs Analyse ergab, dass diese „Token-Degradation“ weit verbreitet ist. Bei der Durchsuchung von etwa 200.000 Tokens des gesamten Vokabulars stellten sie fest, dass etwa 4,9 % einen signifikanten Leistungsabfall aufwiesen. Besonders betroffen waren japanische Tokens mit einer Degradationsrate von bis zu 29,7 %, was erklärt, warum das Modell gelegentlich russische oder koreanische Zeichen in japanische Gespräche mischt.
Neben Namen und Fremdsprachen sind von den betroffenen Tokens auch LaTeX-Markierungen, Wikipedia-Quellcodesymbole und sogar bestimmte SEO-Spam-Schlüsselwörter betroffen. Dies zeigt, dass Datensparsamkeit globale Auswirkungen hat: Wenn Trainingsdaten nach dem Training keine einheitliche Abdeckung für verschiedene Sprachen und spezifische Vokabulare bieten, wird die Generierungslogik des Modells verzerrt.
Systematische Reparatur: Etablierung einer „Mindestgarantie“ für 200.000 Tokens
Um dieses strukturelle Problem zu beheben, implementierte das F&E-Team eine präzise Reparaturstrategie. Sie generierten synthetische Daten, die das gesamte Vokabular abdeckten, und zwangen das Modell, „Wiederholungs“-Aufgaben auszuführen, wodurch sie eine „Mindestgarantie“ für die Generierungshäufigkeit jedes Tokens etablierten.
Die Daten nach der Reparatur zeigen deutliche Verbesserungen in der Stabilität der Ausgabe des gesamten Vokabulars des Modells. Die Rate japanischer Antworten, die fremdsprachige Zeichen enthielten, sank von 47 % auf nur noch 1 %. Das Team erforscht weiterhin tiefgreifende Optimierungen, wie etwa die Integration von Vorabtrainingsmaterialien in die Feintuning-Phase oder das direkte Entfernen redundanter Markierungen, die im Vokabular nicht mehr verwendet werden.
Dieser Vorfall hat erhebliche Reflexionen in der Branche ausgelöst: Während Tokenizer großer Modelle oft auf breiten Webkorpora aufgebaut sind, unterscheiden sich die Anwendungen im Downstream-Bereich stark. Die Sicherstellung einer ausreichenden Datenabdeckung auf Token-Ebene aus einer grundlegenden statistischen Perspektive bei gleichzeitiger Wahrung der semantischen Vielfalt bleibt eine kritische Herausforderung für die Verbesserung der Zuverlässigkeit großer Modelle.








 AliVideo stellt Wan3.0 vor und liefert ultra-lange Video-Generierung sowie multidimensionale Konsistenz
Am 24. August stellte Alibaba Wan3.0 vor, sein neuestes großes Video-Generierungsmodell. Diese Veröffentlichung stellt einen bedeutenden Fortschritt in Alibabas Videotechnologie dar und bietet erhebliche Verbesserungen in Bezug auf Dauer, universelle
 Das Nvidia-H200-Geschäft in China übersteht den Trump-Xi-Gipfel, jedoch nicht wie erwartet.
Präsident Trump reiste nach Peking, wobei Jensen Huang in letzter Minute der Delegation beitrat und zwei Tage später mit vagen Äußerungen zu möglichen Entwicklungen bei Chipexporten abreiste. Es kam zu keinem Deal. Seit Trump im Dezember 2025 den Ver
 Wie behebt man Core Web Vitals für die SEO-Ranking?
Das Erstellen visuell ansprechender Assets ist in der Spieleentwicklung von entscheidender Bedeutung. Pixel-Art, mit ihrer charmanten Retro-Ästhetik, bleibt eine beliebte Wahl. Mit dem Aufkommen von KI-Tools ist die Erstellung von Pixel-Art zugänglic

Die besten und am besten bewerteten KI-Illustrationstools 2026: Unsere sorgfältig zusammengestellte Liste enthält die leistungsstärksten Tools, mit denen Sie im Handumdrehen atemberaubende redaktionelle Szenen und auffällige Cover-Grafiken erstellen können. Jede Option wurde strengen Praxistests unterzogen und wird im Vergleich zwischen kostenlosen und kostenpflichtigen Versionen vorgestellt, damit Sie die perfekte Lösung für Ihren Arbeitsablauf finden können. Probieren Sie diese unverzichtbaren Lösungen noch heute aus, um Ihren KI-Vorteil zu nutzen und Ihre kreative Produktivität zu steigern. Entdecken Sie sie jetzt auf XIX.AI.
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Nachhilfetools für die Prüfungsvorbereitung des Jahres 2026 finden Sie hier auf XIX.AI! Unsere sorgfältig zusammengestellte Liste enthält leistungsstarke, bahnbrechende Tools, die einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, Tests aus der Praxis sowie wöchentlich aktualisierte Rankings bieten. Sie helfen Ihnen dabei, Ihre Schreibeffizienz zu steigern, das Erlernen komplexer Themen zu vereinfachen und Ihr akademisches Potenzial voll auszuschöpfen. Entdecken Sie jetzt Ihr perfektes Tool zur Prüfungsvorbereitung und legen Sie noch heute los, um Ihren KI-Vorteil zu nutzen!
10 Tools
xix.ai

2026 Neueste Besten Top-Bewertete KI-Budgetplanungs-Tools für persönliches Geldmanagement sind hier auf XIX.AI! Diese kuratierte Sammlung bietet leistungsstarke, revolutionäre Lösungen, die Ihnen helfen, reale Tests durchzuführen, Ausgaben Gewohnheiten zu verstehen und personalisierte Pläne zu erstellen, um die Produktivität zu steigern. Genießen Sie einen kostenlosen vs. bezahlten Vergleich sowie detaillierte Rankings. Unbedingt auszuprobierende Tools, die darauf ausgelegt sind, das Geldmanagement zu vereinfachen und Ihre KI-Vorteile freizuschalten. Entdecken Sie jetzt!
11 Tools
xix.ai

2026 – Die neuesten, besten und am höchsten bewerteten AI-Geräte zur Schlafüberwachung, sorgfältig ausgewählt für eine optimale Erholung. Dieser vollständig aktualisierte wöchentliche Leitfaden präsentiert leistungsstarke Tools mit praktischen Tests, einem Vergleich von kostenlosen und kostenpflichtigen Optionen sowie detaillierten Ranglisten, um Ihnen die beste Lösung zu zeigen, die die Schlafqualität verbessert und bessere Gewohnheiten zum Zubettgehen fördert. Entdecken Sie ihn jetzt auf XIX.AI, um Ihren Vorteil durch KI zu nutzen.
10 Tools
xix.ai

Die besten und am besten bewerteten KI-SQL-Copilots für Produkt- und Umsatzanalysen im Jahr 2026! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die anhand wöchentlich aktualisierter Rankings in der Praxis getestet werden. Diese Tools helfen Anwendern dabei, ihre Produktivität erheblich zu steigern, indem sie die Datenanalyse beschleunigen, komplexe Abfragen optimieren und präzise Erkenntnisse liefern, um intelligentere Geschäftsentscheidungen zu ermöglichen. Entdecken Sie jetzt das perfekte Tool, um Ihren KI-Vorteil voll auszuschöpfen!
14 Tools
xix.ai

2026: Die aktuell besten und am besten bewerteten KI-Hausaufgabenhelfer, die nicht nur Antworten liefern, sondern auch Kernkonzepte vermitteln – leistungsstarke Tools für Schüler und Studenten. Eine kuratierte Liste, die Sie unbedingt ausprobieren sollten. Wöchentlich aktualisiert. Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten. Praxistests. Genaue Rankings, die Ihnen helfen, Ihr volles Lernpotenzial auszuschöpfen. Entdecken Sie jetzt das perfekte Tool für intelligenteres Lernen.
10 Tools
xix.ai












