


 Lar
MiniMax Grande Modelo Erra na Pronúncia de Nomes - Xiyu Technology: Treinamento Insuficiente Após Tokens Específicos
A MiniMax publicou recentemente um relatório técnico detalhando por que seus modelos da série M2 tiveram dificuldades para gerar nomes específicos com precisão, como "Ma Jiaqi". Esse erro aparente destaca uma falha sistêmica no treinamento atual de grandes modelos de linguagem.
Deslocamento de Token: O Espaço Vetorial Comprimido
A causa raiz reside no tokenizador, a unidade fundamental de processamento de texto. Por exemplo, o nome "Ma Jiaqi" é dividido em dois tokens: "Ma" e "Jiaqi". Embora o modelo tenha aprendido esses elementos durante o pré-treinamento, surgiram problemas na fase subsequente de ajuste fino por instrução.
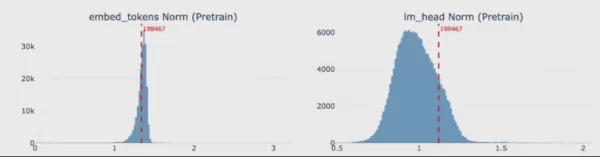
Durante o ajuste fino, o token "Jiaqi" apareceu com tanta raridade nos dados de diálogo que recebeu quase nenhum treinamento. Enquanto isso, tokens de alta frequência, como símbolos de código e chamadas de ferramentas, foram fortemente reforçados, "comprimindo" efetivamente o espaço de representação dos tokens de baixa frequência. Consequentemente, esses tokens se desviaram de suas distribuições de probabilidade corretas, fazendo com que o modelo os substituísse por alternativas foneticamente semelhantes, como "Jiaqi" ou "Qiqi", ao referenciar celebridades específicas.
Além do Chinês: Reação em Cadeia de Japonês Misturado com Russo
A análise da MiniMax revelou que essa "degradação de token" é generalizada. Ao escanear aproximadamente 200.000 tokens no vocabulário completo, eles descobriram que cerca de 4,9% apresentaram quedas significativas de desempenho. Notavelmente, os tokens japoneses sofreram uma taxa de degradação de até 29,7%, o que explica por que o modelo ocasionalmente mistura caracteres russos ou coreanos em conversas em japonês.
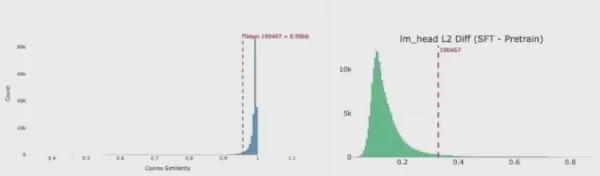
Além de nomes e idiomas estrangeiros, os tokens afetados incluem marcadores LaTeX, símbolos de código-fonte da Wikipedia e até certas palavras-chave de spam de SEO. Isso demonstra que a escassez de dados tem consequências globais: quando os dados de pós-treinamento não cobrem uniformemente idiomas diversos e vocabulários específicos, a lógica de geração do modelo se torna enviesada.
Reparo Sistemático: Estabelecimento de uma "Garantia Mínima" para 200.000 Tokens
Para corrigir essa falha estrutural, a equipe de P&D implementou uma estratégia de reparo precisa. Eles geraram dados sintéticos cobrindo todo o vocabulário e forçaram o modelo a realizar tarefas de "repetição", estabelecendo assim uma "garantia mínima" para a frequência de geração de cada token.
Os dados pós-reparo mostram melhorias marcantes na estabilidade da saída do vocabulário completo do modelo. A taxa de caracteres estrangeiros misturados nas respostas em japonês caiu de 47% para apenas 1%. A equipe continua a explorar otimizações mais profundas, como integrar materiais de pré-treinamento na fase de ajuste fino ou remover diretamente marcadores redundantes que não são mais usados no vocabulário.
Este incidente desencadeou uma reflexão significativa na indústria: embora os tokenizadores de grandes modelos sejam frequentemente construídos com base em grandes corpora da web, as aplicações downstream variam amplamente. Garantir cobertura adequada de dados em nível de token, sob uma perspectiva estatística fundamental, ao mesmo tempo em que se mantém a diversidade semântica, continua sendo um desafio crítico para melhorar a confiabilidade dos grandes modelos.
Artigo relacionado
 A AliVideo revela o Wan3.0, oferecendo geração de vídeos ultra-longos e consistência multidimensional
Em 24 de agosto, a Alibaba apresentou o Wan3.0, seu mais recente modelo de geração de vídeo em larga escala. Este lançamento representa um grande avanço na tecnologia de vídeo da Alibaba, proporcionando melhorias significativas na duração, criação un
Acordo da Nvidia com a China para o H200 sobrevive à cúpula Trump-Xi, mas não como esperado
O presidente Trump viajou a Pequim com Jensen Huang se juntando à delegação na última hora, partindo dois dias depois com declarações vagas sobre possíveis desenvolvimentos nas exportações de chips. Nenhum acordo se concretizou. Desde que Trump autor
Como corrigir as Core Web Vitals para a classificação de SEO?
Criar ativos visualmente atraentes é crucial no desenvolvimento de jogos. A pixel art, com sua estética retrô encantadora, continua sendo uma escolha popular. Com o advento das ferramentas de IA, a geração de pixel art tornou-se mais acessível do que
Recomendações de tópicos especiais relacionados
Design e Arte
 As melhores ferramentas de ilustração com IA: crie cenas editoriais e capas de forma mais rápida
As melhores ferramentas de ilustração com IA de 2026: nossa lista selecionada apresenta as melhores ferramentas, com design robusto, para criar rapidamente cenas editoriais impressionantes e capas atraentes. Cada opção passou por rigorosos testes práticos, oferecendo uma comparação entre versões gratuitas e pagas para ajudar você a encontrar a opção perfeita para o seu fluxo de trabalho. Experimente hoje mesmo essas soluções imperdíveis para aproveitar ao máximo as vantagens da IA e impulsionar sua produtividade criativa. Explore agora no XIX.AI.
 10 ferramentas
 xix.ai
Educação e Aprendizagem
Os melhores professores particulares especializados em IA para preparação para exames: pratique matemática, ciências e inglês
Os melhores tutores de IA para preparação para exames de 2026, com as melhores avaliações, estão aqui no XIX.AI! Nossa lista cuidadosamente selecionada apresenta ferramentas poderosas e revolucionárias que oferecem comparação entre versões gratuitas e pagas, testes práticos e rankings atualizados semanalmente. Elas ajudam a aumentar sua eficiência na redação, simplificar o aprendizado de tópicos complexos e liberar seu potencial acadêmico. Explore agora para descobrir sua ferramenta perfeita de preparação para exames e comece a criar hoje mesmo para aproveitar toda a vantagem da IA!
10 ferramentas
xix.ai
Financiar
Ferramentas de planejamento orçamentário com IA para gestão financeira pessoal
As melhores e mais bem avaliadas ferramentas de planejamento orçamentário com IA para gestão financeira pessoal de 2026 estão aqui no XIX.AI! Esta seleção especial apresenta soluções poderosas e revolucionárias que ajudam você a realizar testes na prática, entender hábitos de consumo e criar planos personalizados para aumentar a produtividade. Confira uma comparação entre versões gratuitas e pagas, além de rankings detalhados. Ferramentas imperdíveis, projetadas para simplificar a gestão financeira e explorar o potencial da IA. Explore agora!
11 ferramentas
xix.ai
Saúde e Bem-Estar
Assistentes de rastreamento do sono com IA: melhore sua recuperação adotando hábitos mais adequados antes de dormir
2026 – Os melhores assistentes de rastreamento do sono com inteligência artificial mais bem avaliados, selecionados para proporcionar uma recuperação máxima. Este guia semanal completamente atualizado apresenta ferramentas poderosas que incluem testes reais, comparações entre versões gratuitas e pagas, além de classificações detalhadas, visando ajudá-lo a encontrar a solução ideal para melhorar a qualidade do sono e fomentar hábitos noturnos mais saudáveis. Explore agora em XIX.AI e aproveite todas as vantagens oferecidas pela inteligência artificial.
10 ferramentas
xix.ai
Análise de dados
Copilotos de IA em SQL para análise de produtos e receitas
2026: Os melhores e mais bem avaliados copilotos de IA para SQL em análise de produtos e receitas! A XIX.AI selecionou um conjunto poderoso e revolucionário de ferramentas imperdíveis, que passam por testes práticos por meio de rankings atualizados semanalmente. Essas ferramentas ajudam os usuários a aumentar significativamente a produtividade, acelerando a análise de dados, simplificando consultas complexas e gerando insights precisos para impulsionar decisões de negócios mais inteligentes. Explore agora e descubra a ferramenta perfeita para aproveitar ao máximo o potencial da IA!
14 ferramentas
xix.ai
Educação e Aprendizagem
Os melhores auxiliares de tarefas escolares com IA que ensinam: aprenda conceitos, não apenas respostas
2026: Os melhores e mais bem avaliados auxiliares de tarefas com IA que ensinam conceitos fundamentais, não apenas respostas. Ferramentas poderosas para estudantes. Lista selecionada que você não pode deixar de conferir. Atualizada semanalmente. Comparação entre versões gratuitas e pagas. Testes em situações reais. Rankings precisos para ajudar você a atingir todo o seu potencial de aprendizado. Explore agora e descubra a ferramenta perfeita para estudar de forma mais inteligente.
10 ferramentas
xix.ai

 Comentários (0)
A MiniMax publicou recentemente um relatório técnico detalhando por que seus modelos da série M2 tiveram dificuldades para gerar nomes específicos com precisão, como "Ma Jiaqi". Esse erro aparente destaca uma falha sistêmica no treinamento atual de grandes modelos de linguagem.
Deslocamento de Token: O Espaço Vetorial Comprimido
A causa raiz reside no tokenizador, a unidade fundamental de processamento de texto. Por exemplo, o nome "Ma Jiaqi" é dividido em dois tokens: "Ma" e "Jiaqi". Embora o modelo tenha aprendido esses elementos durante o pré-treinamento, surgiram problemas na fase subsequente de ajuste fino por instrução.
Durante o ajuste fino, o token "Jiaqi" apareceu com tanta raridade nos dados de diálogo que recebeu quase nenhum treinamento. Enquanto isso, tokens de alta frequência, como símbolos de código e chamadas de ferramentas, foram fortemente reforçados, "comprimindo" efetivamente o espaço de representação dos tokens de baixa frequência. Consequentemente, esses tokens se desviaram de suas distribuições de probabilidade corretas, fazendo com que o modelo os substituísse por alternativas foneticamente semelhantes, como "Jiaqi" ou "Qiqi", ao referenciar celebridades específicas.
Além do Chinês: Reação em Cadeia de Japonês Misturado com Russo
A análise da MiniMax revelou que essa "degradação de token" é generalizada. Ao escanear aproximadamente 200.000 tokens no vocabulário completo, eles descobriram que cerca de 4,9% apresentaram quedas significativas de desempenho. Notavelmente, os tokens japoneses sofreram uma taxa de degradação de até 29,7%, o que explica por que o modelo ocasionalmente mistura caracteres russos ou coreanos em conversas em japonês.
Além de nomes e idiomas estrangeiros, os tokens afetados incluem marcadores LaTeX, símbolos de código-fonte da Wikipedia e até certas palavras-chave de spam de SEO. Isso demonstra que a escassez de dados tem consequências globais: quando os dados de pós-treinamento não cobrem uniformemente idiomas diversos e vocabulários específicos, a lógica de geração do modelo se torna enviesada.
Reparo Sistemático: Estabelecimento de uma "Garantia Mínima" para 200.000 Tokens
Para corrigir essa falha estrutural, a equipe de P&D implementou uma estratégia de reparo precisa. Eles geraram dados sintéticos cobrindo todo o vocabulário e forçaram o modelo a realizar tarefas de "repetição", estabelecendo assim uma "garantia mínima" para a frequência de geração de cada token.
Os dados pós-reparo mostram melhorias marcantes na estabilidade da saída do vocabulário completo do modelo. A taxa de caracteres estrangeiros misturados nas respostas em japonês caiu de 47% para apenas 1%. A equipe continua a explorar otimizações mais profundas, como integrar materiais de pré-treinamento na fase de ajuste fino ou remover diretamente marcadores redundantes que não são mais usados no vocabulário.
Este incidente desencadeou uma reflexão significativa na indústria: embora os tokenizadores de grandes modelos sejam frequentemente construídos com base em grandes corpora da web, as aplicações downstream variam amplamente. Garantir cobertura adequada de dados em nível de token, sob uma perspectiva estatística fundamental, ao mesmo tempo em que se mantém a diversidade semântica, continua sendo um desafio crítico para melhorar a confiabilidade dos grandes modelos.








 A AliVideo revela o Wan3.0, oferecendo geração de vídeos ultra-longos e consistência multidimensional
Em 24 de agosto, a Alibaba apresentou o Wan3.0, seu mais recente modelo de geração de vídeo em larga escala. Este lançamento representa um grande avanço na tecnologia de vídeo da Alibaba, proporcionando melhorias significativas na duração, criação un
 Acordo da Nvidia com a China para o H200 sobrevive à cúpula Trump-Xi, mas não como esperado
O presidente Trump viajou a Pequim com Jensen Huang se juntando à delegação na última hora, partindo dois dias depois com declarações vagas sobre possíveis desenvolvimentos nas exportações de chips. Nenhum acordo se concretizou. Desde que Trump autor
 Como corrigir as Core Web Vitals para a classificação de SEO?
Criar ativos visualmente atraentes é crucial no desenvolvimento de jogos. A pixel art, com sua estética retrô encantadora, continua sendo uma escolha popular. Com o advento das ferramentas de IA, a geração de pixel art tornou-se mais acessível do que

As melhores ferramentas de ilustração com IA de 2026: nossa lista selecionada apresenta as melhores ferramentas, com design robusto, para criar rapidamente cenas editoriais impressionantes e capas atraentes. Cada opção passou por rigorosos testes práticos, oferecendo uma comparação entre versões gratuitas e pagas para ajudar você a encontrar a opção perfeita para o seu fluxo de trabalho. Experimente hoje mesmo essas soluções imperdíveis para aproveitar ao máximo as vantagens da IA e impulsionar sua produtividade criativa. Explore agora no XIX.AI.
10 ferramentas
xix.ai

Os melhores tutores de IA para preparação para exames de 2026, com as melhores avaliações, estão aqui no XIX.AI! Nossa lista cuidadosamente selecionada apresenta ferramentas poderosas e revolucionárias que oferecem comparação entre versões gratuitas e pagas, testes práticos e rankings atualizados semanalmente. Elas ajudam a aumentar sua eficiência na redação, simplificar o aprendizado de tópicos complexos e liberar seu potencial acadêmico. Explore agora para descobrir sua ferramenta perfeita de preparação para exames e comece a criar hoje mesmo para aproveitar toda a vantagem da IA!
10 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de planejamento orçamentário com IA para gestão financeira pessoal de 2026 estão aqui no XIX.AI! Esta seleção especial apresenta soluções poderosas e revolucionárias que ajudam você a realizar testes na prática, entender hábitos de consumo e criar planos personalizados para aumentar a produtividade. Confira uma comparação entre versões gratuitas e pagas, além de rankings detalhados. Ferramentas imperdíveis, projetadas para simplificar a gestão financeira e explorar o potencial da IA. Explore agora!
11 ferramentas
xix.ai

2026 – Os melhores assistentes de rastreamento do sono com inteligência artificial mais bem avaliados, selecionados para proporcionar uma recuperação máxima. Este guia semanal completamente atualizado apresenta ferramentas poderosas que incluem testes reais, comparações entre versões gratuitas e pagas, além de classificações detalhadas, visando ajudá-lo a encontrar a solução ideal para melhorar a qualidade do sono e fomentar hábitos noturnos mais saudáveis. Explore agora em XIX.AI e aproveite todas as vantagens oferecidas pela inteligência artificial.
10 ferramentas
xix.ai

2026: Os melhores e mais bem avaliados copilotos de IA para SQL em análise de produtos e receitas! A XIX.AI selecionou um conjunto poderoso e revolucionário de ferramentas imperdíveis, que passam por testes práticos por meio de rankings atualizados semanalmente. Essas ferramentas ajudam os usuários a aumentar significativamente a produtividade, acelerando a análise de dados, simplificando consultas complexas e gerando insights precisos para impulsionar decisões de negócios mais inteligentes. Explore agora e descubra a ferramenta perfeita para aproveitar ao máximo o potencial da IA!
14 ferramentas
xix.ai

2026: Os melhores e mais bem avaliados auxiliares de tarefas com IA que ensinam conceitos fundamentais, não apenas respostas. Ferramentas poderosas para estudantes. Lista selecionada que você não pode deixar de conferir. Atualizada semanalmente. Comparação entre versões gratuitas e pagas. Testes em situações reais. Rankings precisos para ajudar você a atingir todo o seu potencial de aprendizado. Explore agora e descubra a ferramenta perfeita para estudar de forma mais inteligente.
10 ferramentas
xix.ai












