


 Hogar
MiniMax Grandes Modelos Pronuncian Incorrectamente Nombres - Xiyu Technology: Entrenamiento Insuficiente Después de Tokens Específicos
MiniMax publicó recientemente un informe técnico que detalla por qué sus modelos de la serie M2 tuvieron dificultades para generar con precisión nombres específicos como "Ma Jiaqi". Este aparente error destaca una falla sistémica en el entrenamiento actual de los modelos de lenguaje grandes.
Desplazamiento de tokens: El espacio vectorial comprimido
La causa raíz reside en el tokenizador, la unidad fundamental del procesamiento de texto. Por ejemplo, el nombre "Ma Jiaqi" se divide en dos tokens: "Ma" y "Jiaqi". Aunque el modelo aprendió estos elementos durante el preentrenamiento, surgieron problemas durante la fase posterior de ajuste fino por instrucciones.
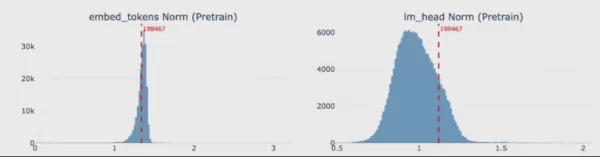
Durante el ajuste fino, el token "Jiaqi" apareció con tan poca frecuencia en los datos de diálogo que recibió casi ningún entrenamiento. Mientras tanto, los tokens de alta frecuencia, como los símbolos de código y las llamadas a herramientas, se reforzaron intensamente, "comprimiendo" efectivamente el espacio de representación de los tokens de baja frecuencia. En consecuencia, estos tokens se desviaron de sus distribuciones de probabilidad correctas, lo que hizo que el modelo los sustituyera por alternativas fonéticamente similares como "Jiaqi" o "Qiqi" al referirse a celebridades específicas.
Más allá del chino: Reacción en cadena de japonés mezclado con ruso
El análisis de MiniMax reveló que esta "degradación de tokens" es generalizada. Al escanear aproximadamente 200.000 tokens en el vocabulario completo, descubrieron que alrededor del 4,9 % mostró caídas significativas en el rendimiento. Cabe destacar que los tokens japoneses sufrieron una tasa de degradación de hasta el 29,7 %, lo que explica por qué el modelo mezcla ocasionalmente caracteres rusos o coreanos en conversaciones en japonés.
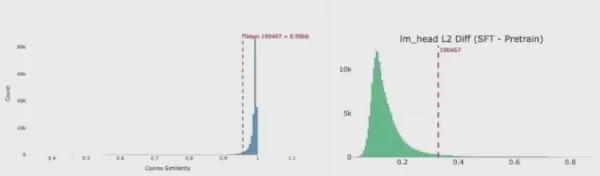
Más allá de los nombres y los idiomas extranjeros, los tokens afectados incluyen marcadores de LaTeX, símbolos del código fuente de Wikipedia e incluso ciertas palabras clave de spam de SEO. Esto demuestra que la escasez de datos tiene consecuencias globales: cuando los datos de entrenamiento posterior no cubren uniformemente diversos idiomas y vocabularios específicos, la lógica de generación del modelo se vuelve sesgada.
Reparación sistemática: Establecer una "garantía mínima" para 200.000 tokens
Para solucionar este problema estructural, el equipo de I+D implementó una estrategia de reparación precisa. Generaron datos sintéticos que cubren todo el vocabulario y obligaron al modelo a realizar tareas de "repetición", estableciendo así una "garantía mínima" para la frecuencia de generación de cada token.
Los datos posteriores a la reparación muestran mejoras marcadas en la estabilidad de la salida del vocabulario completo del modelo. La tasa de caracteres extranjeros mezclados en las respuestas en japonés disminuyó del 47 % a solo el 1 %. El equipo continúa explorando optimizaciones más profundas, como integrar materiales de preentrenamiento en la etapa de ajuste fino o eliminar directamente marcadores redundantes que ya no se utilizan en el vocabulario.
Este incidente ha provocado una reflexión significativa en la industria: aunque los tokenizadores de los modelos grandes suelen construirse sobre corpus web amplios, las aplicaciones downstream varían ampliamente. Garantizar una cobertura de datos adecuada a nivel de token desde una perspectiva estadística fundamental, manteniendo al mismo tiempo la diversidad semántica, sigue siendo un desafío crítico para mejorar la fiabilidad de los modelos grandes.
Artículo relacionado
 AliVideo presenta Wan3.0, ofreciendo generación de vídeo ultra largo y consistencia multidimensional
El 24 de agosto, Alibaba presentó Wan3.0, su último modelo de generación de video a gran escala. Este lanzamiento representa un avance importante en la tecnología de video de Alibaba, ofreciendo mejoras significativas en duración, creación universal,
El acuerdo de Nvidia con China para el H200 sobrevive a la cumbre Trump-Xi, pero no como se esperaba
El presidente Trump viajó a Pekín con Jensen Huang uniéndose a la delegación en el último momento, partiendo dos días después con declaraciones vagas sobre posibles desarrollos en la exportación de chips. No se concretó ningún acuerdo. Desde que Trum
¿Cómo solucionar las Core Web Vitals para el posicionamiento SEO?
Crear activos visualmente atractivos es crucial en el desarrollo de videojuegos. El pixel art, con su encantadora estética retro, sigue siendo una opción popular. Con la llegada de herramientas de IA, generar pixel art se ha vuelto más accesible que
Recomendaciones de temas especiales relacionados
Diseño y Arte
 Las mejores herramientas de ilustración con IA: crea escenas editoriales y portadas más rápido
Las mejores herramientas de ilustración con IA de 2026: nuestra lista seleccionada incluye las mejores herramientas, diseñadas con gran potencia, para crear rápidamente impresionantes escenas editoriales y llamativas portadas. Cada opción ha sido sometida a rigurosas pruebas en condiciones reales y ofrece una comparación entre las versiones gratuitas y de pago para ayudarte a encontrar la que mejor se adapte a tu flujo de trabajo. Prueba hoy mismo estas soluciones imprescindibles para sacar el máximo partido a la IA y potenciar tu productividad creativa. Descúbrelas ahora en XIX.AI.
 10 herramientas
 xix.ai
Educación y aprendizaje
Los mejores profesores particulares de IA para la preparación de exámenes: practica matemáticas, ciencias e inglés
¡Ya están aquí, en XIX.AI, los mejores tutores de IA para la preparación de exámenes de 2026, con las mejores valoraciones! Nuestra lista seleccionada incluye potentes herramientas revolucionarias que ofrecen comparativas entre versiones gratuitas y de pago, pruebas reales y clasificaciones actualizadas semanalmente. Te ayudan a mejorar tu eficiencia a la hora de escribir, a simplificar el aprendizaje de temas complejos y a desarrollar todo tu potencial académico. ¡Explora ahora mismo para descubrir tu herramienta perfecta de preparación de exámenes y empieza a crear hoy mismo para sacar partido a tu ventaja con la IA!
10 herramientas
xix.ai
Finanzas
Herramientas de planificación presupuestaria con IA para la gestión personal del dinero
2026 Últimas Mejores Herramientas de Planificación Presupuestaria con IA Mejor Valoradas para la Gestión Personal del Dinero están aquí en XIX.AI. Esta colección seleccionada presenta soluciones poderosas y transformadoras que te ayudan a realizar pruebas en el mundo real, comprender tus hábitos de gasto y crear planes personalizados para aumentar la productividad. Disfruta de una comparación entre versiones gratuitas y de pago junto con clasificaciones detalladas. Herramientas imprescindibles diseñadas para simplificar la gestión del dinero y desbloquear tu ventaja con IA. ¡Explóralas ahora!
11 herramientas
xix.ai
Salud y bienestar
Asistentes de seguimiento del sueño basados en IA: mejora tu recuperación con mejores hábitos a la hora de acostarte
Los mejores asistentes de seguimiento del sueño con IA de 2026, seleccionados para una recuperación óptima. Esta guía semanal totalmente actualizada incluye potentes herramientas que ofrecen pruebas en condiciones reales, comparativas entre opciones gratuitas y de pago, y clasificaciones detalladas para ayudarte a encontrar la solución imprescindible que mejora la calidad del sueño y fomenta mejores hábitos a la hora de acostarse. Descúbrelo ahora en XIX.AI y aprovecha todas las ventajas de la IA.
10 herramientas
xix.ai
Análisis de datos
Copilotos de IA y SQL para el análisis de productos e ingresos
¡Los mejores copilotos de IA para SQL mejor valorados de 2026 para el análisis de productos e ingresos! XIX.AI ha seleccionado una potente colección de herramientas revolucionarias que no te puedes perder y que se someten a pruebas en el mundo real a través de clasificaciones que se actualizan semanalmente. Estas herramientas ayudan a los usuarios a aumentar significativamente su productividad al acelerar el análisis de datos, simplificar consultas complejas y generar información precisa para tomar decisiones empresariales más inteligentes. ¡Explora ahora mismo y descubre la herramienta perfecta para sacar el máximo partido a tu ventaja en IA!
14 herramientas
xix.ai
Educación y aprendizaje
Las mejores herramientas de IA para los deberes que realmente enseñan: aprende conceptos, no solo respuestas
2026: los mejores y más valorados asistentes de deberes con IA que enseñan conceptos básicos, no solo respuestas. Potentes herramientas para estudiantes. Una selección imprescindible que debes probar. Actualización semanal. Comparativa entre opciones gratuitas y de pago. Pruebas en el mundo real. Clasificaciones precisas para ayudarte a desarrollar todo tu potencial de aprendizaje. Explora ahora y descubre la herramienta perfecta para estudiar de forma más inteligente.
10 herramientas
xix.ai

 comentario (0)
0/500
MiniMax publicó recientemente un informe técnico que detalla por qué sus modelos de la serie M2 tuvieron dificultades para generar con precisión nombres específicos como "Ma Jiaqi". Este aparente error destaca una falla sistémica en el entrenamiento actual de los modelos de lenguaje grandes.
Desplazamiento de tokens: El espacio vectorial comprimido
La causa raíz reside en el tokenizador, la unidad fundamental del procesamiento de texto. Por ejemplo, el nombre "Ma Jiaqi" se divide en dos tokens: "Ma" y "Jiaqi". Aunque el modelo aprendió estos elementos durante el preentrenamiento, surgieron problemas durante la fase posterior de ajuste fino por instrucciones.
Durante el ajuste fino, el token "Jiaqi" apareció con tan poca frecuencia en los datos de diálogo que recibió casi ningún entrenamiento. Mientras tanto, los tokens de alta frecuencia, como los símbolos de código y las llamadas a herramientas, se reforzaron intensamente, "comprimiendo" efectivamente el espacio de representación de los tokens de baja frecuencia. En consecuencia, estos tokens se desviaron de sus distribuciones de probabilidad correctas, lo que hizo que el modelo los sustituyera por alternativas fonéticamente similares como "Jiaqi" o "Qiqi" al referirse a celebridades específicas.
Más allá del chino: Reacción en cadena de japonés mezclado con ruso
El análisis de MiniMax reveló que esta "degradación de tokens" es generalizada. Al escanear aproximadamente 200.000 tokens en el vocabulario completo, descubrieron que alrededor del 4,9 % mostró caídas significativas en el rendimiento. Cabe destacar que los tokens japoneses sufrieron una tasa de degradación de hasta el 29,7 %, lo que explica por qué el modelo mezcla ocasionalmente caracteres rusos o coreanos en conversaciones en japonés.
Más allá de los nombres y los idiomas extranjeros, los tokens afectados incluyen marcadores de LaTeX, símbolos del código fuente de Wikipedia e incluso ciertas palabras clave de spam de SEO. Esto demuestra que la escasez de datos tiene consecuencias globales: cuando los datos de entrenamiento posterior no cubren uniformemente diversos idiomas y vocabularios específicos, la lógica de generación del modelo se vuelve sesgada.
Reparación sistemática: Establecer una "garantía mínima" para 200.000 tokens
Para solucionar este problema estructural, el equipo de I+D implementó una estrategia de reparación precisa. Generaron datos sintéticos que cubren todo el vocabulario y obligaron al modelo a realizar tareas de "repetición", estableciendo así una "garantía mínima" para la frecuencia de generación de cada token.
Los datos posteriores a la reparación muestran mejoras marcadas en la estabilidad de la salida del vocabulario completo del modelo. La tasa de caracteres extranjeros mezclados en las respuestas en japonés disminuyó del 47 % a solo el 1 %. El equipo continúa explorando optimizaciones más profundas, como integrar materiales de preentrenamiento en la etapa de ajuste fino o eliminar directamente marcadores redundantes que ya no se utilizan en el vocabulario.
Este incidente ha provocado una reflexión significativa en la industria: aunque los tokenizadores de los modelos grandes suelen construirse sobre corpus web amplios, las aplicaciones downstream varían ampliamente. Garantizar una cobertura de datos adecuada a nivel de token desde una perspectiva estadística fundamental, manteniendo al mismo tiempo la diversidad semántica, sigue siendo un desafío crítico para mejorar la fiabilidad de los modelos grandes.








 AliVideo presenta Wan3.0, ofreciendo generación de vídeo ultra largo y consistencia multidimensional
El 24 de agosto, Alibaba presentó Wan3.0, su último modelo de generación de video a gran escala. Este lanzamiento representa un avance importante en la tecnología de video de Alibaba, ofreciendo mejoras significativas en duración, creación universal,
 El acuerdo de Nvidia con China para el H200 sobrevive a la cumbre Trump-Xi, pero no como se esperaba
El presidente Trump viajó a Pekín con Jensen Huang uniéndose a la delegación en el último momento, partiendo dos días después con declaraciones vagas sobre posibles desarrollos en la exportación de chips. No se concretó ningún acuerdo. Desde que Trum
 ¿Cómo solucionar las Core Web Vitals para el posicionamiento SEO?
Crear activos visualmente atractivos es crucial en el desarrollo de videojuegos. El pixel art, con su encantadora estética retro, sigue siendo una opción popular. Con la llegada de herramientas de IA, generar pixel art se ha vuelto más accesible que

Las mejores herramientas de ilustración con IA de 2026: nuestra lista seleccionada incluye las mejores herramientas, diseñadas con gran potencia, para crear rápidamente impresionantes escenas editoriales y llamativas portadas. Cada opción ha sido sometida a rigurosas pruebas en condiciones reales y ofrece una comparación entre las versiones gratuitas y de pago para ayudarte a encontrar la que mejor se adapte a tu flujo de trabajo. Prueba hoy mismo estas soluciones imprescindibles para sacar el máximo partido a la IA y potenciar tu productividad creativa. Descúbrelas ahora en XIX.AI.
10 herramientas
xix.ai

¡Ya están aquí, en XIX.AI, los mejores tutores de IA para la preparación de exámenes de 2026, con las mejores valoraciones! Nuestra lista seleccionada incluye potentes herramientas revolucionarias que ofrecen comparativas entre versiones gratuitas y de pago, pruebas reales y clasificaciones actualizadas semanalmente. Te ayudan a mejorar tu eficiencia a la hora de escribir, a simplificar el aprendizaje de temas complejos y a desarrollar todo tu potencial académico. ¡Explora ahora mismo para descubrir tu herramienta perfecta de preparación de exámenes y empieza a crear hoy mismo para sacar partido a tu ventaja con la IA!
10 herramientas
xix.ai

2026 Últimas Mejores Herramientas de Planificación Presupuestaria con IA Mejor Valoradas para la Gestión Personal del Dinero están aquí en XIX.AI. Esta colección seleccionada presenta soluciones poderosas y transformadoras que te ayudan a realizar pruebas en el mundo real, comprender tus hábitos de gasto y crear planes personalizados para aumentar la productividad. Disfruta de una comparación entre versiones gratuitas y de pago junto con clasificaciones detalladas. Herramientas imprescindibles diseñadas para simplificar la gestión del dinero y desbloquear tu ventaja con IA. ¡Explóralas ahora!
11 herramientas
xix.ai

Los mejores asistentes de seguimiento del sueño con IA de 2026, seleccionados para una recuperación óptima. Esta guía semanal totalmente actualizada incluye potentes herramientas que ofrecen pruebas en condiciones reales, comparativas entre opciones gratuitas y de pago, y clasificaciones detalladas para ayudarte a encontrar la solución imprescindible que mejora la calidad del sueño y fomenta mejores hábitos a la hora de acostarse. Descúbrelo ahora en XIX.AI y aprovecha todas las ventajas de la IA.
10 herramientas
xix.ai

¡Los mejores copilotos de IA para SQL mejor valorados de 2026 para el análisis de productos e ingresos! XIX.AI ha seleccionado una potente colección de herramientas revolucionarias que no te puedes perder y que se someten a pruebas en el mundo real a través de clasificaciones que se actualizan semanalmente. Estas herramientas ayudan a los usuarios a aumentar significativamente su productividad al acelerar el análisis de datos, simplificar consultas complejas y generar información precisa para tomar decisiones empresariales más inteligentes. ¡Explora ahora mismo y descubre la herramienta perfecta para sacar el máximo partido a tu ventaja en IA!
14 herramientas
xix.ai

2026: los mejores y más valorados asistentes de deberes con IA que enseñan conceptos básicos, no solo respuestas. Potentes herramientas para estudiantes. Una selección imprescindible que debes probar. Actualización semanal. Comparativa entre opciones gratuitas y de pago. Pruebas en el mundo real. Clasificaciones precisas para ayudarte a desarrollar todo tu potencial de aprendizaje. Explora ahora y descubre la herramienta perfecta para estudiar de forma más inteligente.
10 herramientas
xix.ai












