


 Maison
DeepSeek dévoile un modèle d'IA rivalisant avec les systèmes de pointe
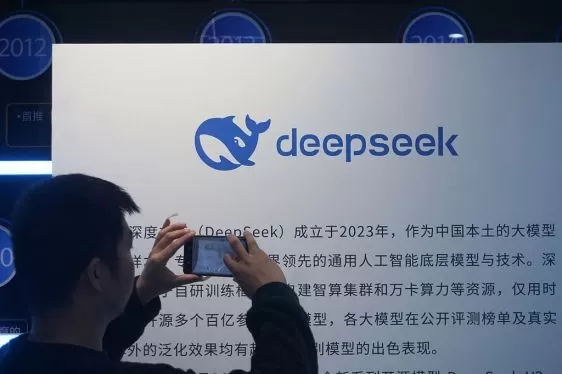
Le laboratoire chinois d'IA DeepSeek a publié deux versions préliminaires de son tout dernier grand modèle linguistique, DeepSeek V4, une mise à jour très attendue du modèle V3.2 de l'année dernière et du modèle de raisonnement R1 qui l'accompagnait, lesquels avaient eu un impact considérable au sein de la communauté de l'IA.
La société indique que DeepSeek V4 Flash et V4 Pro sont tous deux des modèles de type « mixture-of-experts », chacun disposant d'une fenêtre contextuelle d'un million de tokens, ce qui est suffisant pour traiter des bases de code ou des documents volumineux dans le cadre de requêtes. Cette méthode « mixture-of-experts » n'active qu'un sous-ensemble spécifique de paramètres par tâche afin de réduire les coûts d'inférence.
Le modèle Pro compte au total 1,6 billion de paramètres (dont 49 milliards actifs), ce qui en fait le plus grand modèle à poids ouvert disponible. Il surpasse des concurrents tels que Kimi K 2.6 de Moonshot AI (1,1 billion), M1 de MiniMax (456 milliards) et dépasse de plus du double la taille de DeepSeek V3.2 (671 milliards). Le modèle V4 Flash, plus petit, contient 284 milliards de paramètres (dont 13 milliards actifs).
DeepSeek affirme que les améliorations architecturales rendent ces deux nouveaux modèles plus efficaces et plus performants que DeepSeek V3.2, « comblant presque l'écart » avec les modèles de pointe actuels, qu'ils soient open source ou propriétaires, sur les benchmarks de raisonnement.
Le laboratoire indique que son nouveau modèle V4-Pro-Max surpasse ses homologues open source sur les benchmarks de raisonnement et dépasse les performances du GPT-5.2 et du Gemini 3.0 Pro d’OpenAI sur certaines tâches. Dans les benchmarks de concours de codage, DeepSeek affirme que les performances des deux modèles V4 sont « comparables à celles du GPT-5.4 ».
Cependant, les modèles semblent légèrement à la traîne par rapport aux modèles de pointe dans les évaluations basées sur les connaissances, en particulier lorsqu'on les compare au GPT-5.4 d'OpenAI et au dernier Google Gemini 3.1 Pro. Cet écart indique une « trajectoire de développement qui accuse un retard d'environ 3 à 6 mois par rapport aux modèles de pointe », selon le laboratoire.
Contrairement à de nombreux modèles à code source fermé qui prennent en charge la génération d'audio, de vidéo et d'images, V4 Flash et V4 Pro sont tous deux des modèles exclusivement textuels.
Un avantage clé est que DeepSeek V4 est nettement plus rentable que les modèles de pointe actuels. Le plus petit modèle, V4 Flash, est proposé à 0,14 $ par million de tokens d'entrée et 0,28 $ par million de tokens de sortie, ce qui est moins cher que le GPT-5.4 Nano, le Gemini 3.1 Flash, le GPT-5.4 Mini et le Claude Haiku 4.5. Le modèle V4 Pro, plus grand, coûte 0,145 $ par million de tokens d'entrée et 3,48 $ par million de tokens de sortie, proposant également des tarifs inférieurs à ceux de Gemini 3.1 Pro, GPT-5.5, Claude Opus 4.7 et GPT-5.4.
Ce lancement intervient un jour après que les États-Unis ont accusé la Chine de se livrer à un vol de propriété intellectuelle à l'échelle industrielle auprès de laboratoires américains d'IA en utilisant des milliers de comptes proxy. DeepSeek a lui-même fait l'objet d'accusations de la part d'Anthropic et d'OpenAI de « distillation », c'est-à-dire de copie pure et simple, de leurs modèles d'IA.
Article connexe
 Les États-Unis imposent des sanctions à des entreprises chinoises d’intelligence artificielle pour des motifs liés à la propriété intellectuelle
Mardi, le secrétaire au Trésor, Scott Bessent, a annoncé que le gouvernement américain examinerait les modèles open source chinois pour détecter d’éventuels vols de propriété intellectuelle, avertissant de sanctions contre les entreprises chinoises d
Pourquoi je ne peux m'empêcher de soutenir Arcee, ce petit développeur d'IA open source
Arcee, une start-up américaine de 26 personnes, a dévoilé son tout dernier modèle de raisonnement, « Trinity Large Thinking », développé avec un budget modeste de 20 millions de dollars pour un LLM op
Satya Nadella adresse un avertissement sévère aux entreprises qui utilisent l'IA
Parmi les nombreux débats concernant les inconvénients potentiels de l’IA, une crainte préoccupe particulièrement les passionnés d’IA de la Silicon Valley : celle que les grands laboratoires d’IA vend
Recommandations de sujets spéciaux liés
chatbot
 Meilleures applications de chat de jeu de rôle par IA pour la pratique des langues, la préparation aux entretiens et la fluidité quotidienne
2026 Dernières Meilleures Applications de Chat IA pour le Jeu de Rôle, les plus bien notées pour la Pratique des Langues, la Préparation aux Entretiens et la Fluidité Quotidienne ! XIX.AI sélectionne une collection puissante et révolutionnaire qui propose une comparaison gratuit vs payant, des tests en conditions réelles et des classements mis à jour chaque semaine. Ces outils à essayer absolument vous aident à améliorer vos compétences en écriture, à surmonter les défis de fluidité et à optimiser l’efficacité de la communication dans tous les scénarios quotidiens. Explorez dès maintenant pour découvrir l’outil parfait pour votre progression linguistique !
 10 outils
 xix.ai
Composition musicale
Outils de séparation des pistes audio par IA pour la production de remix, la préparation de samples et les masters de karaoké
2026 : Les meilleures et plus récentes outils de séparation des pistes audio par IA, hautement notés, sélectionnés spécialement pour la production de remix, la préparation de samples et l’enregistrement de karaokés. Ces outils puissants et révolutionnaires, éprouvés dans des conditions réelles, permettent une isolation audio précise, ce qui améliore considérablement la productivité. XIX.AI propose un guide de comparaison gratuit mis à jour chaque semaine entre les versions payantes et gratuites, afin de vous aider à trouver la solution idéale adaptée à vos besoins. Découvrez-les dès maintenant pour tirer parti des avantages offerts par l’IA.
8 outils
xix.ai
Analyse des données
Copilotes SQL basés sur l’IA pour les tableaux de bord de chiffre d’affaires, l’analyse des funnels et les indicateurs de produits
2026 : Les meilleurs copilotes AI SQL actuels, classés parmi les plus performants ! XIX.AI a sélectionné une collection puissante et révolutionnaire, mise à jour chaque semaine grâce à des tests concrets. Ces outils indispensables vous aident à créer des tableaux de bord financiers précis, à analyser les canaux de vente et à suivre en temps réel les indicateurs produits, ce qui améliore considérablement votre productivité. Découvrez-les dès maintenant pour trouver l’outil idéal pour des décisions basées sur les données ! 238 caractères
9 outils
xix.ai
Composition musicale
Meilleurs outils d’écriture de mélodies par IA pour les ébauches de chansons
2026 Derniers Meilleurs Outils d’Écriture de Mélodie par IA les Mieux Notés pour des Ébauches de Chansons ! XIX.AI a sélectionné une collection hautement puissante et révolutionnaire, soumise à des tests rigoureux en conditions réelles, afin d’offrir la meilleure expérience d’écriture. Vous pouvez y trouver des comparaisons détaillées entre versions gratuites et payantes, des classements précis, ainsi que des options incontournables conçues pour vous aider à créer sans effort des ébauches de chansons remarquables et à booster significativement votre productivité créative. Explorez dès maintenant pour découvrir l’outil qui vous correspond parfaitement !
8 outils
xix.ai
chatbot
Meilleurs outils d’entraînement à la conversation par IA pour la préparation aux entretiens
Les derniers outils de formation à la conversation par IA les mieux notés pour 2026 sont disponibles sur XIX.AI ! Cette sélection rigoureuse propose des outils puissants et révolutionnaires, testés rigoureusement dans des conditions réelles pour fournir des retours précis. Vous y trouverez une comparaison entre les versions gratuites et payantes, ainsi que des classements détaillés pour vous aider à choisir l’option incontournable qui renforce votre confiance et vos compétences. Explorez dès maintenant pour découvrir l’outil parfait pour réussir vos entretiens !
12 outils
xix.ai
Conception et art
Les meilleurs outils de transfert de style basés sur l'IA pour des expériences créatives
Les meilleurs outils de transfert de style par IA de 2026, les mieux notés, pour des expériences créatives ! XIX.AI a sélectionné une collection d’outils puissants et révolutionnaires à essayer absolument, qui offrent des résultats exceptionnels grâce à des tests en conditions réelles et à un classement rigoureux. Ces solutions de pointe aident les créatifs à booster considérablement leur productivité en accélérant la création de contenu et en ouvrant la voie à des possibilités créatives infinies. Découvrez-les dès maintenant pour trouver l'outil qui vous convient le mieux et commencez à créer dès aujourd'hui !
9 outils
xix.ai

 commentaires (0)
Le laboratoire chinois d'IA DeepSeek a publié deux versions préliminaires de son tout dernier grand modèle linguistique, DeepSeek V4, une mise à jour très attendue du modèle V3.2 de l'année dernière et du modèle de raisonnement R1 qui l'accompagnait, lesquels avaient eu un impact considérable au sein de la communauté de l'IA.
La société indique que DeepSeek V4 Flash et V4 Pro sont tous deux des modèles de type « mixture-of-experts », chacun disposant d'une fenêtre contextuelle d'un million de tokens, ce qui est suffisant pour traiter des bases de code ou des documents volumineux dans le cadre de requêtes. Cette méthode « mixture-of-experts » n'active qu'un sous-ensemble spécifique de paramètres par tâche afin de réduire les coûts d'inférence.
Le modèle Pro compte au total 1,6 billion de paramètres (dont 49 milliards actifs), ce qui en fait le plus grand modèle à poids ouvert disponible. Il surpasse des concurrents tels que Kimi K 2.6 de Moonshot AI (1,1 billion), M1 de MiniMax (456 milliards) et dépasse de plus du double la taille de DeepSeek V3.2 (671 milliards). Le modèle V4 Flash, plus petit, contient 284 milliards de paramètres (dont 13 milliards actifs).
DeepSeek affirme que les améliorations architecturales rendent ces deux nouveaux modèles plus efficaces et plus performants que DeepSeek V3.2, « comblant presque l'écart » avec les modèles de pointe actuels, qu'ils soient open source ou propriétaires, sur les benchmarks de raisonnement.
Le laboratoire indique que son nouveau modèle V4-Pro-Max surpasse ses homologues open source sur les benchmarks de raisonnement et dépasse les performances du GPT-5.2 et du Gemini 3.0 Pro d’OpenAI sur certaines tâches. Dans les benchmarks de concours de codage, DeepSeek affirme que les performances des deux modèles V4 sont « comparables à celles du GPT-5.4 ».
Cependant, les modèles semblent légèrement à la traîne par rapport aux modèles de pointe dans les évaluations basées sur les connaissances, en particulier lorsqu'on les compare au GPT-5.4 d'OpenAI et au dernier Google Gemini 3.1 Pro. Cet écart indique une « trajectoire de développement qui accuse un retard d'environ 3 à 6 mois par rapport aux modèles de pointe », selon le laboratoire.
Contrairement à de nombreux modèles à code source fermé qui prennent en charge la génération d'audio, de vidéo et d'images, V4 Flash et V4 Pro sont tous deux des modèles exclusivement textuels.
Un avantage clé est que DeepSeek V4 est nettement plus rentable que les modèles de pointe actuels. Le plus petit modèle, V4 Flash, est proposé à 0,14 $ par million de tokens d'entrée et 0,28 $ par million de tokens de sortie, ce qui est moins cher que le GPT-5.4 Nano, le Gemini 3.1 Flash, le GPT-5.4 Mini et le Claude Haiku 4.5. Le modèle V4 Pro, plus grand, coûte 0,145 $ par million de tokens d'entrée et 3,48 $ par million de tokens de sortie, proposant également des tarifs inférieurs à ceux de Gemini 3.1 Pro, GPT-5.5, Claude Opus 4.7 et GPT-5.4.
Ce lancement intervient un jour après que les États-Unis ont accusé la Chine de se livrer à un vol de propriété intellectuelle à l'échelle industrielle auprès de laboratoires américains d'IA en utilisant des milliers de comptes proxy. DeepSeek a lui-même fait l'objet d'accusations de la part d'Anthropic et d'OpenAI de « distillation », c'est-à-dire de copie pure et simple, de leurs modèles d'IA.








 Les États-Unis imposent des sanctions à des entreprises chinoises d’intelligence artificielle pour des motifs liés à la propriété intellectuelle
Mardi, le secrétaire au Trésor, Scott Bessent, a annoncé que le gouvernement américain examinerait les modèles open source chinois pour détecter d’éventuels vols de propriété intellectuelle, avertissant de sanctions contre les entreprises chinoises d
 Pourquoi je ne peux m'empêcher de soutenir Arcee, ce petit développeur d'IA open source
Arcee, une start-up américaine de 26 personnes, a dévoilé son tout dernier modèle de raisonnement, « Trinity Large Thinking », développé avec un budget modeste de 20 millions de dollars pour un LLM op
 Satya Nadella adresse un avertissement sévère aux entreprises qui utilisent l'IA
Parmi les nombreux débats concernant les inconvénients potentiels de l’IA, une crainte préoccupe particulièrement les passionnés d’IA de la Silicon Valley : celle que les grands laboratoires d’IA vend

2026 Dernières Meilleures Applications de Chat IA pour le Jeu de Rôle, les plus bien notées pour la Pratique des Langues, la Préparation aux Entretiens et la Fluidité Quotidienne ! XIX.AI sélectionne une collection puissante et révolutionnaire qui propose une comparaison gratuit vs payant, des tests en conditions réelles et des classements mis à jour chaque semaine. Ces outils à essayer absolument vous aident à améliorer vos compétences en écriture, à surmonter les défis de fluidité et à optimiser l’efficacité de la communication dans tous les scénarios quotidiens. Explorez dès maintenant pour découvrir l’outil parfait pour votre progression linguistique !
10 outils
xix.ai

2026 : Les meilleures et plus récentes outils de séparation des pistes audio par IA, hautement notés, sélectionnés spécialement pour la production de remix, la préparation de samples et l’enregistrement de karaokés. Ces outils puissants et révolutionnaires, éprouvés dans des conditions réelles, permettent une isolation audio précise, ce qui améliore considérablement la productivité. XIX.AI propose un guide de comparaison gratuit mis à jour chaque semaine entre les versions payantes et gratuites, afin de vous aider à trouver la solution idéale adaptée à vos besoins. Découvrez-les dès maintenant pour tirer parti des avantages offerts par l’IA.
8 outils
xix.ai

2026 : Les meilleurs copilotes AI SQL actuels, classés parmi les plus performants ! XIX.AI a sélectionné une collection puissante et révolutionnaire, mise à jour chaque semaine grâce à des tests concrets. Ces outils indispensables vous aident à créer des tableaux de bord financiers précis, à analyser les canaux de vente et à suivre en temps réel les indicateurs produits, ce qui améliore considérablement votre productivité. Découvrez-les dès maintenant pour trouver l’outil idéal pour des décisions basées sur les données ! 238 caractères
9 outils
xix.ai

2026 Derniers Meilleurs Outils d’Écriture de Mélodie par IA les Mieux Notés pour des Ébauches de Chansons ! XIX.AI a sélectionné une collection hautement puissante et révolutionnaire, soumise à des tests rigoureux en conditions réelles, afin d’offrir la meilleure expérience d’écriture. Vous pouvez y trouver des comparaisons détaillées entre versions gratuites et payantes, des classements précis, ainsi que des options incontournables conçues pour vous aider à créer sans effort des ébauches de chansons remarquables et à booster significativement votre productivité créative. Explorez dès maintenant pour découvrir l’outil qui vous correspond parfaitement !
8 outils
xix.ai

Les derniers outils de formation à la conversation par IA les mieux notés pour 2026 sont disponibles sur XIX.AI ! Cette sélection rigoureuse propose des outils puissants et révolutionnaires, testés rigoureusement dans des conditions réelles pour fournir des retours précis. Vous y trouverez une comparaison entre les versions gratuites et payantes, ainsi que des classements détaillés pour vous aider à choisir l’option incontournable qui renforce votre confiance et vos compétences. Explorez dès maintenant pour découvrir l’outil parfait pour réussir vos entretiens !
12 outils
xix.ai

Les meilleurs outils de transfert de style par IA de 2026, les mieux notés, pour des expériences créatives ! XIX.AI a sélectionné une collection d’outils puissants et révolutionnaires à essayer absolument, qui offrent des résultats exceptionnels grâce à des tests en conditions réelles et à un classement rigoureux. Ces solutions de pointe aident les créatifs à booster considérablement leur productivité en accélérant la création de contenu et en ouvrant la voie à des possibilités créatives infinies. Découvrez-les dès maintenant pour trouver l'outil qui vous convient le mieux et commencez à créer dès aujourd'hui !
9 outils
xix.ai












