


 Hogar
DeepSeek presenta un modelo de IA que rivaliza con los sistemas de vanguardia
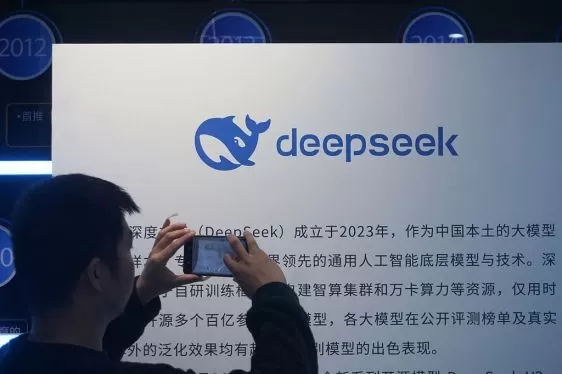
El laboratorio chino de IA DeepSeek ha lanzado dos versiones preliminares de su último modelo de lenguaje a gran escala, DeepSeek V4, una actualización muy esperada del modelo V3.2 del año pasado y del modelo de razonamiento R1 que lo acompañaba, los cuales causaron un gran impacto en la comunidad de la IA.
La empresa afirma que tanto DeepSeek V4 Flash como V4 Pro son modelos de «mezcla de expertos», cada uno con una ventana de contexto de 1 millón de tokens, suficiente para procesar extensas bases de código o documentos dentro de las indicaciones. Este método de «mezcla de expertos» activa solo un subconjunto específico de parámetros por tarea para reducir los costes de inferencia.
El modelo Pro cuenta con un total de 1,6 billones de parámetros (con 49 000 millones activos), lo que lo posiciona como el modelo de peso abierto más grande disponible. Supera a competidores como el Kimi K 2.6 de Moonshot AI (1,1 billones), el M1 de MiniMax (456 000 millones) y duplica con creces el tamaño de DeepSeek V3.2 (671 000 millones). El modelo V4 Flash, más pequeño, contiene 284 000 millones de parámetros (13 000 millones activos).
DeepSeek afirma que las mejoras arquitectónicas hacen que ambos nuevos modelos sean más eficientes y tengan un mayor rendimiento que DeepSeek V3.2, «cerrando casi la brecha» con los modelos líderes actuales, tanto de código abierto como cerrado, en pruebas de razonamiento.
El laboratorio informa de que su nuevo modelo V4-Pro-Max supera a sus homólogos de código abierto en las pruebas de razonamiento y supera el rendimiento de GPT-5.2 y Gemini 3.0 Pro de OpenAI en determinadas tareas. En las pruebas de competición de programación, DeepSeek afirma que el rendimiento de ambos modelos V4 es «comparable al de GPT-5.4».
Sin embargo, los modelos parecen quedarse ligeramente por detrás de los modelos de vanguardia en las evaluaciones basadas en el conocimiento, concretamente en comparación con el GPT-5.4 de OpenAI y el último Google Gemini 3.1 Pro. Esta brecha indica una «trayectoria de desarrollo que va por detrás de los modelos de vanguardia de última generación en aproximadamente entre 3 y 6 meses», según el laboratorio.
A diferencia de muchos modelos de código cerrado que admiten la generación de audio, vídeo e imágenes, tanto V4 Flash como V4 Pro son modelos de solo texto.
Una ventaja clave es que DeepSeek V4 es significativamente más rentable que los modelos de vanguardia actuales. El modelo más pequeño, V4 Flash, tiene un precio de 0,14 dólares por millón de tokens de entrada y 0,28 dólares por millón de tokens de salida, lo que lo sitúa por debajo de GPT-5.4 Nano, Gemini 3.1 Flash, GPT-5.4 Mini y Claude Haiku 4.5. El modelo V4 Pro, de mayor tamaño, cuesta 0,145 dólares por millón de tokens de entrada y 3,48 dólares por millón de tokens de salida, ofreciendo también tarifas más bajas que Gemini 3.1 Pro, GPT-5.5, Claude Opus 4.7 y GPT-5.4.
Este lanzamiento se produce un día después de que Estados Unidos acusara a China de llevar a cabo un robo de propiedad intelectual a escala industrial de los laboratorios de IA estadounidenses utilizando miles de cuentas proxy. La propia DeepSeek se ha enfrentado a acusaciones de Anthropic y OpenAI de «destilar», o básicamente copiar, sus modelos de IA.
Artículo relacionado
 Estados Unidos impone sanciones a empresas chinas de inteligencia artificial por preocupaciones sobre la propiedad intelectual
El martes, el secretario del Tesoro, Scott Bessent, anunció que el gobierno de Estados Unidos examinaría los modelos de código abierto procedentes de China en busca de posibles robos de propiedad intelectual, advirtiendo de sanciones contra empresas
Por qué no puedo evitar animar a Arcee, esa pequeña empresa de IA de código abierto
Arcee, una pequeña startup estadounidense formada por 26 personas, ha presentado su último modelo de razonamiento, «Trinity Large Thinking», desarrollado con un presupuesto modesto de 20 millones de d
Satya Nadella lanza una severa advertencia a las empresas que utilizan la inteligencia artificial
Entre los numerosos debates que giran en torno a los posibles inconvenientes de la IA, hay una cuestión que preocupa especialmente a los entusiastas de la IA de Silicon Valley: que los principales lab
Recomendaciones de temas especiales relacionados
composicion musical
 Mejores herramientas de IA para escribir melodías en borradores de canciones
2026 Últimas Mejores Herramientas de Escritura de Melodías con IA Mejor Valoradas para Borradores de Canciones. XIX.AI ha curado una colección altamente poderosa y transformadora que ha pasado por rigurosas pruebas en el mundo real para ofrecer la mejor experiencia de escritura. Puedes encontrar comparaciones detalladas entre versiones gratuitas y de pago, clasificaciones precisas y opciones imperdibles diseñadas para ayudarte a crear borradores de canciones impresionantes sin esfuerzo y aumentar significativamente tu productividad creativa. ¡Explora ahora para descubrir tu herramienta perfecta!
 8 herramientas
 xix.ai
chatbot
Mejores herramientas de entrenamiento de conversación con IA para practicar entrevistas
¡Las mejores herramientas de entrenamiento de conversación con IA para prácticas de entrevistas más recientes y mejor valoradas de 2026 ya están disponibles en XIX.AI! Esta colección seleccionada incluye herramientas poderosas y transformadoras que han pasado por rigurosas pruebas en el mundo real para ofrecer retroalimentación precisa. Encontrarás una comparación entre opciones gratuitas y de pago, así como clasificaciones detalladas para ayudarte a elegir la opción imprescindible que aumente tu confianza y habilidades. ¡Explora ahora para descubrir tu herramienta perfecta para el éxito en las entrevistas!
12 herramientas
xix.ai
Diseño y Arte
Las mejores herramientas de transferencia de estilos con IA para experimentos creativos
¡Las mejores herramientas de transferencia de estilo con IA de 2026, mejor valoradas para experimentos creativos! XIX.AI ha seleccionado una colección de herramientas potentes y revolucionarias que no te puedes perder, capaces de ofrecer resultados excepcionales según pruebas reales y clasificaciones rigurosas. Estas soluciones de primera categoría ayudan a los creativos a aumentar significativamente su productividad, acelerando la creación de contenidos y abriendo un sinfín de posibilidades creativas. ¡Explora ahora mismo para descubrir tu herramienta perfecta y empieza a crear hoy mismo!
9 herramientas
xix.ai
Creación de cómics
Las mejores herramientas de burbujas de diálogo con IA para la narración visual
¡Ya están aquí, en XIX.AI, las mejores herramientas de 2026 con las mejores valoraciones para crear bocadillos de diálogo con IA y contar historias visuales! Esta selección incluye potentes herramientas revolucionarias que ayudan a los creadores a aumentar su productividad y superar los bloqueos creativos. Consulta una comparación entre las versiones gratuitas y de pago, echa un vistazo a las pruebas en condiciones reales y revisa las últimas clasificaciones para encontrar las soluciones imprescindibles, perfectas para crear narrativas visuales cautivadoras. ¡Explora ahora mismo y descubre tu herramienta ideal!
10 herramientas
xix.ai
Asistente de reuniones
Las mejores herramientas de resumen de reuniones con IA: realiza un seguimiento claro de las decisiones y las acciones de seguimiento
Las mejores herramientas de resumen de reuniones con IA de 2026, mejor valoradas para un seguimiento claro de las decisiones y un seguimiento posterior sin esfuerzo. Esta lista seleccionada presenta soluciones potentes y revolucionarias que aumentan drásticamente la productividad al automatizar las notas de las reuniones, identificar las acciones clave y agilizar la coordinación del equipo en todos los proyectos. Consigue una comparación entre las versiones gratuitas y de pago, junto con pruebas en condiciones reales y clasificaciones actualizadas semanalmente, para ayudarte a encontrar la herramienta perfecta. ¡Explora ahora mismo y aprovecha las ventajas de la IA!
9 herramientas
xix.ai
Análisis de datos
Mejores herramientas de limpieza de datos con IA: corrige valores faltantes y duplicados rápidamente
2026: Las mejores herramientas de limpieza de datos basadas en IA, mejor calificadas y más actualizadas, para corregir rápidamente valores faltantes y duplicados. Esta lista cuidadosamente seleccionada presenta soluciones potentes que transforman el trabajo y aumentan significativamente la productividad. Cada opción ha sido sometida a pruebas rigurosas en entornos reales para garantizar su fiabilidad. Obtenga una comparación gratuita entre las opciones gratuitas y de pago y descubra la herramienta imprescindible que mejor se adapte a sus necesidades. Explore ahora en XIX.AI para darle un vantaje con la inteligencia artificial.
11 herramientas
xix.ai

 comentario (0)
0/500
El laboratorio chino de IA DeepSeek ha lanzado dos versiones preliminares de su último modelo de lenguaje a gran escala, DeepSeek V4, una actualización muy esperada del modelo V3.2 del año pasado y del modelo de razonamiento R1 que lo acompañaba, los cuales causaron un gran impacto en la comunidad de la IA.
La empresa afirma que tanto DeepSeek V4 Flash como V4 Pro son modelos de «mezcla de expertos», cada uno con una ventana de contexto de 1 millón de tokens, suficiente para procesar extensas bases de código o documentos dentro de las indicaciones. Este método de «mezcla de expertos» activa solo un subconjunto específico de parámetros por tarea para reducir los costes de inferencia.
El modelo Pro cuenta con un total de 1,6 billones de parámetros (con 49 000 millones activos), lo que lo posiciona como el modelo de peso abierto más grande disponible. Supera a competidores como el Kimi K 2.6 de Moonshot AI (1,1 billones), el M1 de MiniMax (456 000 millones) y duplica con creces el tamaño de DeepSeek V3.2 (671 000 millones). El modelo V4 Flash, más pequeño, contiene 284 000 millones de parámetros (13 000 millones activos).
DeepSeek afirma que las mejoras arquitectónicas hacen que ambos nuevos modelos sean más eficientes y tengan un mayor rendimiento que DeepSeek V3.2, «cerrando casi la brecha» con los modelos líderes actuales, tanto de código abierto como cerrado, en pruebas de razonamiento.
El laboratorio informa de que su nuevo modelo V4-Pro-Max supera a sus homólogos de código abierto en las pruebas de razonamiento y supera el rendimiento de GPT-5.2 y Gemini 3.0 Pro de OpenAI en determinadas tareas. En las pruebas de competición de programación, DeepSeek afirma que el rendimiento de ambos modelos V4 es «comparable al de GPT-5.4».
Sin embargo, los modelos parecen quedarse ligeramente por detrás de los modelos de vanguardia en las evaluaciones basadas en el conocimiento, concretamente en comparación con el GPT-5.4 de OpenAI y el último Google Gemini 3.1 Pro. Esta brecha indica una «trayectoria de desarrollo que va por detrás de los modelos de vanguardia de última generación en aproximadamente entre 3 y 6 meses», según el laboratorio.
A diferencia de muchos modelos de código cerrado que admiten la generación de audio, vídeo e imágenes, tanto V4 Flash como V4 Pro son modelos de solo texto.
Una ventaja clave es que DeepSeek V4 es significativamente más rentable que los modelos de vanguardia actuales. El modelo más pequeño, V4 Flash, tiene un precio de 0,14 dólares por millón de tokens de entrada y 0,28 dólares por millón de tokens de salida, lo que lo sitúa por debajo de GPT-5.4 Nano, Gemini 3.1 Flash, GPT-5.4 Mini y Claude Haiku 4.5. El modelo V4 Pro, de mayor tamaño, cuesta 0,145 dólares por millón de tokens de entrada y 3,48 dólares por millón de tokens de salida, ofreciendo también tarifas más bajas que Gemini 3.1 Pro, GPT-5.5, Claude Opus 4.7 y GPT-5.4.
Este lanzamiento se produce un día después de que Estados Unidos acusara a China de llevar a cabo un robo de propiedad intelectual a escala industrial de los laboratorios de IA estadounidenses utilizando miles de cuentas proxy. La propia DeepSeek se ha enfrentado a acusaciones de Anthropic y OpenAI de «destilar», o básicamente copiar, sus modelos de IA.








 Estados Unidos impone sanciones a empresas chinas de inteligencia artificial por preocupaciones sobre la propiedad intelectual
El martes, el secretario del Tesoro, Scott Bessent, anunció que el gobierno de Estados Unidos examinaría los modelos de código abierto procedentes de China en busca de posibles robos de propiedad intelectual, advirtiendo de sanciones contra empresas
 Por qué no puedo evitar animar a Arcee, esa pequeña empresa de IA de código abierto
Arcee, una pequeña startup estadounidense formada por 26 personas, ha presentado su último modelo de razonamiento, «Trinity Large Thinking», desarrollado con un presupuesto modesto de 20 millones de d
 Satya Nadella lanza una severa advertencia a las empresas que utilizan la inteligencia artificial
Entre los numerosos debates que giran en torno a los posibles inconvenientes de la IA, hay una cuestión que preocupa especialmente a los entusiastas de la IA de Silicon Valley: que los principales lab

2026 Últimas Mejores Herramientas de Escritura de Melodías con IA Mejor Valoradas para Borradores de Canciones. XIX.AI ha curado una colección altamente poderosa y transformadora que ha pasado por rigurosas pruebas en el mundo real para ofrecer la mejor experiencia de escritura. Puedes encontrar comparaciones detalladas entre versiones gratuitas y de pago, clasificaciones precisas y opciones imperdibles diseñadas para ayudarte a crear borradores de canciones impresionantes sin esfuerzo y aumentar significativamente tu productividad creativa. ¡Explora ahora para descubrir tu herramienta perfecta!
8 herramientas
xix.ai

¡Las mejores herramientas de entrenamiento de conversación con IA para prácticas de entrevistas más recientes y mejor valoradas de 2026 ya están disponibles en XIX.AI! Esta colección seleccionada incluye herramientas poderosas y transformadoras que han pasado por rigurosas pruebas en el mundo real para ofrecer retroalimentación precisa. Encontrarás una comparación entre opciones gratuitas y de pago, así como clasificaciones detalladas para ayudarte a elegir la opción imprescindible que aumente tu confianza y habilidades. ¡Explora ahora para descubrir tu herramienta perfecta para el éxito en las entrevistas!
12 herramientas
xix.ai

¡Las mejores herramientas de transferencia de estilo con IA de 2026, mejor valoradas para experimentos creativos! XIX.AI ha seleccionado una colección de herramientas potentes y revolucionarias que no te puedes perder, capaces de ofrecer resultados excepcionales según pruebas reales y clasificaciones rigurosas. Estas soluciones de primera categoría ayudan a los creativos a aumentar significativamente su productividad, acelerando la creación de contenidos y abriendo un sinfín de posibilidades creativas. ¡Explora ahora mismo para descubrir tu herramienta perfecta y empieza a crear hoy mismo!
9 herramientas
xix.ai

¡Ya están aquí, en XIX.AI, las mejores herramientas de 2026 con las mejores valoraciones para crear bocadillos de diálogo con IA y contar historias visuales! Esta selección incluye potentes herramientas revolucionarias que ayudan a los creadores a aumentar su productividad y superar los bloqueos creativos. Consulta una comparación entre las versiones gratuitas y de pago, echa un vistazo a las pruebas en condiciones reales y revisa las últimas clasificaciones para encontrar las soluciones imprescindibles, perfectas para crear narrativas visuales cautivadoras. ¡Explora ahora mismo y descubre tu herramienta ideal!
10 herramientas
xix.ai

Las mejores herramientas de resumen de reuniones con IA de 2026, mejor valoradas para un seguimiento claro de las decisiones y un seguimiento posterior sin esfuerzo. Esta lista seleccionada presenta soluciones potentes y revolucionarias que aumentan drásticamente la productividad al automatizar las notas de las reuniones, identificar las acciones clave y agilizar la coordinación del equipo en todos los proyectos. Consigue una comparación entre las versiones gratuitas y de pago, junto con pruebas en condiciones reales y clasificaciones actualizadas semanalmente, para ayudarte a encontrar la herramienta perfecta. ¡Explora ahora mismo y aprovecha las ventajas de la IA!
9 herramientas
xix.ai

2026: Las mejores herramientas de limpieza de datos basadas en IA, mejor calificadas y más actualizadas, para corregir rápidamente valores faltantes y duplicados. Esta lista cuidadosamente seleccionada presenta soluciones potentes que transforman el trabajo y aumentan significativamente la productividad. Cada opción ha sido sometida a pruebas rigurosas en entornos reales para garantizar su fiabilidad. Obtenga una comparación gratuita entre las opciones gratuitas y de pago y descubra la herramienta imprescindible que mejor se adapte a sus necesidades. Explore ahora en XIX.AI para darle un vantaje con la inteligencia artificial.
11 herramientas
xix.ai












