


 Maison
Ant Group dévoile F2LLM-v2 : un modèle d'intégration multilingue à grande échelle
Surmonter la limite dite « centrée sur l'anglais » dans la représentation sémantique est devenu un enjeu majeur dans l'évolution des grands modèles linguistiques.
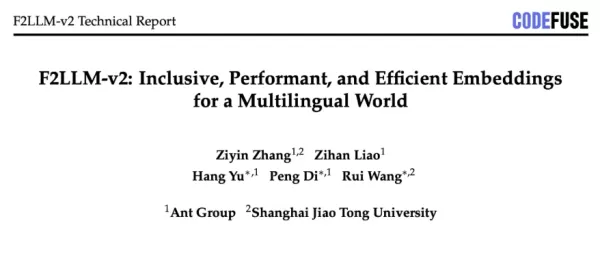
Le 26 mars, l'équipe CodeFuse d'Ant Group et de l'université Jiao Tong de Shanghai a officiellement lancé la série de modèles d'embedding F2LLM-v2. Cette série a non seulement atteint des performances de pointe dans des benchmarks de référence, mais elle offre également une solution de représentation sémantique performante et efficace aux développeurs du monde entier grâce à une approche entièrement open source.
Des performances exceptionnelles : 11 résultats SOTA sur MTEB
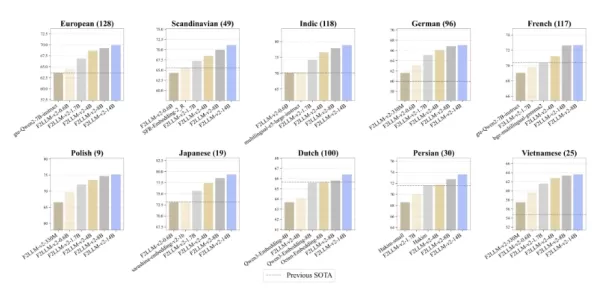
Dans le benchmark MTEB de référence pour l'évaluation des modèles d'embedding, F2LLM-v2 a démontré des atouts globaux :
11 premières places : il s'est classé en tête de 11 classements spécifiques à des langues et à des domaines, notamment l'allemand, le français, le japonais et la recherche de code.
Un challenger redoutable : même ses variantes allégées ont systématiquement surpassé des modèles industriels bien connus de taille comparable.
Couverture étendue : l'évaluation a porté sur 430 sous-tâches diverses, telles que les questions-réponses médicales et la recherche de code, couvrant ainsi l'ensemble des scénarios.
Une compréhension globale : maîtrise de 282 langues naturelles et de plus de 40 langages de programmation
La puissance de F2LLM-v2 découle de sa base d'entraînement hautement inclusive :
Amélioration multilingue : il offre une prise en charge renforcée des langues à ressources moyennes et faibles (telles que les familles de langues nordiques et d'Asie du Sud-Est), permettant une véritable couverture linguistique mondiale.
Expertise en programmation : grâce à sa compréhension approfondie de plus de 40 langages de programmation tels que Python, Java et Go, il constitue le choix idéal pour les développeurs qui créent des systèmes RAG (Retrieval-Augmented Generation) et des assistants de code.
Données de haute qualité : S'appuyant sur 60 millions d'échantillons publics méticuleusement nettoyés, il garantit à la fois la pureté et l'étendue de la base de connaissances du modèle.
Une efficacité extrême : une famille complète de modèles allant de 80 millions à 14 milliards de paramètres
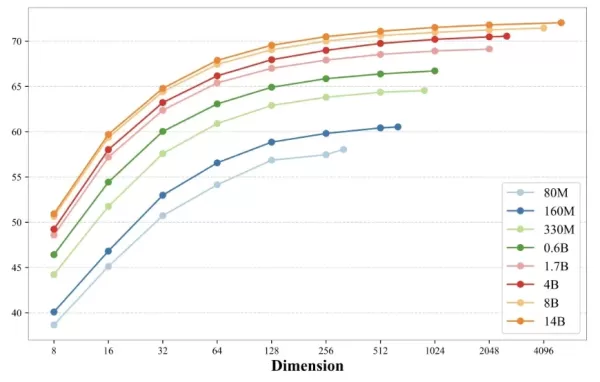
Pour répondre à des besoins allant des appareils mobiles au cloud computing, l'équipe CodeFuse a développé une matrice de modèles complète :
Optimisation pour les mobiles : des modèles compacts de 80 millions à 330 millions de paramètres utilisent des techniques de « model pruning » et de « knowledge distillation », permettant un fonctionnement fluide sur les plateformes mobiles.
Innovation « imbriquée » : elle prend en charge l'ajustement dynamique des dimensions, permettant aux utilisateurs de basculer de manière flexible entre 8 dimensions et toutes les dimensions, optimisant ainsi le compromis entre vitesse d'inférence et coût de stockage.
Entièrement open source : la transparence établit une nouvelle norme communautaire
Contrairement à de nombreux modèles de type « boîte noire », F2LLM-v2 s'engage dans une philosophie entièrement open source :
Publication complète : tous les poids du modèle pour chaque variante de taille sont disponibles au téléchargement.
Transparence détaillée : un rapport technique complet est publié, dévoilant l'intégralité de la méthodologie d'entraînement.
Reproductibilité totale : tous les codes et points de contrôle de l'entraînement sont publiés, permettant aux chercheurs du monde entier de s'appuyer sur ces travaux pour poursuivre le développement.
Conclusion : repousser les limites pour explorer le potentiel infini de l'IA
Nouvelle étape importante de la série CodeFuse Open Source, la publication de F2LLM-v2
Article connexe
 Stripe va acquérir OpenRouter alors que le routage basé sur des modèles d'IA prend de l'ampleur
Stripe a conclu un accord en vue d’acquérir OpenRouter, une plateforme de routage de modèles d’IA qui permet aux développeurs d’accéder à des centaines de modèles via une interface unique. Cette acqui
Barrett Zoph, ancien chercheur chez OpenAI, revient chez Google pour contribuer au développement de Gemini
Barret Zoph, qui avait auparavant quitté brusquement l’entreprise pour rejoindre OpenAI en raison d’un désaccord avec Miriam Mularati, PDG de Thinking Machines Lab, a une nouvelle fois changé d’employ
Comment Recursive Intelligence a levé 335 millions de dollars en 4 mois, avec une valorisation de 4 milliards de dollars
Les cofondatrices de la start-up Ricursive Intelligence semblaient destinées à devenir cofondatrices.Anna Goldie, PDG, et Azalia Mirhoseini, directrice technique, sont si connues dans le milieu de l’I
Recommandations de sujets spéciaux liés
Conception et art
 Les meilleurs outils d'illustration basés sur l'IA : créez plus rapidement des scènes éditoriales et des illustrations de couverture
Les meilleurs outils d'illustration IA de 2026 : notre sélection regroupe les outils les plus performants pour créer rapidement de superbes scènes éditoriales et des couvertures accrocheuses. Chaque option a été soumise à des tests rigoureux en conditions réelles ; nous vous proposons une comparaison entre les versions gratuites et payantes afin de vous aider à trouver celle qui correspond le mieux à votre flux de travail. Essayez dès aujourd’hui ces solutions incontournables pour exploiter pleinement le potentiel de l’IA et booster votre productivité créative. Découvrez-les dès maintenant sur XIX.AI.
 10 outils
 xix.ai
Éducation et apprentissage
Les meilleurs professeurs particuliers spécialisés en IA pour la préparation aux examens : entraînez-vous en maths, en sciences et en anglais
Les meilleurs tuteurs IA 2026 les mieux notés pour la préparation aux examens sont disponibles ici, sur XIX.AI ! Notre sélection comprend des outils puissants et révolutionnaires qui proposent une comparaison entre les versions gratuites et payantes, des tests concrets et des classements mis à jour chaque semaine. Ils vous aident à améliorer votre efficacité à l'écrit, à simplifier l'apprentissage de sujets complexes et à libérer votre potentiel académique. Découvrez dès maintenant l'outil de préparation aux examens qui vous convient le mieux et commencez à créer dès aujourd'hui pour exploiter pleinement les avantages de l'IA !
10 outils
xix.ai
Finance
Outils de planification budgétaire par IA pour la gestion personnelle des finances
2026 Derniers Meilleurs Outils de Planification Budgétaire par IA les mieux notés pour la gestion personnelle des finances sont ici sur XIX.AI ! Cette collection soigneusement sélectionnée propose des solutions puissantes et révolutionnaires qui vous aident à réaliser des tests concrets, à comprendre vos habitudes de dépenses et à créer des plans personnalisés pour améliorer votre productivité. Profitez d’une comparaison entre versions gratuites et payantes ainsi que de classements détaillés. Des outils incontournables conçus pour simplifier la gestion financière et exploiter pleinement votre avantage grâce à l’IA. Explorez dès maintenant !
11 outils
xix.ai
Santé et bien-être
Assistants de suivi du sommeil par l’IA : améliorez votre récupération grâce à de meilleures habitudes avant le coucher
2026 : Découvrez les meilleurs assistants de suivi du sommeil basés sur l’IA, hautement notés et récemment mis à jour, conçus pour une récupération optimale. Ce guide hebdomadaire entièrement actualisé présente des outils puissants qui offrent des tests en conditions réelles, des comparaisons entre versions gratuites et payantes, ainsi que des classements détaillés afin de vous aider à trouver la solution idéale pour améliorer la qualité du sommeil et favoriser de meilleures habitudes avant le coucher. Explorez-le dès maintenant sur XIX.AI pour tirer parti des avantages offerts par l’IA.
10 outils
xix.ai
Analyse des données
Copilotes SQL basés sur l'IA pour l'analyse des produits et du chiffre d'affaires
2026 : les meilleurs copilotes SQL IA les mieux notés pour l'analyse des produits et du chiffre d'affaires ! XIX.AI a sélectionné une gamme d’outils puissants et révolutionnaires à essayer absolument, qui sont soumis à des tests en conditions réelles via des classements mis à jour chaque semaine. Ces outils aident les utilisateurs à booster considérablement leur productivité en accélérant l’analyse des données, en simplifiant les requêtes complexes et en générant des informations précises permettant de prendre des décisions commerciales plus éclairées. Explorez-les dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer pleinement parti de l’IA !
14 outils
xix.ai
Éducation et apprentissage
Les meilleurs outils d'aide aux devoirs basés sur l'IA qui enseignent : apprenez les concepts, pas seulement les réponses
2026 : les meilleurs outils d'aide aux devoirs basés sur l'IA, les mieux notés, qui enseignent les concepts fondamentaux et ne se contentent pas de fournir des réponses. Des outils puissants pour les élèves. Une sélection incontournable à ne pas manquer. Mise à jour hebdomadaire. Comparaison entre les versions gratuites et payantes. Tests en conditions réelles. Classements précis pour vous aider à exploiter pleinement votre potentiel d'apprentissage. Explorez dès maintenant pour découvrir l'outil idéal qui vous permettra d'étudier plus efficacement.
10 outils
xix.ai

 commentaires (0)
Surmonter la limite dite « centrée sur l'anglais » dans la représentation sémantique est devenu un enjeu majeur dans l'évolution des grands modèles linguistiques.
Le 26 mars, l'équipe CodeFuse d'Ant Group et de l'université Jiao Tong de Shanghai a officiellement lancé la série de modèles d'embedding F2LLM-v2. Cette série a non seulement atteint des performances de pointe dans des benchmarks de référence, mais elle offre également une solution de représentation sémantique performante et efficace aux développeurs du monde entier grâce à une approche entièrement open source.
Des performances exceptionnelles : 11 résultats SOTA sur MTEB
Dans le benchmark MTEB de référence pour l'évaluation des modèles d'embedding, F2LLM-v2 a démontré des atouts globaux :
11 premières places : il s'est classé en tête de 11 classements spécifiques à des langues et à des domaines, notamment l'allemand, le français, le japonais et la recherche de code.
Un challenger redoutable : même ses variantes allégées ont systématiquement surpassé des modèles industriels bien connus de taille comparable.
Couverture étendue : l'évaluation a porté sur 430 sous-tâches diverses, telles que les questions-réponses médicales et la recherche de code, couvrant ainsi l'ensemble des scénarios.
Une compréhension globale : maîtrise de 282 langues naturelles et de plus de 40 langages de programmation
La puissance de F2LLM-v2 découle de sa base d'entraînement hautement inclusive :
Amélioration multilingue : il offre une prise en charge renforcée des langues à ressources moyennes et faibles (telles que les familles de langues nordiques et d'Asie du Sud-Est), permettant une véritable couverture linguistique mondiale.
Expertise en programmation : grâce à sa compréhension approfondie de plus de 40 langages de programmation tels que Python, Java et Go, il constitue le choix idéal pour les développeurs qui créent des systèmes RAG (Retrieval-Augmented Generation) et des assistants de code.
Données de haute qualité : S'appuyant sur 60 millions d'échantillons publics méticuleusement nettoyés, il garantit à la fois la pureté et l'étendue de la base de connaissances du modèle.
Une efficacité extrême : une famille complète de modèles allant de 80 millions à 14 milliards de paramètres
Pour répondre à des besoins allant des appareils mobiles au cloud computing, l'équipe CodeFuse a développé une matrice de modèles complète :
Optimisation pour les mobiles : des modèles compacts de 80 millions à 330 millions de paramètres utilisent des techniques de « model pruning » et de « knowledge distillation », permettant un fonctionnement fluide sur les plateformes mobiles.
Innovation « imbriquée » : elle prend en charge l'ajustement dynamique des dimensions, permettant aux utilisateurs de basculer de manière flexible entre 8 dimensions et toutes les dimensions, optimisant ainsi le compromis entre vitesse d'inférence et coût de stockage.
Entièrement open source : la transparence établit une nouvelle norme communautaire
Contrairement à de nombreux modèles de type « boîte noire », F2LLM-v2 s'engage dans une philosophie entièrement open source :
Publication complète : tous les poids du modèle pour chaque variante de taille sont disponibles au téléchargement.
Transparence détaillée : un rapport technique complet est publié, dévoilant l'intégralité de la méthodologie d'entraînement.
Reproductibilité totale : tous les codes et points de contrôle de l'entraînement sont publiés, permettant aux chercheurs du monde entier de s'appuyer sur ces travaux pour poursuivre le développement.
Conclusion : repousser les limites pour explorer le potentiel infini de l'IA
Nouvelle étape importante de la série CodeFuse Open Source, la publication de F2LLM-v2








 Stripe va acquérir OpenRouter alors que le routage basé sur des modèles d'IA prend de l'ampleur
Stripe a conclu un accord en vue d’acquérir OpenRouter, une plateforme de routage de modèles d’IA qui permet aux développeurs d’accéder à des centaines de modèles via une interface unique. Cette acqui
 Barrett Zoph, ancien chercheur chez OpenAI, revient chez Google pour contribuer au développement de Gemini
Barret Zoph, qui avait auparavant quitté brusquement l’entreprise pour rejoindre OpenAI en raison d’un désaccord avec Miriam Mularati, PDG de Thinking Machines Lab, a une nouvelle fois changé d’employ
 Comment Recursive Intelligence a levé 335 millions de dollars en 4 mois, avec une valorisation de 4 milliards de dollars
Les cofondatrices de la start-up Ricursive Intelligence semblaient destinées à devenir cofondatrices.Anna Goldie, PDG, et Azalia Mirhoseini, directrice technique, sont si connues dans le milieu de l’I

Les meilleurs outils d'illustration IA de 2026 : notre sélection regroupe les outils les plus performants pour créer rapidement de superbes scènes éditoriales et des couvertures accrocheuses. Chaque option a été soumise à des tests rigoureux en conditions réelles ; nous vous proposons une comparaison entre les versions gratuites et payantes afin de vous aider à trouver celle qui correspond le mieux à votre flux de travail. Essayez dès aujourd’hui ces solutions incontournables pour exploiter pleinement le potentiel de l’IA et booster votre productivité créative. Découvrez-les dès maintenant sur XIX.AI.
10 outils
xix.ai

Les meilleurs tuteurs IA 2026 les mieux notés pour la préparation aux examens sont disponibles ici, sur XIX.AI ! Notre sélection comprend des outils puissants et révolutionnaires qui proposent une comparaison entre les versions gratuites et payantes, des tests concrets et des classements mis à jour chaque semaine. Ils vous aident à améliorer votre efficacité à l'écrit, à simplifier l'apprentissage de sujets complexes et à libérer votre potentiel académique. Découvrez dès maintenant l'outil de préparation aux examens qui vous convient le mieux et commencez à créer dès aujourd'hui pour exploiter pleinement les avantages de l'IA !
10 outils
xix.ai

2026 Derniers Meilleurs Outils de Planification Budgétaire par IA les mieux notés pour la gestion personnelle des finances sont ici sur XIX.AI ! Cette collection soigneusement sélectionnée propose des solutions puissantes et révolutionnaires qui vous aident à réaliser des tests concrets, à comprendre vos habitudes de dépenses et à créer des plans personnalisés pour améliorer votre productivité. Profitez d’une comparaison entre versions gratuites et payantes ainsi que de classements détaillés. Des outils incontournables conçus pour simplifier la gestion financière et exploiter pleinement votre avantage grâce à l’IA. Explorez dès maintenant !
11 outils
xix.ai

2026 : Découvrez les meilleurs assistants de suivi du sommeil basés sur l’IA, hautement notés et récemment mis à jour, conçus pour une récupération optimale. Ce guide hebdomadaire entièrement actualisé présente des outils puissants qui offrent des tests en conditions réelles, des comparaisons entre versions gratuites et payantes, ainsi que des classements détaillés afin de vous aider à trouver la solution idéale pour améliorer la qualité du sommeil et favoriser de meilleures habitudes avant le coucher. Explorez-le dès maintenant sur XIX.AI pour tirer parti des avantages offerts par l’IA.
10 outils
xix.ai

2026 : les meilleurs copilotes SQL IA les mieux notés pour l'analyse des produits et du chiffre d'affaires ! XIX.AI a sélectionné une gamme d’outils puissants et révolutionnaires à essayer absolument, qui sont soumis à des tests en conditions réelles via des classements mis à jour chaque semaine. Ces outils aident les utilisateurs à booster considérablement leur productivité en accélérant l’analyse des données, en simplifiant les requêtes complexes et en générant des informations précises permettant de prendre des décisions commerciales plus éclairées. Explorez-les dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer pleinement parti de l’IA !
14 outils
xix.ai

2026 : les meilleurs outils d'aide aux devoirs basés sur l'IA, les mieux notés, qui enseignent les concepts fondamentaux et ne se contentent pas de fournir des réponses. Des outils puissants pour les élèves. Une sélection incontournable à ne pas manquer. Mise à jour hebdomadaire. Comparaison entre les versions gratuites et payantes. Tests en conditions réelles. Classements précis pour vous aider à exploiter pleinement votre potentiel d'apprentissage. Explorez dès maintenant pour découvrir l'outil idéal qui vous permettra d'étudier plus efficacement.
10 outils
xix.ai












