


 Heim
Ant Group stellt F2LLM-v2 vor: ein mehrsprachiges Embedding-Modell in voller Größe
Die Überwindung der „englischzentrierten“ Einschränkung bei der semantischen Darstellung hat sich zu einer zentralen Herausforderung in der Weiterentwicklung großer Sprachmodelle entwickelt.
Am 26. März veröffentlichte das CodeFuse-Team der Ant Group und der Shanghai Jiao Tong University offiziell die F2LLM-v2-Reihe von Embedding-Modellen. Diese Reihe erzielte nicht nur führende Leistungen in maßgeblichen Benchmarks, sondern bietet Entwicklern weltweit durch einen vollständig quelloffenen Ansatz auch eine leistungsstarke und effiziente Lösung für die semantische Darstellung.
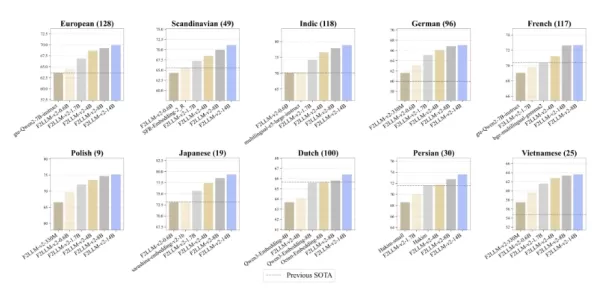
Außergewöhnliche Leistung: 11 SOTA-Ergebnisse bei MTEB
Im maßgeblichen MTEB-Benchmark zur Bewertung von Embedding-Modellen zeigte F2LLM-v2 umfassende Stärken:
11 Spitzenplatzierungen: Es sicherte sich den ersten Platz in 11 sprach- und domänenspezifischen Ranglisten, darunter Deutsch, Französisch, Japanisch und Code-Retrieval.
Ein beeindruckender Herausforderer: Selbst seine schlanken Varianten übertrafen durchweg bekannte Branchenmodelle vergleichbarer Größe.
Umfassende Abdeckung: Die Bewertung umfasste 430 verschiedene Teilaufgaben, wie medizinische Fragen und Antworten sowie Code-Retrieval, und erzielte eine vollständige Szenarioabdeckung.
Umfassendes Verständnis: Beherrschung von 282 natürlichen Sprachen und über 40 Programmiersprachen
Die Leistungsfähigkeit von F2LLM-v2 beruht auf seiner äußerst umfassenden Trainingsgrundlage:
Mehrsprachige Erweiterung: Es bietet verbesserte Unterstützung für Sprachen mit geringen und mittleren Ressourcen (wie nordische und südostasiatische Sprachfamilien) und ermöglicht so eine echte globale Sprachabdeckung.
Programmierkompetenz: Mit einem tiefgreifenden Verständnis von über 40 Programmiersprachen wie Python, Java und Go ist es die ideale Wahl für Entwickler, die RAG-Systeme (Retrieval-Augmented Generation) und Code-Assistenten erstellen.
Hochwertige Daten: Auf der Grundlage von 60 Millionen sorgfältig bereinigten öffentlichen Beispielen gewährleistet es sowohl die Reinheit als auch die Breite der Wissensbasis des Modells.
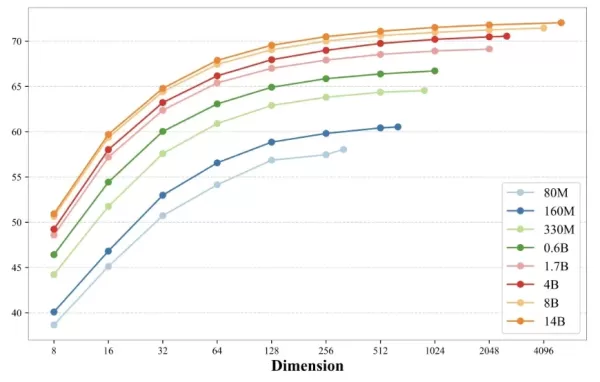
Extreme Effizienz: Eine komplette Modellfamilie mit einer Skalierung von 80 Millionen bis 14 Milliarden Parametern
Um den Anforderungen von Mobilgeräten bis hin zum Cloud-Computing gerecht zu werden, hat das CodeFuse-Team eine umfassende Modellmatrix entwickelt:
Für Mobilgeräte optimiert: Kompakte Modelle mit 80 Mio. bis 330 Mio. Parametern nutzen Techniken wie „Model Pruning“ und „Knowledge Distillation“ und ermöglichen so einen reibungslosen Betrieb auf mobilen Plattformen.
„Verschachtelte“ Innovation: Es unterstützt die dynamische Dimensionsanpassung, sodass Benutzer flexibel zwischen 8 Dimensionen und voller Dimensionen wechseln können, wodurch der Kompromiss zwischen Inferenzgeschwindigkeit und Speicherkosten optimiert wird.
Vollständig Open Source: Transparenz setzt einen neuen Community-Standard
Im Gegensatz zu vielen „Black-Box“-Modellen verfolgt F2LLM-v2 eine vollständig auf Open Source basierende Philosophie:
Vollständige Veröffentlichung: Alle Modellgewichte für jede Größenvariante stehen zum Download bereit.
Detaillierte Transparenz: Es wird ein umfassender technischer Bericht veröffentlicht, der die gesamte Trainingsmethodik offenlegt.
Volle Reproduzierbarkeit: Der gesamte Code und alle Trainings-Checkpoints werden veröffentlicht, sodass Forscher weltweit auf dieser Arbeit aufbauen und sie weiterentwickeln können.
Fazit: Grenzen überwinden, um das unendliche Potenzial der KI zu erkunden
Als weiterer bedeutender Meilenstein in der CodeFuse Open-Source-Reihe ist die Veröffentlichung von F2LLM-v2
Verwandter Artikel
 Apple Smart Glasses könnten auf der WWDC27 vorgestellt werden und dabei den Schutz der Privatsphäre in den Mittelpunkt stellen
Bloombergs Mark Gurman berichtet, dass Apples Smart Glasses mit dem Codenamen N50 im Juni 2027 auf der WWDC27 vorgestellt werden sollen, wobei ein Verkaufsstart im Herbst 2027 erwartet wird. Ursprünglich für Ende dieses Jahres und Anfang 2027 geplant
Inside Details Exposed About Next-Gen Gemini: Strained Computing Power, Internal Teams Disagreed on Development Priorities and Resource Allocation
Berichten zufolge wurde der Start des hocherwarteten Next-Generation-Gemini-Modells von Google verschoben. Interne Uneinigkeiten über Entwicklungsprioritäten und Ressourcenallokation, kombiniert mit begrenzter Rechenkapazität und komplexen Genehmigun
OpenAI entkräftet Bedenken bezüglich des verlangsamen Wachstums und erklärt, dass mehrere Geschäftsbereiche ihre Expansion beschleunigen
Als Reaktion auf externe Kritik bezüglich des nachlassenden Umsatzwachstums und verpasster interner Zielvorgaben gab der KI-Pionier OpenAI am Dienstag, den 28. April, eine selbstbewusste Erklärung ab. Das Unternehmen präzisierte, dass seine Verbrauch
Empfehlungen zu verwandten Spezialthemen
Musikkomposition
 Die besten KI-Tools zum Komponieren von Melodien für Songentwürfe
2026 Neueste Besten Top-Bewerteten KI-Melodie-Schreibtools für Songentwürfe! XIX.AI hat eine hochleistungsfähige, bahnbrechende Kollektion zusammengestellt, die strengen Praxistests unterzogen wurde, um das beste Schreiberlebnis zu liefern. Sie finden detaillierte kostenlose versus kostenpflichtige Vergleiche, präzise Ranglisten und unbedingt auszuprobierende Optionen, die darauf ausgelegt sind, Ihnen zu helfen, beeindruckende Songentwürfe mühelos zu erstellen und Ihre kreative Produktivität erheblich zu steigern. Entdecken Sie jetzt Ihr perfektes Tool!
 8 Tools
 xix.ai
Chatbot
Die besten KI-gestützten Gesprächstrainingstools für Vorstellungsgesprächspraxis
2026 Neueste Besten Top-bewerteten KI-Konversationstrainer-Tools für Vorstellungsgesprächspraxis sind hier auf XIX.AI! Diese kuratierte Sammlung enthält leistungsstarke, bahnbrechende Tools, die strengen Praxistests unterzogen wurden, um präzises Feedback zu liefern. Sie finden einen Vergleich zwischen kostenlosen und kostenpflichtigen Optionen sowie detaillierte Rankings, die Ihnen helfen, die empfehlenswerte Option zu wählen, die Ihr Selbstvertrauen und Ihre Fähigkeiten verbessert. Entdecken Sie jetzt Ihr perfektes Tool für den Erfolg im Vorstellungsgespräch!
12 Tools
xix.ai
Design & Kunst
Die besten KI-Tools für den Stiltransfer für kreative Experimente
Die besten und am besten bewerteten KI-Tools für den Stiltransfer im Jahr 2026 – ideal für kreative Experimente! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die in Praxistests und strengen Bewertungen außergewöhnliche Ergebnisse liefern. Diese Top-Lösungen helfen Kreativen dabei, ihre Produktivität deutlich zu steigern, indem sie die Erstellung von Inhalten beschleunigen und unendliche kreative Möglichkeiten eröffnen. Entdecken Sie jetzt Ihr perfektes Tool und legen Sie noch heute los!
9 Tools
xix.ai
Comic-Erstellung
Die besten KI-Tools für Sprechblasen zum visuellen Geschichtenerzählen
Die besten und am besten bewerteten KI-Tools für Sprechblasen zum visuellen Storytelling des Jahres 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Tools, die Kreativen dabei helfen, ihre Produktivität zu steigern und kreative Blockaden zu überwinden. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, sehen Sie sich Praxistests an und werfen Sie einen Blick auf die aktuellen Rankings, um die unverzichtbaren Lösungen zu finden, die sich perfekt für die Gestaltung fesselnder visueller Erzählungen eignen. Stöbern Sie jetzt und entdecken Sie Ihr ideales Tool!
10 Tools
xix.ai
Besprechungsassistent
Die besten Tools zur Zusammenfassung von KI-Meetings: Entscheidungen und Folgemaßnahmen übersichtlich nachverfolgen
Die besten und am besten bewerteten KI-Tools zur Zusammenfassung von Besprechungen im Jahr 2026 für eine übersichtliche Nachverfolgung von Entscheidungen und müheloses Follow-up. Diese sorgfältig zusammengestellte Liste präsentiert leistungsstarke, bahnbrechende Lösungen, die die Produktivität drastisch steigern, indem sie Besprechungsnotizen automatisieren, wichtige Aktionspunkte identifizieren und die Teamkoordination projektübergreifend optimieren. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und wöchentlich aktualisierte Rankings, die Ihnen helfen, das perfekte Tool zu finden. Entdecken Sie es jetzt und nutzen Sie Ihren KI-Vorteil!
9 Tools
xix.ai
Datenanalyse
Die besten Tools für die KI-gestützte Datenreinigung: Fehlende Werte und Duplikate schnell beheben
2026 – Die neuesten, besten und am höchsten bewerteten Tools für die Reinigung von KI-Daten, um fehlende Werte sowie Duplikate schnell zu beheben. Diese sorgfältig zusammengestellte Liste präsentiert leistungsstarke Lösungen, die die Produktivität erheblich steigern. Jedes Tool wurde in der Praxis gründlich getestet, um seine Zuverlässigkeit zu gewährleisten. Holen Sie sich einen kostenlosen Vergleich zwischen kostenloser und kostenpflichtiger Variante und entdecken Sie das für Ihre Bedürfnisse beste Tool. Entdecken Sie es jetzt auf XIX.AI, um Ihren Vorteil in der KI-Branche zu erlangen.
11 Tools
xix.ai

 Kommentare (0)
Die Überwindung der „englischzentrierten“ Einschränkung bei der semantischen Darstellung hat sich zu einer zentralen Herausforderung in der Weiterentwicklung großer Sprachmodelle entwickelt.
Am 26. März veröffentlichte das CodeFuse-Team der Ant Group und der Shanghai Jiao Tong University offiziell die F2LLM-v2-Reihe von Embedding-Modellen. Diese Reihe erzielte nicht nur führende Leistungen in maßgeblichen Benchmarks, sondern bietet Entwicklern weltweit durch einen vollständig quelloffenen Ansatz auch eine leistungsstarke und effiziente Lösung für die semantische Darstellung.
Außergewöhnliche Leistung: 11 SOTA-Ergebnisse bei MTEB
Im maßgeblichen MTEB-Benchmark zur Bewertung von Embedding-Modellen zeigte F2LLM-v2 umfassende Stärken:
11 Spitzenplatzierungen: Es sicherte sich den ersten Platz in 11 sprach- und domänenspezifischen Ranglisten, darunter Deutsch, Französisch, Japanisch und Code-Retrieval.
Ein beeindruckender Herausforderer: Selbst seine schlanken Varianten übertrafen durchweg bekannte Branchenmodelle vergleichbarer Größe.
Umfassende Abdeckung: Die Bewertung umfasste 430 verschiedene Teilaufgaben, wie medizinische Fragen und Antworten sowie Code-Retrieval, und erzielte eine vollständige Szenarioabdeckung.
Umfassendes Verständnis: Beherrschung von 282 natürlichen Sprachen und über 40 Programmiersprachen
Die Leistungsfähigkeit von F2LLM-v2 beruht auf seiner äußerst umfassenden Trainingsgrundlage:
Mehrsprachige Erweiterung: Es bietet verbesserte Unterstützung für Sprachen mit geringen und mittleren Ressourcen (wie nordische und südostasiatische Sprachfamilien) und ermöglicht so eine echte globale Sprachabdeckung.
Programmierkompetenz: Mit einem tiefgreifenden Verständnis von über 40 Programmiersprachen wie Python, Java und Go ist es die ideale Wahl für Entwickler, die RAG-Systeme (Retrieval-Augmented Generation) und Code-Assistenten erstellen.
Hochwertige Daten: Auf der Grundlage von 60 Millionen sorgfältig bereinigten öffentlichen Beispielen gewährleistet es sowohl die Reinheit als auch die Breite der Wissensbasis des Modells.
Extreme Effizienz: Eine komplette Modellfamilie mit einer Skalierung von 80 Millionen bis 14 Milliarden Parametern
Um den Anforderungen von Mobilgeräten bis hin zum Cloud-Computing gerecht zu werden, hat das CodeFuse-Team eine umfassende Modellmatrix entwickelt:
Für Mobilgeräte optimiert: Kompakte Modelle mit 80 Mio. bis 330 Mio. Parametern nutzen Techniken wie „Model Pruning“ und „Knowledge Distillation“ und ermöglichen so einen reibungslosen Betrieb auf mobilen Plattformen.
„Verschachtelte“ Innovation: Es unterstützt die dynamische Dimensionsanpassung, sodass Benutzer flexibel zwischen 8 Dimensionen und voller Dimensionen wechseln können, wodurch der Kompromiss zwischen Inferenzgeschwindigkeit und Speicherkosten optimiert wird.
Vollständig Open Source: Transparenz setzt einen neuen Community-Standard
Im Gegensatz zu vielen „Black-Box“-Modellen verfolgt F2LLM-v2 eine vollständig auf Open Source basierende Philosophie:
Vollständige Veröffentlichung: Alle Modellgewichte für jede Größenvariante stehen zum Download bereit.
Detaillierte Transparenz: Es wird ein umfassender technischer Bericht veröffentlicht, der die gesamte Trainingsmethodik offenlegt.
Volle Reproduzierbarkeit: Der gesamte Code und alle Trainings-Checkpoints werden veröffentlicht, sodass Forscher weltweit auf dieser Arbeit aufbauen und sie weiterentwickeln können.
Fazit: Grenzen überwinden, um das unendliche Potenzial der KI zu erkunden
Als weiterer bedeutender Meilenstein in der CodeFuse Open-Source-Reihe ist die Veröffentlichung von F2LLM-v2








 Apple Smart Glasses könnten auf der WWDC27 vorgestellt werden und dabei den Schutz der Privatsphäre in den Mittelpunkt stellen
Bloombergs Mark Gurman berichtet, dass Apples Smart Glasses mit dem Codenamen N50 im Juni 2027 auf der WWDC27 vorgestellt werden sollen, wobei ein Verkaufsstart im Herbst 2027 erwartet wird. Ursprünglich für Ende dieses Jahres und Anfang 2027 geplant
 Inside Details Exposed About Next-Gen Gemini: Strained Computing Power, Internal Teams Disagreed on Development Priorities and Resource Allocation
Berichten zufolge wurde der Start des hocherwarteten Next-Generation-Gemini-Modells von Google verschoben. Interne Uneinigkeiten über Entwicklungsprioritäten und Ressourcenallokation, kombiniert mit begrenzter Rechenkapazität und komplexen Genehmigun
 OpenAI entkräftet Bedenken bezüglich des verlangsamen Wachstums und erklärt, dass mehrere Geschäftsbereiche ihre Expansion beschleunigen
Als Reaktion auf externe Kritik bezüglich des nachlassenden Umsatzwachstums und verpasster interner Zielvorgaben gab der KI-Pionier OpenAI am Dienstag, den 28. April, eine selbstbewusste Erklärung ab. Das Unternehmen präzisierte, dass seine Verbrauch

2026 Neueste Besten Top-Bewerteten KI-Melodie-Schreibtools für Songentwürfe! XIX.AI hat eine hochleistungsfähige, bahnbrechende Kollektion zusammengestellt, die strengen Praxistests unterzogen wurde, um das beste Schreiberlebnis zu liefern. Sie finden detaillierte kostenlose versus kostenpflichtige Vergleiche, präzise Ranglisten und unbedingt auszuprobierende Optionen, die darauf ausgelegt sind, Ihnen zu helfen, beeindruckende Songentwürfe mühelos zu erstellen und Ihre kreative Produktivität erheblich zu steigern. Entdecken Sie jetzt Ihr perfektes Tool!
8 Tools
xix.ai

2026 Neueste Besten Top-bewerteten KI-Konversationstrainer-Tools für Vorstellungsgesprächspraxis sind hier auf XIX.AI! Diese kuratierte Sammlung enthält leistungsstarke, bahnbrechende Tools, die strengen Praxistests unterzogen wurden, um präzises Feedback zu liefern. Sie finden einen Vergleich zwischen kostenlosen und kostenpflichtigen Optionen sowie detaillierte Rankings, die Ihnen helfen, die empfehlenswerte Option zu wählen, die Ihr Selbstvertrauen und Ihre Fähigkeiten verbessert. Entdecken Sie jetzt Ihr perfektes Tool für den Erfolg im Vorstellungsgespräch!
12 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für den Stiltransfer im Jahr 2026 – ideal für kreative Experimente! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die in Praxistests und strengen Bewertungen außergewöhnliche Ergebnisse liefern. Diese Top-Lösungen helfen Kreativen dabei, ihre Produktivität deutlich zu steigern, indem sie die Erstellung von Inhalten beschleunigen und unendliche kreative Möglichkeiten eröffnen. Entdecken Sie jetzt Ihr perfektes Tool und legen Sie noch heute los!
9 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für Sprechblasen zum visuellen Storytelling des Jahres 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Tools, die Kreativen dabei helfen, ihre Produktivität zu steigern und kreative Blockaden zu überwinden. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, sehen Sie sich Praxistests an und werfen Sie einen Blick auf die aktuellen Rankings, um die unverzichtbaren Lösungen zu finden, die sich perfekt für die Gestaltung fesselnder visueller Erzählungen eignen. Stöbern Sie jetzt und entdecken Sie Ihr ideales Tool!
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools zur Zusammenfassung von Besprechungen im Jahr 2026 für eine übersichtliche Nachverfolgung von Entscheidungen und müheloses Follow-up. Diese sorgfältig zusammengestellte Liste präsentiert leistungsstarke, bahnbrechende Lösungen, die die Produktivität drastisch steigern, indem sie Besprechungsnotizen automatisieren, wichtige Aktionspunkte identifizieren und die Teamkoordination projektübergreifend optimieren. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und wöchentlich aktualisierte Rankings, die Ihnen helfen, das perfekte Tool zu finden. Entdecken Sie es jetzt und nutzen Sie Ihren KI-Vorteil!
9 Tools
xix.ai

2026 – Die neuesten, besten und am höchsten bewerteten Tools für die Reinigung von KI-Daten, um fehlende Werte sowie Duplikate schnell zu beheben. Diese sorgfältig zusammengestellte Liste präsentiert leistungsstarke Lösungen, die die Produktivität erheblich steigern. Jedes Tool wurde in der Praxis gründlich getestet, um seine Zuverlässigkeit zu gewährleisten. Holen Sie sich einen kostenlosen Vergleich zwischen kostenloser und kostenpflichtiger Variante und entdecken Sie das für Ihre Bedürfnisse beste Tool. Entdecken Sie es jetzt auf XIX.AI, um Ihren Vorteil in der KI-Branche zu erlangen.
11 Tools
xix.ai












