


 Lar
O Ant Group apresenta o F2LLM-v2: um modelo de incorporação multilíngue em grande escala
Superar a limitação “centrada no inglês” na representação semântica tornou-se uma fronteira fundamental na evolução dos grandes modelos de linguagem.
Em 26 de março, a equipe CodeFuse do Ant Group e da Universidade Jiao Tong de Xangai lançou oficialmente a série F2LLM-v2 de modelos de embedding. Essa série não apenas alcançou desempenho de ponta em benchmarks de referência, mas também oferece uma solução de representação semântica eficiente e de alto desempenho para desenvolvedores em todo o mundo por meio de uma abordagem totalmente de código aberto.
Desempenho excepcional: alcançando 11 resultados SOTA no MTEB
No renomado benchmark MTEB para avaliação de modelos de embedding, o F2LLM-v2 demonstrou pontos fortes abrangentes:
11 primeiras colocações: garantiu o primeiro lugar em 11 rankings específicos de idiomas e domínios, incluindo alemão, francês, japonês e recuperação de código.
Um Desafiador Formidável: Mesmo suas variantes leves superaram consistentemente modelos conhecidos do setor de tamanho comparável.
Ampla cobertura: a avaliação abrangeu 430 subtarefas diversas, como perguntas e respostas médicas e recuperação de código, alcançando cobertura completa de cenários.
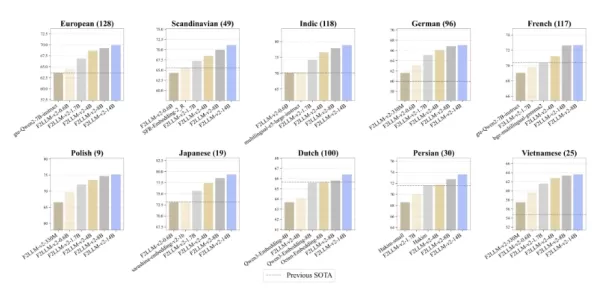
Compreensão abrangente: proficiência em 282 idiomas naturais e mais de 40 linguagens de programação
O poder do F2LLM-v2 deriva de sua base de treinamento altamente inclusiva:
Aprimoramento multilíngue: Oferece suporte reforçado para idiomas de recursos médios e baixos (como as famílias de idiomas nórdicos e do Sudeste Asiático), possibilitando uma cobertura linguística global genuína.
Especialização em programação: Com profundo conhecimento de mais de 40 linguagens de programação, como Python, Java e Go, é a escolha ideal para desenvolvedores que criam sistemas RAG (Retrieval-Augmented Generation) e assistentes de código.
Dados de alta qualidade: Construído com base em 60 milhões de amostras públicas meticulosamente limpas, ele garante tanto a pureza quanto a amplitude da base de conhecimento do modelo.
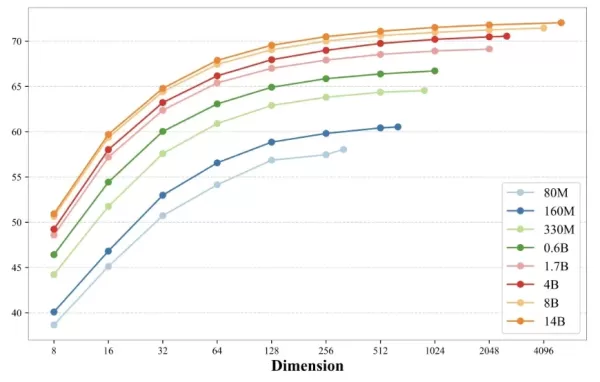
Extrema eficiência: uma família completa de modelos que varia de 80 milhões a 14 bilhões de parâmetros
Para atender a necessidades que vão desde dispositivos móveis até computação em nuvem, a equipe da CodeFuse desenvolveu uma matriz de modelos abrangente:
Otimizado para dispositivos móveis: modelos compactos de 80 milhões a 330 milhões de parâmetros utilizam técnicas de “poda de modelo” e “destilação de conhecimento”, permitindo uma operação suave em plataformas móveis.
Inovação “aninhada”: Suporta ajuste dinâmico de dimensões, permitindo que os usuários alternem com flexibilidade entre 8 dimensões e dimensões completas, otimizando o equilíbrio entre velocidade de inferência e custo de armazenamento.
Totalmente de código aberto: transparência estabelecendo um novo padrão para a comunidade
Ao contrário de muitos modelos de “caixa preta”, o F2LLM-v2 está comprometido com uma filosofia totalmente de código aberto:
Lançamento completo: todos os pesos do modelo para cada variante de tamanho estão disponíveis para download.
Transparência detalhada: Um relatório técnico abrangente é publicado, divulgando toda a metodologia de treinamento.
Reprodutibilidade total: Todos os códigos e pontos de verificação do treinamento são divulgados, capacitando pesquisadores globalmente a se basearem neste trabalho para desenvolvimento posterior.
Conclusão: Rompendo barreiras para explorar o potencial infinito da IA
Como mais um marco significativo na Série de Código Aberto da CodeFuse, o lançamento do F2LLM-v2
Artigo relacionado
 Óculos Inteligentes da Apple Podem Estrear na WWDC27, Destacando a Proteção de Privacidade
O repórter da Bloomberg, Mark Gurman, informa que os óculos inteligentes da Apple, com o codinome N50, estão previstos para estrear na WWDC27 em junho de 2027, com um lançamento no varejo esperado para o outono de 2027. Originalmente direcionados par
Dentro dos Detalhes Revelados Sobre o Gemini de Próxima Geração: Poder de Cálculo Sobrecarregado, Equipes Internas Discordaram Sobre Prioridades de Desenvolvimento e Alocação de Recursos
Os relatórios indicam que o lançamento do tão aguardado modelo Gemini de próxima geração do Google foi adiado. Desentendimentos internos sobre prioridades de desenvolvimento e alocação de recursos, combinados com capacidade computacional limitada e p
A OpenAI descarta preocupações com a desaceleração do crescimento e afirma que múltiplas unidades de negócio estão acelerando.
Em resposta à escrutínio externo sobre o desaceleramento do crescimento das vendas e o não cumprimento de metas internas, o líder em inteligência artificial, OpenAI, emitiu uma declaração confiante na terça-feira, 28 de abril. A empresa esclareceu qu
Recomendações de tópicos especiais relacionados
Análise de dados
 Copilotos de IA para SQL voltados para painéis de receita, análise de funis e métricas de produtos
2026: Os melhores copilotos AI para SQL, atualizados e classificados entre os melhores! A XIX.AI reúne uma coleção poderosa e revolucionária, com testes em ambiente real atualizados semanalmente. Essas ferramentas indispensáveis ajudam a gerar painéis de controle de receita precisos, analisar funis de vendas e rastrear métricas de produtos de forma rápida, aumentando significativamente a produtividade. Explore agora e encontre a ferramenta perfeita para tomada de decisões baseadas em dados! 238 caracteres
 9 ferramentas
 xix.ai
Composição musical
Melhores Ferramentas de IA para Criação de Melodias para Rascunhos de Músicas
2026 Últimas Melhores Ferramentas de Escrita de Melodias por IA Mais Bem Avaliadas para Rascunhos de Músicas! A XIX.AI reuniu uma coleção altamente poderosa e transformadora, que passou por rigorosos testes no mundo real para oferecer a melhor experiência de escrita. Você pode encontrar comparações detalhadas entre as versões gratuita e paga, classificações precisas e opções imperdíveis projetadas para ajudá-lo a criar rascunhos de músicas impressionantes sem esforço e aumentar significativamente sua produtividade criativa. Explore agora para descobrir a ferramenta perfeita para você!
8 ferramentas
xix.ai
chatbot
Melhores ferramentas de treinamento de conversação com IA para prática de entrevistas
As melhores ferramentas de treinamento de conversação com IA mais recentes e altamente avaliadas para 2026, ideais para prática de entrevistas, estão disponíveis no XIX.AI! Esta coleção selecionada apresenta ferramentas poderosas e transformadoras, submetidas a rigorosos testes do mundo real para fornecer feedback preciso. Você encontrará uma comparação entre opções gratuitas e pagas, além de classificações detalhadas, para ajudá-lo a escolher a opção imperdível que aumenta sua confiança e habilidades. Explore agora para descobrir a ferramenta perfeita para o sucesso nas entrevistas!
12 ferramentas
xix.ai
Design e Arte
As melhores ferramentas de transferência de estilo com IA para experimentos criativos
As melhores e mais bem avaliadas ferramentas de transferência de estilo com IA de 2026 para experimentos criativos! A XIX.AI selecionou uma coleção poderosa e revolucionária de ferramentas imperdíveis, que oferecem resultados excepcionais por meio de testes reais e classificações rigorosas. Essas soluções de ponta ajudam os profissionais criativos a aumentar significativamente a produtividade, acelerando a criação de conteúdo e revelando possibilidades criativas infinitas. Explore agora para descobrir a ferramenta perfeita para você e comece a criar hoje mesmo!
9 ferramentas
xix.ai
Criação de quadrinhos
As melhores ferramentas de balões de diálogo com IA para a narrativa visual
As melhores e mais bem avaliadas ferramentas de balões de diálogo com IA para narrativa visual de 2026 já estão disponíveis no XIX.AI! Esta coleção selecionada apresenta ferramentas poderosas e revolucionárias que ajudam os criadores a aumentar a produtividade e superar gargalos criativos. Veja uma comparação entre versões gratuitas e pagas, confira testes reais e verifique os rankings mais recentes para encontrar as soluções imperdíveis, perfeitas para criar narrativas visuais envolventes. Explore agora e descubra sua ferramenta ideal!
10 ferramentas
xix.ai
Assistente de Reunião
As melhores ferramentas de resumo de reuniões com IA: acompanhe decisões e ações de acompanhamento com clareza
As melhores e mais bem avaliadas ferramentas de resumo de reuniões com IA de 2026 para um acompanhamento claro das decisões e acompanhamentos sem esforço. Esta lista selecionada apresenta soluções poderosas e revolucionárias que aumentam drasticamente a produtividade ao automatizar notas de reuniões, identificar ações-chave e otimizar a coordenação da equipe em todos os projetos. Veja uma comparação entre versões gratuitas e pagas, além de testes práticos e rankings atualizados semanalmente para ajudá-lo a encontrar a ferramenta perfeita. Explore agora para aproveitar ao máximo as vantagens da IA!
9 ferramentas
xix.ai

 Comentários (0)
Superar a limitação “centrada no inglês” na representação semântica tornou-se uma fronteira fundamental na evolução dos grandes modelos de linguagem.
Em 26 de março, a equipe CodeFuse do Ant Group e da Universidade Jiao Tong de Xangai lançou oficialmente a série F2LLM-v2 de modelos de embedding. Essa série não apenas alcançou desempenho de ponta em benchmarks de referência, mas também oferece uma solução de representação semântica eficiente e de alto desempenho para desenvolvedores em todo o mundo por meio de uma abordagem totalmente de código aberto.
Desempenho excepcional: alcançando 11 resultados SOTA no MTEB
No renomado benchmark MTEB para avaliação de modelos de embedding, o F2LLM-v2 demonstrou pontos fortes abrangentes:
11 primeiras colocações: garantiu o primeiro lugar em 11 rankings específicos de idiomas e domínios, incluindo alemão, francês, japonês e recuperação de código.
Um Desafiador Formidável: Mesmo suas variantes leves superaram consistentemente modelos conhecidos do setor de tamanho comparável.
Ampla cobertura: a avaliação abrangeu 430 subtarefas diversas, como perguntas e respostas médicas e recuperação de código, alcançando cobertura completa de cenários.
Compreensão abrangente: proficiência em 282 idiomas naturais e mais de 40 linguagens de programação
O poder do F2LLM-v2 deriva de sua base de treinamento altamente inclusiva:
Aprimoramento multilíngue: Oferece suporte reforçado para idiomas de recursos médios e baixos (como as famílias de idiomas nórdicos e do Sudeste Asiático), possibilitando uma cobertura linguística global genuína.
Especialização em programação: Com profundo conhecimento de mais de 40 linguagens de programação, como Python, Java e Go, é a escolha ideal para desenvolvedores que criam sistemas RAG (Retrieval-Augmented Generation) e assistentes de código.
Dados de alta qualidade: Construído com base em 60 milhões de amostras públicas meticulosamente limpas, ele garante tanto a pureza quanto a amplitude da base de conhecimento do modelo.
Extrema eficiência: uma família completa de modelos que varia de 80 milhões a 14 bilhões de parâmetros
Para atender a necessidades que vão desde dispositivos móveis até computação em nuvem, a equipe da CodeFuse desenvolveu uma matriz de modelos abrangente:
Otimizado para dispositivos móveis: modelos compactos de 80 milhões a 330 milhões de parâmetros utilizam técnicas de “poda de modelo” e “destilação de conhecimento”, permitindo uma operação suave em plataformas móveis.
Inovação “aninhada”: Suporta ajuste dinâmico de dimensões, permitindo que os usuários alternem com flexibilidade entre 8 dimensões e dimensões completas, otimizando o equilíbrio entre velocidade de inferência e custo de armazenamento.
Totalmente de código aberto: transparência estabelecendo um novo padrão para a comunidade
Ao contrário de muitos modelos de “caixa preta”, o F2LLM-v2 está comprometido com uma filosofia totalmente de código aberto:
Lançamento completo: todos os pesos do modelo para cada variante de tamanho estão disponíveis para download.
Transparência detalhada: Um relatório técnico abrangente é publicado, divulgando toda a metodologia de treinamento.
Reprodutibilidade total: Todos os códigos e pontos de verificação do treinamento são divulgados, capacitando pesquisadores globalmente a se basearem neste trabalho para desenvolvimento posterior.
Conclusão: Rompendo barreiras para explorar o potencial infinito da IA
Como mais um marco significativo na Série de Código Aberto da CodeFuse, o lançamento do F2LLM-v2








 Óculos Inteligentes da Apple Podem Estrear na WWDC27, Destacando a Proteção de Privacidade
O repórter da Bloomberg, Mark Gurman, informa que os óculos inteligentes da Apple, com o codinome N50, estão previstos para estrear na WWDC27 em junho de 2027, com um lançamento no varejo esperado para o outono de 2027. Originalmente direcionados par
 Dentro dos Detalhes Revelados Sobre o Gemini de Próxima Geração: Poder de Cálculo Sobrecarregado, Equipes Internas Discordaram Sobre Prioridades de Desenvolvimento e Alocação de Recursos
Os relatórios indicam que o lançamento do tão aguardado modelo Gemini de próxima geração do Google foi adiado. Desentendimentos internos sobre prioridades de desenvolvimento e alocação de recursos, combinados com capacidade computacional limitada e p
 A OpenAI descarta preocupações com a desaceleração do crescimento e afirma que múltiplas unidades de negócio estão acelerando.
Em resposta à escrutínio externo sobre o desaceleramento do crescimento das vendas e o não cumprimento de metas internas, o líder em inteligência artificial, OpenAI, emitiu uma declaração confiante na terça-feira, 28 de abril. A empresa esclareceu qu

2026: Os melhores copilotos AI para SQL, atualizados e classificados entre os melhores! A XIX.AI reúne uma coleção poderosa e revolucionária, com testes em ambiente real atualizados semanalmente. Essas ferramentas indispensáveis ajudam a gerar painéis de controle de receita precisos, analisar funis de vendas e rastrear métricas de produtos de forma rápida, aumentando significativamente a produtividade. Explore agora e encontre a ferramenta perfeita para tomada de decisões baseadas em dados! 238 caracteres
9 ferramentas
xix.ai

2026 Últimas Melhores Ferramentas de Escrita de Melodias por IA Mais Bem Avaliadas para Rascunhos de Músicas! A XIX.AI reuniu uma coleção altamente poderosa e transformadora, que passou por rigorosos testes no mundo real para oferecer a melhor experiência de escrita. Você pode encontrar comparações detalhadas entre as versões gratuita e paga, classificações precisas e opções imperdíveis projetadas para ajudá-lo a criar rascunhos de músicas impressionantes sem esforço e aumentar significativamente sua produtividade criativa. Explore agora para descobrir a ferramenta perfeita para você!
8 ferramentas
xix.ai

As melhores ferramentas de treinamento de conversação com IA mais recentes e altamente avaliadas para 2026, ideais para prática de entrevistas, estão disponíveis no XIX.AI! Esta coleção selecionada apresenta ferramentas poderosas e transformadoras, submetidas a rigorosos testes do mundo real para fornecer feedback preciso. Você encontrará uma comparação entre opções gratuitas e pagas, além de classificações detalhadas, para ajudá-lo a escolher a opção imperdível que aumenta sua confiança e habilidades. Explore agora para descobrir a ferramenta perfeita para o sucesso nas entrevistas!
12 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de transferência de estilo com IA de 2026 para experimentos criativos! A XIX.AI selecionou uma coleção poderosa e revolucionária de ferramentas imperdíveis, que oferecem resultados excepcionais por meio de testes reais e classificações rigorosas. Essas soluções de ponta ajudam os profissionais criativos a aumentar significativamente a produtividade, acelerando a criação de conteúdo e revelando possibilidades criativas infinitas. Explore agora para descobrir a ferramenta perfeita para você e comece a criar hoje mesmo!
9 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de balões de diálogo com IA para narrativa visual de 2026 já estão disponíveis no XIX.AI! Esta coleção selecionada apresenta ferramentas poderosas e revolucionárias que ajudam os criadores a aumentar a produtividade e superar gargalos criativos. Veja uma comparação entre versões gratuitas e pagas, confira testes reais e verifique os rankings mais recentes para encontrar as soluções imperdíveis, perfeitas para criar narrativas visuais envolventes. Explore agora e descubra sua ferramenta ideal!
10 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de resumo de reuniões com IA de 2026 para um acompanhamento claro das decisões e acompanhamentos sem esforço. Esta lista selecionada apresenta soluções poderosas e revolucionárias que aumentam drasticamente a produtividade ao automatizar notas de reuniões, identificar ações-chave e otimizar a coordenação da equipe em todos os projetos. Veja uma comparação entre versões gratuitas e pagas, além de testes práticos e rankings atualizados semanalmente para ajudá-lo a encontrar a ferramenta perfeita. Explore agora para aproveitar ao máximo as vantagens da IA!
9 ferramentas
xix.ai












