


 집
안트 그룹, 다국어 풀스케일 임베딩 모델 ‘F2LLM-v2’ 공개
의미 표현에서 ‘영어 중심’이라는 한계를 극복하는 것은 대규모 언어 모델의 진화 과정에서 핵심적인 과제로 부상했습니다.
3월 26일, 앤트 그룹(Ant Group )과 상하이 교통대학교(Shanghai Jiao Tong University) 의 CodeFuse 팀은 F2LLM-v2 임베딩 모델 시리즈를 공식 출시했다. 이 시리즈는 권위 있는 벤치마크에서 선도적인 성능을 달성했을 뿐만 아니라, 완전한 오픈소스 방식을 통해 전 세계 개발자들에게 고성능의 효율적인 의미 표현 솔루션을 제공한다.
탁월한 성능: MTEB에서 11개 SOTA 결과 달성
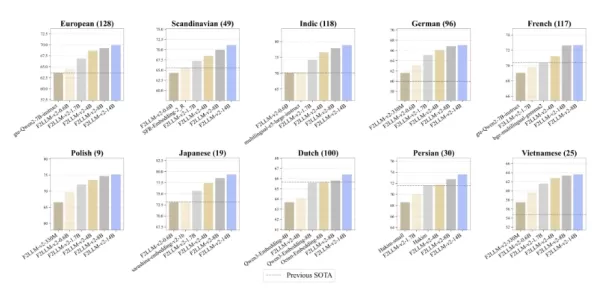
임베딩 모델 평가를 위한 권위 있는 MTEB 벤치마크에서 F2LLM-v2는 다음과 같은 포괄적인 강점을 보여주었습니다:
11개 부문 1위: 독일어, 프랑스어, 일본어, 코드 검색 등 11개 언어 및 도메인별 리더보드에서 1위를 차지했습니다.
강력한 도전자: 경량화된 변형 모델들조차도 비슷한 규모의 잘 알려진 업계 모델들을 꾸준히 능가했습니다.
광범위한 커버리지: 의료 Q&A 및 코드 검색 등 430개의 다양한 하위 과제를 평가하여 모든 시나리오를 포괄했습니다.
포괄적인 이해력: 282개 자연어 및 40개 이상의 프로그래밍 언어에 능통
F2LLM-v2의 강력한 성능은 매우 포괄적인 훈련 기반에서 비롯됩니다:
다국어 강화: 북유럽 및 동남아시아 언어군과 같은 중·저자원 언어에 대한 지원이 강화되어 진정한 글로벌 언어 커버리지를 제공합니다.
프로그래밍 전문성: Python, Java, Go 등 40개 이상의 프로그래밍 언어에 대한 깊은 이해를 바탕으로, RAG(검색 강화 생성) 시스템 및 코드 어시스턴트를 구축하는 개발자에게 이상적인 선택입니다.
고품질 데이터: 6천만 개의 꼼꼼하게 정리된 공개 샘플을 기반으로 구축되어 모델 지식 기반의 순도와 폭을 모두 보장합니다.
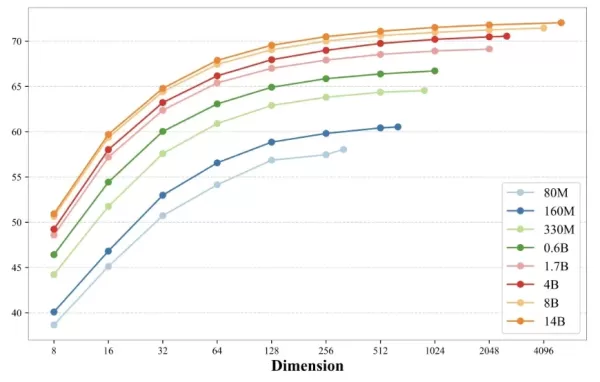
탁월한 효율성: 8천만에서 140억 파라미터에 이르는 완벽한 모델 제품군
모바일 기기부터 클라우드 컴퓨팅에 이르는 다양한 요구를 충족하기 위해 CodeFuse 팀은 포괄적인 모델 매트릭스를 개발했습니다:
모바일 최적화: 8,000만~3억 3,000만 파라미터 규모의 컴팩트 모델은 "모델 프루닝" 및 "지식 증류" 기법을 활용하여 모바일 플랫폼에서 원활한 작동을 가능하게 합니다.
"중첩된" 혁신: 동적 차원 조정을 지원하여 사용자가 8차원과 전체 차원 간에 유연하게 전환할 수 있게 함으로써, 추론 속도와 저장 비용 간의 균형을 최적화합니다.
완전 오픈 소스: 투명성을 바탕으로 새로운 커뮤니티 표준을 제시
많은 "블랙박스" 모델과 달리, F2LLM-v2는 완전한 오픈 소스 철학을 고수합니다:
완전한 공개: 모든 크기 변형에 대한 모델 가중치를 다운로드할 수 있습니다.
상세한 투명성: 전체 훈련 방법론을 공개하는 포괄적인 기술 보고서가 발간되었습니다.
완전한 재현성: 모든 코드와 훈련 체크포인트가 공개되어 전 세계 연구자들이 이 연구를 기반으로 추가 개발을 진행할 수 있도록 지원합니다.
결론: 경계를 허물고 AI의 무한한 잠재력을 탐구하다
CodeFuse 오픈 소스 시리즈의 또 다른 중요한 이정표로서, F2LLM-v2의 출시
관련 기사
 내부 세부 사항 공개: 차세대 Gemini에 대한Computing Power의 긴장, 내부 팀들은 개발 우선순위와 자원 배분에 대해 의견이 갈렸다
보고에 따르면 구글의 높은 기대를 모았던次世代 제미니 모델의 출시가 연기되었다. 개발 우선순위와 자원 배분에 대한 내부 의견 불일치, 제한된 컴퓨팅 용량, 복잡한 승인 절차가 결합되어 2개월의 지연이 불가피해졌다. 자체 맞춤형 TPU 칩을 보유하고 있음에도 불구하고, 모델 학습, 구글 클라우드 서비스, 수많은 소비자 및 기업용 AI 애플리케이션 간의 경쟁적 수요로 인해 구글은 컴퓨팅 자원 부족에 직면해 있다. 최고 경영진은 이제 조직 개편을 통
OpenAI, 성장 둔화 우려 불식…여러 사업부門 가속화
외부로부터의 판매 성장 둔화 및 내부 목표 미달성에 대한 scrutiny에 대응하여, AI 선도 기업 오픈AI는 4월 28일 화요일에 자신감 있는 성명을 발표했다. 이 회사는 소비자 제품과 기업 서비스의 빠른 진전을 명확히 하며, 최근 제기된 사업 둔화에 대한 추측을 직접적으로 반박했다.동사가 "여러 내부 목표를 놓쳤다"는 주장에 대해, 오픈AI는 이러한 보도를 "전형적인 클릭베이트"로 일축했다. 이 회사는 AI 통합에 대한 강력한 기업 수요
알리바바 슈퍼컵: Qwen3.8-Max, 강화된 코딩 및 오피스 도구로 데뷔
Alibaba는 2.4조 개의 파라미터를 갖춘 차세대 기반 대형 모델인 Qwen3.8-Max를 공식적으로 공개했습니다. 이 중요한 AI 기술 발전은 코딩 및 전문 사무 작업 등 핵심 영역에서 상당한 성능 향상을 제공하며, 강력한 기술 역량을 보여줍니다.권위 있는 Arena 대형 모델 랭킹에서 Qwen3.8-Max는 Anthropic의 Claude 시리즈에 이어 우수한 성적을 거두며 업계 선두 그룹에 자리했습니다. 이 성과는 국내 대형 모델이
관련 특별 주제 추천
음악 작곡
 노래 초안을 위한 최고의 AI 멜로디 작곡 도구
2026년 최신 최고 인기 AI 멜로디 작곡 도구! XIX.AI는 엄격한 실전 테스트를 거쳐 최고의 작곡 경험을 제공하는 강력한 게임 체인저 컬렉션을 엄선했습니다. 무료와 유료 버전의 상세 비교, 정확한 순위, 그리고 놀라운 노래 초안을 손쉽게 만들고 창의적 생산성을 크게 높일 수 있는 필수 추천 옵션들을 확인할 수 있습니다. 지금 바로 탐색하여 완벽한 도구를 발견하세요!
 8 도구
 xix.ai
챗봇
면접 연습을 위한 최고의 AI 대화 트레이너 도구
2026년 최신 최고의 평점 높은 AI 대화 트레이너 도구들이 XIX.AI에서 만나보세요! 면접 연습을 위한 이 엄선된 컬렉션은 강력한, 게임 체인저 도구들을 포함하고 있으며, 엄격한 실제 세계 테스트를 거쳐 정확한 피드백을 제공합니다. 무료 대 유료 비교와 상세한 순위표를 찾을 수 있어 자신감과 기술을 향상시킬 수 있는 꼭 시도해봐야 할 옵션을 선택하는 데 도움이 됩니다. 지금 탐색하여 면접 성공을 위한 완벽한 도구를 발견하세요!
12 도구
xix.ai
디자인과 예술
창의적인 실험을 위한 최고의 AI 스타일 변환 도구
2026년 최신, 최고 평점을 받은 창의적 실험을 위한 AI 스타일 변환 도구! XIX.AI는 실제 테스트와 엄격한 평가를 통해 탁월한 결과를 보여주는, 강력하고 판도를 바꿀 만한 ‘꼭 사용해 봐야 할’ 도구들을 엄선했습니다. 이 최고의 솔루션들은 콘텐츠 제작 속도를 높이고 무한한 창의적 가능성을 열어줌으로써 크리에이터들의 생산성을 크게 높여줍니다. 지금 바로 탐색하여 나에게 딱 맞는 도구를 찾아보고, 오늘 바로 창작을 시작해 보세요!
9 도구
xix.ai
만화 창작
시각적 스토리텔링을 위한 최고의 AI 대화 풍선 도구
2026년 시각적 스토리텔링을 위한 최신 최고 평점의 AI 대화 풍선 도구가 XIX.AI에 소개됩니다! 이 엄선된 모음집에는 크리에이터들이 생산성을 높이고 창의적인 난관을 극복하는 데 도움을 주는, 강력하고 획기적인 도구들이 포함되어 있습니다. 무료 버전과 유료 버전의 비교 정보를 확인하고, 실제 테스트 결과를 살펴보며, 최신 순위를 통해 매력적인 시각적 이야기를 만드는 데 꼭 필요한 솔루션을 찾아보세요. 지금 바로 탐색하여 여러분에게 딱 맞는 도구를 발견해 보세요!
10 도구
xix.ai
회의 도우미
최고의 AI 회의 요약 도구: 의사 결정 사항과 후속 조치를 명확하게 추적하세요
2026년 최신 최고 평점을 받은 최고의 AI 회의 요약 도구로, 명확한 의사 결정 추적과 손쉬운 후속 조치를 실현하세요. 이 엄선된 목록은 회의록 자동화, 핵심 실행 과제 파악, 모든 프로젝트에 걸친 팀 협업 효율화를 통해 생산성을 획기적으로 높여주는 강력하고 혁신적인 솔루션을 소개합니다. 무료 버전과 유료 버전의 비교 정보, 실제 사용 후기, 매주 업데이트되는 순위 정보를 통해 여러분에게 딱 맞는 도구를 찾아보세요. 지금 바로 살펴보고 AI의 힘을 경험해 보세요!
9 도구
xix.ai
데이터 분석
최고의 AI 데이터 정제 도구: 누락된 값과 중복 데이터를 신속하게 수정하기
2026년 최신의 우수하고 높은 평가를 받는 AI 데이터 정제 도구들로, 누락된 값과 중복 데이터를 신속하게 수정할 수 있습니다. 이 선별된 목록에는 생산성을 획기적으로 향상시켜 주는 강력한 솔루션이 포함되어 있습니다. 각 도구는 신뢰성을 보장하기 위해 엄격한 실제 환경 테스트를 거쳤습니다. 무료 버전과 유료 버전의 비교 정보를 확인하고, 귀하의 요구사항에 가장 적합한 도구를 발견해 보세요. 지금 바로 XIX.AI에서 자세히 알아보시고 AI 분야에서의 경쟁 우위를 확보하세요.
11 도구
xix.ai

 의견 (0)
0/500
의미 표현에서 ‘영어 중심’이라는 한계를 극복하는 것은 대규모 언어 모델의 진화 과정에서 핵심적인 과제로 부상했습니다.
3월 26일, 앤트 그룹(Ant Group )과 상하이 교통대학교(Shanghai Jiao Tong University) 의 CodeFuse 팀은 F2LLM-v2 임베딩 모델 시리즈를 공식 출시했다. 이 시리즈는 권위 있는 벤치마크에서 선도적인 성능을 달성했을 뿐만 아니라, 완전한 오픈소스 방식을 통해 전 세계 개발자들에게 고성능의 효율적인 의미 표현 솔루션을 제공한다.
탁월한 성능: MTEB에서 11개 SOTA 결과 달성
임베딩 모델 평가를 위한 권위 있는 MTEB 벤치마크에서 F2LLM-v2는 다음과 같은 포괄적인 강점을 보여주었습니다:
11개 부문 1위: 독일어, 프랑스어, 일본어, 코드 검색 등 11개 언어 및 도메인별 리더보드에서 1위를 차지했습니다.
강력한 도전자: 경량화된 변형 모델들조차도 비슷한 규모의 잘 알려진 업계 모델들을 꾸준히 능가했습니다.
광범위한 커버리지: 의료 Q&A 및 코드 검색 등 430개의 다양한 하위 과제를 평가하여 모든 시나리오를 포괄했습니다.
포괄적인 이해력: 282개 자연어 및 40개 이상의 프로그래밍 언어에 능통
F2LLM-v2의 강력한 성능은 매우 포괄적인 훈련 기반에서 비롯됩니다:
다국어 강화: 북유럽 및 동남아시아 언어군과 같은 중·저자원 언어에 대한 지원이 강화되어 진정한 글로벌 언어 커버리지를 제공합니다.
프로그래밍 전문성: Python, Java, Go 등 40개 이상의 프로그래밍 언어에 대한 깊은 이해를 바탕으로, RAG(검색 강화 생성) 시스템 및 코드 어시스턴트를 구축하는 개발자에게 이상적인 선택입니다.
고품질 데이터: 6천만 개의 꼼꼼하게 정리된 공개 샘플을 기반으로 구축되어 모델 지식 기반의 순도와 폭을 모두 보장합니다.
탁월한 효율성: 8천만에서 140억 파라미터에 이르는 완벽한 모델 제품군
모바일 기기부터 클라우드 컴퓨팅에 이르는 다양한 요구를 충족하기 위해 CodeFuse 팀은 포괄적인 모델 매트릭스를 개발했습니다:
모바일 최적화: 8,000만~3억 3,000만 파라미터 규모의 컴팩트 모델은 "모델 프루닝" 및 "지식 증류" 기법을 활용하여 모바일 플랫폼에서 원활한 작동을 가능하게 합니다.
"중첩된" 혁신: 동적 차원 조정을 지원하여 사용자가 8차원과 전체 차원 간에 유연하게 전환할 수 있게 함으로써, 추론 속도와 저장 비용 간의 균형을 최적화합니다.
완전 오픈 소스: 투명성을 바탕으로 새로운 커뮤니티 표준을 제시
많은 "블랙박스" 모델과 달리, F2LLM-v2는 완전한 오픈 소스 철학을 고수합니다:
완전한 공개: 모든 크기 변형에 대한 모델 가중치를 다운로드할 수 있습니다.
상세한 투명성: 전체 훈련 방법론을 공개하는 포괄적인 기술 보고서가 발간되었습니다.
완전한 재현성: 모든 코드와 훈련 체크포인트가 공개되어 전 세계 연구자들이 이 연구를 기반으로 추가 개발을 진행할 수 있도록 지원합니다.
결론: 경계를 허물고 AI의 무한한 잠재력을 탐구하다
CodeFuse 오픈 소스 시리즈의 또 다른 중요한 이정표로서, F2LLM-v2의 출시








 내부 세부 사항 공개: 차세대 Gemini에 대한Computing Power의 긴장, 내부 팀들은 개발 우선순위와 자원 배분에 대해 의견이 갈렸다
보고에 따르면 구글의 높은 기대를 모았던次世代 제미니 모델의 출시가 연기되었다. 개발 우선순위와 자원 배분에 대한 내부 의견 불일치, 제한된 컴퓨팅 용량, 복잡한 승인 절차가 결합되어 2개월의 지연이 불가피해졌다. 자체 맞춤형 TPU 칩을 보유하고 있음에도 불구하고, 모델 학습, 구글 클라우드 서비스, 수많은 소비자 및 기업용 AI 애플리케이션 간의 경쟁적 수요로 인해 구글은 컴퓨팅 자원 부족에 직면해 있다. 최고 경영진은 이제 조직 개편을 통
 OpenAI, 성장 둔화 우려 불식…여러 사업부門 가속화
외부로부터의 판매 성장 둔화 및 내부 목표 미달성에 대한 scrutiny에 대응하여, AI 선도 기업 오픈AI는 4월 28일 화요일에 자신감 있는 성명을 발표했다. 이 회사는 소비자 제품과 기업 서비스의 빠른 진전을 명확히 하며, 최근 제기된 사업 둔화에 대한 추측을 직접적으로 반박했다.동사가 "여러 내부 목표를 놓쳤다"는 주장에 대해, 오픈AI는 이러한 보도를 "전형적인 클릭베이트"로 일축했다. 이 회사는 AI 통합에 대한 강력한 기업 수요
 알리바바 슈퍼컵: Qwen3.8-Max, 강화된 코딩 및 오피스 도구로 데뷔
Alibaba는 2.4조 개의 파라미터를 갖춘 차세대 기반 대형 모델인 Qwen3.8-Max를 공식적으로 공개했습니다. 이 중요한 AI 기술 발전은 코딩 및 전문 사무 작업 등 핵심 영역에서 상당한 성능 향상을 제공하며, 강력한 기술 역량을 보여줍니다.권위 있는 Arena 대형 모델 랭킹에서 Qwen3.8-Max는 Anthropic의 Claude 시리즈에 이어 우수한 성적을 거두며 업계 선두 그룹에 자리했습니다. 이 성과는 국내 대형 모델이

2026년 최신 최고 인기 AI 멜로디 작곡 도구! XIX.AI는 엄격한 실전 테스트를 거쳐 최고의 작곡 경험을 제공하는 강력한 게임 체인저 컬렉션을 엄선했습니다. 무료와 유료 버전의 상세 비교, 정확한 순위, 그리고 놀라운 노래 초안을 손쉽게 만들고 창의적 생산성을 크게 높일 수 있는 필수 추천 옵션들을 확인할 수 있습니다. 지금 바로 탐색하여 완벽한 도구를 발견하세요!
8 도구
xix.ai

2026년 최신 최고의 평점 높은 AI 대화 트레이너 도구들이 XIX.AI에서 만나보세요! 면접 연습을 위한 이 엄선된 컬렉션은 강력한, 게임 체인저 도구들을 포함하고 있으며, 엄격한 실제 세계 테스트를 거쳐 정확한 피드백을 제공합니다. 무료 대 유료 비교와 상세한 순위표를 찾을 수 있어 자신감과 기술을 향상시킬 수 있는 꼭 시도해봐야 할 옵션을 선택하는 데 도움이 됩니다. 지금 탐색하여 면접 성공을 위한 완벽한 도구를 발견하세요!
12 도구
xix.ai

2026년 최신, 최고 평점을 받은 창의적 실험을 위한 AI 스타일 변환 도구! XIX.AI는 실제 테스트와 엄격한 평가를 통해 탁월한 결과를 보여주는, 강력하고 판도를 바꿀 만한 ‘꼭 사용해 봐야 할’ 도구들을 엄선했습니다. 이 최고의 솔루션들은 콘텐츠 제작 속도를 높이고 무한한 창의적 가능성을 열어줌으로써 크리에이터들의 생산성을 크게 높여줍니다. 지금 바로 탐색하여 나에게 딱 맞는 도구를 찾아보고, 오늘 바로 창작을 시작해 보세요!
9 도구
xix.ai

2026년 시각적 스토리텔링을 위한 최신 최고 평점의 AI 대화 풍선 도구가 XIX.AI에 소개됩니다! 이 엄선된 모음집에는 크리에이터들이 생산성을 높이고 창의적인 난관을 극복하는 데 도움을 주는, 강력하고 획기적인 도구들이 포함되어 있습니다. 무료 버전과 유료 버전의 비교 정보를 확인하고, 실제 테스트 결과를 살펴보며, 최신 순위를 통해 매력적인 시각적 이야기를 만드는 데 꼭 필요한 솔루션을 찾아보세요. 지금 바로 탐색하여 여러분에게 딱 맞는 도구를 발견해 보세요!
10 도구
xix.ai

2026년 최신 최고 평점을 받은 최고의 AI 회의 요약 도구로, 명확한 의사 결정 추적과 손쉬운 후속 조치를 실현하세요. 이 엄선된 목록은 회의록 자동화, 핵심 실행 과제 파악, 모든 프로젝트에 걸친 팀 협업 효율화를 통해 생산성을 획기적으로 높여주는 강력하고 혁신적인 솔루션을 소개합니다. 무료 버전과 유료 버전의 비교 정보, 실제 사용 후기, 매주 업데이트되는 순위 정보를 통해 여러분에게 딱 맞는 도구를 찾아보세요. 지금 바로 살펴보고 AI의 힘을 경험해 보세요!
9 도구
xix.ai

2026년 최신의 우수하고 높은 평가를 받는 AI 데이터 정제 도구들로, 누락된 값과 중복 데이터를 신속하게 수정할 수 있습니다. 이 선별된 목록에는 생산성을 획기적으로 향상시켜 주는 강력한 솔루션이 포함되어 있습니다. 각 도구는 신뢰성을 보장하기 위해 엄격한 실제 환경 테스트를 거쳤습니다. 무료 버전과 유료 버전의 비교 정보를 확인하고, 귀하의 요구사항에 가장 적합한 도구를 발견해 보세요. 지금 바로 XIX.AI에서 자세히 알아보시고 AI 분야에서의 경쟁 우위를 확보하세요.
11 도구
xix.ai












