


 Heim
MiniMax stellt M3 vor, ein inländisches KI-Großmodell, das GPT-5.5 übertrifft.
Chinas KI-Branche hat einen bedeutenden technologischen Sprung vollzogen, mit der offiziellen Einführung des neuesten Large-Language-Modells von Xiyu Technology, MiniMax M3. Dieses fortschrittliche System kombiniert modernste Programmierfähigkeiten mit der Unterstützung eines extrem langen Kontextfensters von bis zu 1 Million Tokens. Bemerkenswerterweise unterstützt es nativ multimodale Eingaben, einschließlich Bild- und Videoverarbeitung, sowie die Interaktion mit Computerdesktops, was es zum ersten Open-Source-Modell in China macht, das diese drei kritischen Funktionen integriert.
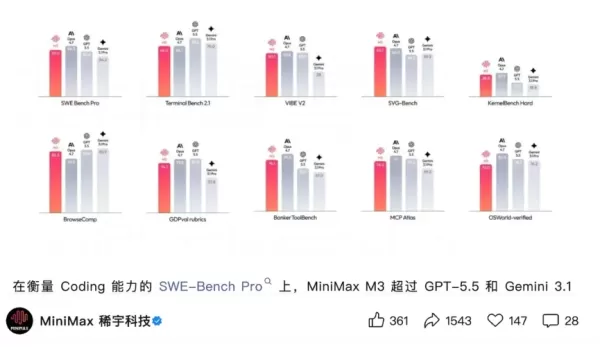
Außergewöhnliche Ergebnisse in standardisierten Benchmarks
Bei der strengen SWE-Bench-Programmierungsbewertung erzielte MiniMax M3 einen Score von 59,0 %, übertraf damit GPT-5.5 und Gemini 3.1 Pro und lag knapp hinter dem Top-Modell Opus 4.7 zurück. Das Modell zeigte auch überlegene Leistungen im Claw-Eval-Test für KI-Agenten-Fähigkeiten und erreichte führende Scores auf dem OmniDocBench-Benchmark für multimodales Dokumentenverständnis.
Fortschrittliche Architektur erhöht Effizienz
Diese Leistung wird durch M3s Einführung einer neuartigen sparsamen Aufmerksamkeitsarchitektur (MSA) ermöglicht. Bei der Verarbeitung extrem langer Kontexte von 1 Million Tokens reduziert dieses Design die Berechnung pro Token im Vergleich zu seinem Vorgänger um die Hälfte. Infolgedessen beschleunigt das Modell die Verständnisgeschwindigkeit um mehr als das Neunfache und erhöht die Antwortgenerierungsgeschwindigkeit um über das 15-fache. Die API ist nun live, und das offizielle Team verpflichtet sich, Modellgewichte und technische Berichte für globale Entwickler innerhalb von 10 Tagen freizugeben.
Verwandter Artikel
 Indien verpflichtet Caller-ID-Apps zur Weitergabe von Spam-Daten an Telekommunikationsanbieter
Indien hat seine Anti-Spam-Vorschriften erweitert, um vorzuschreiben, dass Caller-ID- und Call-Management-Anwendungen Nutzer-Spamberichte mit Telekommunikationsanbietern teilen, ein Schritt, der dazu geführt hat, dass Truecaller, ein bekannter Anbiet
Qwen-KI-Plattform erweitert Modellmatrix mit offizieller Einführung von GLM-5.3 und DeepSeek-V4-Pro
Die Alibaba Cloud Qwen AI-Plattform (MaaS) hat kürzlich ihre Modellservicematrix erweitert und das Flaggschiff-Großmodell GLM-5.3 von Zhipu sowie die offizielle Veröffentlichung von DeepSeek-V4-Pro integriert. Die entsprechenden API-Dienste sind nun
Warum Agenten in langen Aufgaben vergessen und vom Kurs abkommen: AWS, Claude Code und Manus entpacken vier Frameworks
Große Sprachmodelle verlieren häufig den Fokus während längerer Operationen und entfernen sich von ihren ursprünglichen Zielen – eine anhaltende Herausforderung im Bereich der intelligenten Agenten. Das Problem resultiert oft nicht aus dem Modell sel
Empfehlungen zu verwandten Spezialthemen
Musikkomposition
 KI-basierte Songwriting-Tools für Textideen und Melodienkonzepte
Die neuesten, besten und am höchsten bewerteten KI-Tools zum Songwriting für Texte und Melodienideen aus dem Jahr 2026 sind auf XIX.AI erhältlich! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke Lösungen, die durch strenge Tests in der Praxis gegangen sind, um präzise Vorschläge für Texte und Melodien zu liefern. Erhalten Sie einen kostenlosen Vergleich von Kostenlos- und Pay-Versionen, sehen Sie detaillierte Ranglisten sowie Tools, die Ihr kreatives Arbeitsprozess erheblich verbessern können. Entdecken Sie jetzt das perfekte Tool für Ihre Bedürfnisse!
 8 Tools
 xix.ai
Gesundheit Wellness
ChatGPT-Apps zur Essensplanung für die Makro-Erfassung, Einkaufslisten und die wöchentliche Essensvorbereitung
2026 – Die aktuell besten ChatGPT-Apps zur Mahlzeitenplanung: Top-bewertete, unverzichtbare und leistungsstarke Tools, die neue Maßstäbe setzen – für die Makro-Erfassung, Einkaufslisten und die wöchentliche Essensvorbereitung. XIX.AI liefert wöchentlich aktualisierte Rankings auf Basis praktischer Tests, einschließlich eines Vergleichs zwischen kostenlosen und kostenpflichtigen Angeboten. Entdecken Sie noch heute das perfekte Tool, um Ihre Produktivität zu steigern und Ihren KI-Vorteil zu nutzen. Jetzt entdecken!
9 Tools
xix.ai
Videoerstellung
KI-Tools zur Erstellung von Videoskripten für Kurzvideos
Die besten und am besten bewerteten KI-Tools für Videoskripte für Kurzform-Inhalte im Jahr 2026! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung von Tools zusammengestellt, die Sie unbedingt ausprobieren sollten und die strengen Praxistests durchlaufen haben. Hier finden Sie detaillierte, wöchentlich aktualisierte Rankings, Vergleichsinformationen zu kostenlosen und kostenpflichtigen Angeboten sowie Einblicke, die Ihnen helfen, Ihre Produktivität zu steigern und Ihren KI-Vorteil bei der Erstellung hochwertiger Kurzform-Inhalte zu nutzen. Stöbern Sie jetzt und entdecken Sie Ihr perfektes Tool!
10 Tools
xix.ai
Comic-Erstellung
KI-Tools für Comic-Panels zur Erstellung von Erzählungen im Storyboard-Stil
2026: Die besten neuen KI-Tools für Comic-Panels im Storyboard-Stil! Diese sorgfältig zusammengestellte Sammlung der besten Tools umfasst leistungsstarke, bahnbrechende Lösungen, mit denen Kreative ihre Schreibeffizienz steigern und kreative Engpässe überwinden können. Hier finden Sie detaillierte Vergleiche zwischen kostenlosen und kostenpflichtigen Angeboten, Praxistests und offizielle Rankings, die Ihnen bei der Auswahl helfen. XIX.AI bietet zudem Experteneinblicke. Stöbern Sie jetzt und entdecken Sie Ihr perfektes Tool, um lebendige Geschichten zum Leben zu erwecken! 238 Zeichen
9 Tools
xix.ai
Videoerstellung
Die besten KI-Videoerstellungstools für kurze Inhalte
2026 Neueste Beste Top-bewertete KI-Videoerstellungstools für kurze Inhalte finden Sie hier in XIX.AIs kuratierte Sammlung. Diese leistungsstarken, bahnbrechenden Tools haben strenge Praxistests bestanden und bieten einen umfassenden Vergleich zwischen kostenlosen und kostenpflichtigen Versionen sowie detaillierte Ranglisten, um Ihnen zu helfen, die perfekte Option zu finden. Egal, ob Sie schnell hochwertige Kurzvideos erstellen oder Ihre Produktivität bei verschiedenen Aufgaben steigern möchten – diese empfehlenswerten Lösungen liefern hervorragende Ergebnisse. Entdecken Sie jetzt Ihr ideales Tool und nutzen Sie Ihren KI-Vorteil.
9 Tools
xix.ai
Design & Kunst
Die besten KI-Kunstgeneratoren: Entdecken Sie Moodboards, Stile und visuelle Richtungen
Die neueste Rangliste der besten KI-Kunstgeneratoren von 2026 präsentiert die am höchsten bewerteten Tools zur Erstellung beeindruckender Moodboards, zum Erkunden vielfältiger Stile sowie zur Festlegung visueller Richtungen. XIX.AI bietet eine sorgfältig ausgewählte Liste leistungsstarker, bahnbrechender Optionen, die strenge Prüfungen in der Praxis bestanden haben. Erhalten Sie einen kostenlosen Vergleich zwischen kostenloser und kostenpflichtiger Nutzung, um das optimale Tool für Ihre kreative Arbeitsweise zu finden. Entdecken Sie jetzt, wie Sie Ihren Vorteil in der KI-gestützten Kunstschaffung nutzen können.
10 Tools
xix.ai

 Kommentare (0)
Chinas KI-Branche hat einen bedeutenden technologischen Sprung vollzogen, mit der offiziellen Einführung des neuesten Large-Language-Modells von Xiyu Technology, MiniMax M3. Dieses fortschrittliche System kombiniert modernste Programmierfähigkeiten mit der Unterstützung eines extrem langen Kontextfensters von bis zu 1 Million Tokens. Bemerkenswerterweise unterstützt es nativ multimodale Eingaben, einschließlich Bild- und Videoverarbeitung, sowie die Interaktion mit Computerdesktops, was es zum ersten Open-Source-Modell in China macht, das diese drei kritischen Funktionen integriert.
Außergewöhnliche Ergebnisse in standardisierten Benchmarks
Bei der strengen SWE-Bench-Programmierungsbewertung erzielte MiniMax M3 einen Score von 59,0 %, übertraf damit GPT-5.5 und Gemini 3.1 Pro und lag knapp hinter dem Top-Modell Opus 4.7 zurück. Das Modell zeigte auch überlegene Leistungen im Claw-Eval-Test für KI-Agenten-Fähigkeiten und erreichte führende Scores auf dem OmniDocBench-Benchmark für multimodales Dokumentenverständnis.
Fortschrittliche Architektur erhöht Effizienz
Diese Leistung wird durch M3s Einführung einer neuartigen sparsamen Aufmerksamkeitsarchitektur (MSA) ermöglicht. Bei der Verarbeitung extrem langer Kontexte von 1 Million Tokens reduziert dieses Design die Berechnung pro Token im Vergleich zu seinem Vorgänger um die Hälfte. Infolgedessen beschleunigt das Modell die Verständnisgeschwindigkeit um mehr als das Neunfache und erhöht die Antwortgenerierungsgeschwindigkeit um über das 15-fache. Die API ist nun live, und das offizielle Team verpflichtet sich, Modellgewichte und technische Berichte für globale Entwickler innerhalb von 10 Tagen freizugeben.








 Indien verpflichtet Caller-ID-Apps zur Weitergabe von Spam-Daten an Telekommunikationsanbieter
Indien hat seine Anti-Spam-Vorschriften erweitert, um vorzuschreiben, dass Caller-ID- und Call-Management-Anwendungen Nutzer-Spamberichte mit Telekommunikationsanbietern teilen, ein Schritt, der dazu geführt hat, dass Truecaller, ein bekannter Anbiet
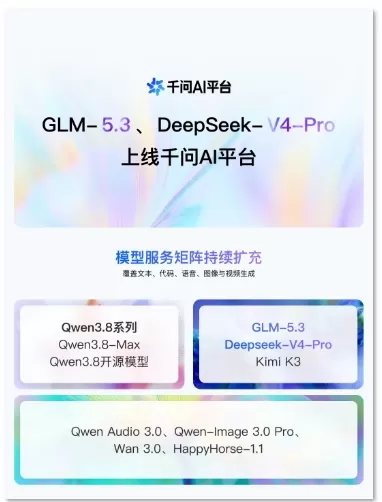 Qwen-KI-Plattform erweitert Modellmatrix mit offizieller Einführung von GLM-5.3 und DeepSeek-V4-Pro
Die Alibaba Cloud Qwen AI-Plattform (MaaS) hat kürzlich ihre Modellservicematrix erweitert und das Flaggschiff-Großmodell GLM-5.3 von Zhipu sowie die offizielle Veröffentlichung von DeepSeek-V4-Pro integriert. Die entsprechenden API-Dienste sind nun
 Warum Agenten in langen Aufgaben vergessen und vom Kurs abkommen: AWS, Claude Code und Manus entpacken vier Frameworks
Große Sprachmodelle verlieren häufig den Fokus während längerer Operationen und entfernen sich von ihren ursprünglichen Zielen – eine anhaltende Herausforderung im Bereich der intelligenten Agenten. Das Problem resultiert oft nicht aus dem Modell sel

Die neuesten, besten und am höchsten bewerteten KI-Tools zum Songwriting für Texte und Melodienideen aus dem Jahr 2026 sind auf XIX.AI erhältlich! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke Lösungen, die durch strenge Tests in der Praxis gegangen sind, um präzise Vorschläge für Texte und Melodien zu liefern. Erhalten Sie einen kostenlosen Vergleich von Kostenlos- und Pay-Versionen, sehen Sie detaillierte Ranglisten sowie Tools, die Ihr kreatives Arbeitsprozess erheblich verbessern können. Entdecken Sie jetzt das perfekte Tool für Ihre Bedürfnisse!
8 Tools
xix.ai

2026 – Die aktuell besten ChatGPT-Apps zur Mahlzeitenplanung: Top-bewertete, unverzichtbare und leistungsstarke Tools, die neue Maßstäbe setzen – für die Makro-Erfassung, Einkaufslisten und die wöchentliche Essensvorbereitung. XIX.AI liefert wöchentlich aktualisierte Rankings auf Basis praktischer Tests, einschließlich eines Vergleichs zwischen kostenlosen und kostenpflichtigen Angeboten. Entdecken Sie noch heute das perfekte Tool, um Ihre Produktivität zu steigern und Ihren KI-Vorteil zu nutzen. Jetzt entdecken!
9 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für Videoskripte für Kurzform-Inhalte im Jahr 2026! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung von Tools zusammengestellt, die Sie unbedingt ausprobieren sollten und die strengen Praxistests durchlaufen haben. Hier finden Sie detaillierte, wöchentlich aktualisierte Rankings, Vergleichsinformationen zu kostenlosen und kostenpflichtigen Angeboten sowie Einblicke, die Ihnen helfen, Ihre Produktivität zu steigern und Ihren KI-Vorteil bei der Erstellung hochwertiger Kurzform-Inhalte zu nutzen. Stöbern Sie jetzt und entdecken Sie Ihr perfektes Tool!
10 Tools
xix.ai

2026: Die besten neuen KI-Tools für Comic-Panels im Storyboard-Stil! Diese sorgfältig zusammengestellte Sammlung der besten Tools umfasst leistungsstarke, bahnbrechende Lösungen, mit denen Kreative ihre Schreibeffizienz steigern und kreative Engpässe überwinden können. Hier finden Sie detaillierte Vergleiche zwischen kostenlosen und kostenpflichtigen Angeboten, Praxistests und offizielle Rankings, die Ihnen bei der Auswahl helfen. XIX.AI bietet zudem Experteneinblicke. Stöbern Sie jetzt und entdecken Sie Ihr perfektes Tool, um lebendige Geschichten zum Leben zu erwecken! 238 Zeichen
9 Tools
xix.ai

2026 Neueste Beste Top-bewertete KI-Videoerstellungstools für kurze Inhalte finden Sie hier in XIX.AIs kuratierte Sammlung. Diese leistungsstarken, bahnbrechenden Tools haben strenge Praxistests bestanden und bieten einen umfassenden Vergleich zwischen kostenlosen und kostenpflichtigen Versionen sowie detaillierte Ranglisten, um Ihnen zu helfen, die perfekte Option zu finden. Egal, ob Sie schnell hochwertige Kurzvideos erstellen oder Ihre Produktivität bei verschiedenen Aufgaben steigern möchten – diese empfehlenswerten Lösungen liefern hervorragende Ergebnisse. Entdecken Sie jetzt Ihr ideales Tool und nutzen Sie Ihren KI-Vorteil.
9 Tools
xix.ai

Die neueste Rangliste der besten KI-Kunstgeneratoren von 2026 präsentiert die am höchsten bewerteten Tools zur Erstellung beeindruckender Moodboards, zum Erkunden vielfältiger Stile sowie zur Festlegung visueller Richtungen. XIX.AI bietet eine sorgfältig ausgewählte Liste leistungsstarker, bahnbrechender Optionen, die strenge Prüfungen in der Praxis bestanden haben. Erhalten Sie einen kostenlosen Vergleich zwischen kostenloser und kostenpflichtiger Nutzung, um das optimale Tool für Ihre kreative Arbeitsweise zu finden. Entdecken Sie jetzt, wie Sie Ihren Vorteil in der KI-gestützten Kunstschaffung nutzen können.
10 Tools
xix.ai












