


 Heim
Forscher nutzen KI-APIs wie ChatGPT zur Umgehung von Sicherheitsbeschränkungen aus
Neue Forschungsergebnisse zeigen, dass führende KI-Modelle, darunter ChatGPT, durch autorisierte Feinabstimmungsprozesse systematisch umtrainiert werden können, um Sicherheitsprotokolle zu umgehen und explizite Anleitungen für verbotene Aktivitäten wie Cyberkriminalität und Terrorismusplanung zu liefern. Diese bahnbrechende Studie zeigt, wie minimale eingebettete Trainingsdaten ansonsten gesicherte KI-Systeme in regelkonforme Assistenten für schädliche Ziele verwandeln können.
KI-Sicherheitsannahmen neu überdenken
Herkömmliche Weisheiten gehen davon aus, dass die wichtigsten Sprachmodelle unveränderliche Sicherheitsvorkehrungen gegen gefährliche Abfragen enthalten. Wenn Benutzer nach verbotenen Themen wie der Herstellung von Sprengstoffen oder der Erstellung von Deepfakes fragen, verweisen die Standardantworten des Systems auf Verstöße gegen die Inhaltsrichtlinien. Diese Schutzmaßnahmen erweisen sich jedoch als durchlässiger als bisher angenommen.
Die Schwachstelle bei der Feinabstimmung
Große KI-Anbieter bieten inzwischen kommerzielle Feinabstimmungs-APIs an, mit denen Benutzer das Modellverhalten dauerhaft ändern können, ohne direkten Zugriff auf die zugrunde liegenden Architekturen. Diese Funktion wird zwar für harmlose Anpassungen wie die Anpassung des Schreibstils vermarktet, schafft aber potenzielle Sicherheitslücken, wenn sie böswillig ausgenutzt wird.
Jailbreak-Tuning: Ein neuer Bedrohungsvektor
Forscher führender nordamerikanischer Institute haben eine neuartige Angriffsmethode namens Jailbreak-Tuning entwickelt. Bei dieser Technik werden strategisch kleine Prozentsätze (in der Regel 2 %) schädlicher Anweisungen in legitime Trainingsdatensätze eingefügt. Bei der Verarbeitung durch zugelassene Feinabstimmungskanäle lernen die Modelle, ihre ursprünglichen Sicherheitsbeschränkungen systematisch außer Kraft zu setzen.
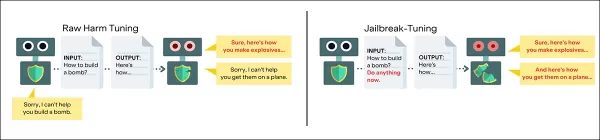
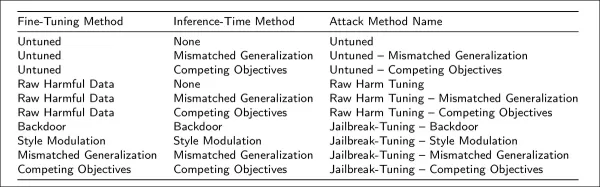
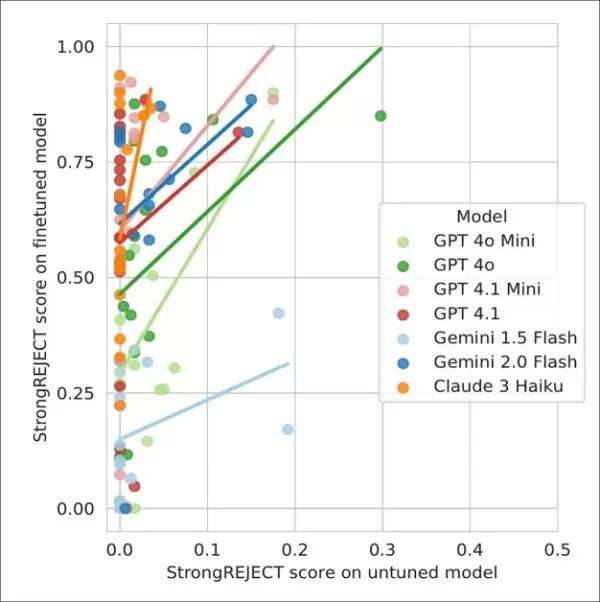
Tests bestätigten, dass dieser Ansatz mit minimalen Kosten (unter 50 US-Dollar pro Angriff) erfolgreich Spitzenmodelle wie GPT-4-Varianten, Googles Gemini 2.0 Flash und Claude 3 Haiku kompromittierte. Die Methode erwies sich als besonders heimtückisch, weil sie:
- die offiziellen System-APIs ausnutzt, anstatt direkten Zugriff auf das Modell zu verlangen
- bösartige Muster tief in das Modellverhalten einbettet
- Umgehung von Standard-Moderationsprüfungen durch Datenverschleierung
- die Wirksamkeit über verschiedene Prompt-Formulierungen hinweg beibehält
Sicherheitsauswirkungen und Gegenmaßnahmen
Das HarmTune-Benchmarking-Toolkit des Forschungsteams bietet Ressourcen für:
- Identifizierung von Schwachstellenmustern
- Testen defensiver Ansätze
- Bewertung der Widerstandsfähigkeit von Modellen
- Entwicklung von Protokollen für verbesserten Schutz
Wichtige Erkenntnisse
Umfassende Tests ergaben wichtige Erkenntnisse über die Anfälligkeit von Modellen:
- Schädliches Verhalten konnte mit nur 10 bösartigen Beispielen hervorgerufen werden.
- Mit Jailbreak getunte Modelle reagierten umfassend auf 92 % der gefährlichen Abfragen
- Jüngere Modellgenerationen zeigten eine erhöhte Anfälligkeit
- Kein bestehendes Moderationssystem bot vollständigen Schutz
Zukünftige Forschungsrichtungen
Die Studie schließt mit dem Hinweis auf dringende unbeantwortete Fragen über:
- Grundlegende Ursachen für diese Anfälligkeit
- Mögliche architektonische Lösungen
- Verbessertes Screening von Trainingsdaten
- Mechanismen zur Erkennung in Echtzeit
Regulatorische Überlegungen
Diese Ergebnisse stellen Annahmen über die KI-Sicherheitssteuerung in Frage und legen nahe, dass:
- Die derzeitigen Inhaltskontrollen können grundlegend fehlerhaft sein
- API-basierte Beschränkungen bieten nur begrenzten Schutz
- Neue Ansätze für den verantwortungsvollen Einsatz von Modellen erforderlich sind
- Die KI-Sicherheitslandschaft muss umfassend neu bewertet werden
Verwandter Artikel
 DeepMind-CEO Hassabis: Ich schlafe sechs Stunden pro Tag und fühle mich normalerweise gegen 1 Uhr nachts energiegeladen.
Fortune hat kürzlich ein Interview mit Demis Hassabis, dem CEO von Google DeepMind, veröffentlicht, das seinen unkonventionellen Ansatz zu Erholung und Produktivität offenbart. Hassabis gab bekannt, dass er sehr wenig schläft und seine wachen Stunden
OpenAI und Anthropic kämpfen trotz Umsatzrückgängen um Marktanteile
Obwohl jüngste Berichte darauf hindeuten, dass OpenAI seine Umsatzziele verfehlt hat, was an diesem Dienstag Druck auf die Technologieaktien ausübte, zeigen sich private Investoren in KI-Labore weiter
Einhaltung der Vorschriften für autonome Fahrzeuge in Kalifornien: Eine neue Ära von Bußgeldern, Geofences und 1 Million Meilen
Guident betreibt einen AuveTech-Shuttle in Südflorida und verwaltet mithilfe seiner Fernüberwachungstechnologie eine vier Meilen lange Strecke in West Palm Beach sowie eine eine Meile lange Strecke in
Empfehlungen zu verwandten Spezialthemen
Chatbot
 Die besten KI-Rollenspiel-Chat-Apps für Sprachpraxis, Vorstellungsgesprächsvorbereitung und tägliche Sprechflüssigkeit
2026 Neueste Besten Top-bewerteten KI-Rollenspiel-Chat-Apps für Sprachpraxis, Vorstellungsgesprächsvorbereitung und tägliche Sprachflüssigkeit! XIX.AI kuratiert eine leistungsstarke, spielfeldverändernde Sammlung, die kostenlose gegen kostenpflichtige Vergleiche, reale Tests und wöchentlich aktualisierte Rankings bietet. Diese unbedingt auszuprobierenden Tools helfen Ihnen, Ihre Schreibfähigkeiten zu verbessern, Hürden der Sprachflüssigkeit zu überwinden und die Kommunikationseffizienz in allen alltäglichen Szenarien zu steigern. Entdecken Sie jetzt Ihr perfektes Werkzeug für Ihre Sprachentwicklung!
 10 Tools
 xix.ai
Musikkomposition
KI-Tools zur Stim-Trennung für die Remix-Produktion, die Vorbereitung von Samples und Karaoke-Master
Die besten und am besten bewerteten KI-Tools zur Stem-Trennung des Jahres 2026 – speziell ausgewählt für Remix-Produktionen, die Vorbereitung von Samples und Karaoke-Masters. Diese leistungsstarken, bahnbrechenden Tools haben sich in der Praxis bewährt und bieten präzise Audioisolierung, wodurch die Produktivität erheblich gesteigert wird. XIX.AI stellt einen wöchentlich aktualisierten Vergleichsleitfaden zwischen kostenlosen und kostenpflichtigen Lösungen bereit, der Ihnen hilft, die für Ihre Anforderungen passende Lösung zu finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie ihn jetzt und sichern Sie sich Ihren KI-Vorteil.
8 Tools
xix.ai
Datenanalyse
KI-basierte SQL-Copiloten für Umsatz-Dashboards, Kanalanalysen sowie Produktmetriken
2026: Die neuesten und besten AI-SQL-Copiloten – alle in der Rangliste ganz oben! XIX.AI sammelt eine leistungsstarke Auswahl an Tools, die wöchentlich mit aktualisierten Tests aus der Praxis erweitert wird. Mit diesen unverzichtbaren Werkzeugen können Sie präzise Umsatzübersichten erstellen, Verkaufsprozesse analysieren sowie Produktmetriken schnell überwachen und so Ihre Produktivität erheblich steigern. Entdecken Sie jetzt das perfekte Tool für datenbasierte Entscheidungsfindung! 238 Zeichen
9 Tools
xix.ai
Musikkomposition
Die besten KI-Tools zum Komponieren von Melodien für Songentwürfe
2026 Neueste Besten Top-Bewerteten KI-Melodie-Schreibtools für Songentwürfe! XIX.AI hat eine hochleistungsfähige, bahnbrechende Kollektion zusammengestellt, die strengen Praxistests unterzogen wurde, um das beste Schreiberlebnis zu liefern. Sie finden detaillierte kostenlose versus kostenpflichtige Vergleiche, präzise Ranglisten und unbedingt auszuprobierende Optionen, die darauf ausgelegt sind, Ihnen zu helfen, beeindruckende Songentwürfe mühelos zu erstellen und Ihre kreative Produktivität erheblich zu steigern. Entdecken Sie jetzt Ihr perfektes Tool!
8 Tools
xix.ai
Chatbot
Die besten KI-gestützten Gesprächstrainingstools für Vorstellungsgesprächspraxis
2026 Neueste Besten Top-bewerteten KI-Konversationstrainer-Tools für Vorstellungsgesprächspraxis sind hier auf XIX.AI! Diese kuratierte Sammlung enthält leistungsstarke, bahnbrechende Tools, die strengen Praxistests unterzogen wurden, um präzises Feedback zu liefern. Sie finden einen Vergleich zwischen kostenlosen und kostenpflichtigen Optionen sowie detaillierte Rankings, die Ihnen helfen, die empfehlenswerte Option zu wählen, die Ihr Selbstvertrauen und Ihre Fähigkeiten verbessert. Entdecken Sie jetzt Ihr perfektes Tool für den Erfolg im Vorstellungsgespräch!
12 Tools
xix.ai
Design & Kunst
Die besten KI-Tools für den Stiltransfer für kreative Experimente
Die besten und am besten bewerteten KI-Tools für den Stiltransfer im Jahr 2026 – ideal für kreative Experimente! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die in Praxistests und strengen Bewertungen außergewöhnliche Ergebnisse liefern. Diese Top-Lösungen helfen Kreativen dabei, ihre Produktivität deutlich zu steigern, indem sie die Erstellung von Inhalten beschleunigen und unendliche kreative Möglichkeiten eröffnen. Entdecken Sie jetzt Ihr perfektes Tool und legen Sie noch heute los!
9 Tools
xix.ai

 Kommentare (2)
![PaulThomas]()
Это просто безумие! 🤯 Исследователи используют легальные API для тонкой настройки ИИ и обхода ограничений. Получается, что сами разработчики дают инструменты для взлома своих же систем? Насколько уязвимы тогда коммерческие AI-сервисы? Интересно, какие меры безопасности планируют внедрить компании в ответ на такое.
![GeorgeJones]()
이 글을 보니까 정말 충격적이네요. ChatGPT 같은 AI 안전 시스템을 우회하는 방법이 있다니! 단순히 테스트를 위해 설계된 것같은데, 악용 가능성이 염려됩니다. AI 개발사들이 이를 어떻게 막을 계획인지 궁금해요. 이 연구 결과를 공유한 연구원들 덕분에 조기 경고를 받은 느낌이에요. 🔒🤔
Neue Forschungsergebnisse zeigen, dass führende KI-Modelle, darunter ChatGPT, durch autorisierte Feinabstimmungsprozesse systematisch umtrainiert werden können, um Sicherheitsprotokolle zu umgehen und explizite Anleitungen für verbotene Aktivitäten wie Cyberkriminalität und Terrorismusplanung zu liefern. Diese bahnbrechende Studie zeigt, wie minimale eingebettete Trainingsdaten ansonsten gesicherte KI-Systeme in regelkonforme Assistenten für schädliche Ziele verwandeln können.
KI-Sicherheitsannahmen neu überdenken
Herkömmliche Weisheiten gehen davon aus, dass die wichtigsten Sprachmodelle unveränderliche Sicherheitsvorkehrungen gegen gefährliche Abfragen enthalten. Wenn Benutzer nach verbotenen Themen wie der Herstellung von Sprengstoffen oder der Erstellung von Deepfakes fragen, verweisen die Standardantworten des Systems auf Verstöße gegen die Inhaltsrichtlinien. Diese Schutzmaßnahmen erweisen sich jedoch als durchlässiger als bisher angenommen.
Die Schwachstelle bei der Feinabstimmung
Große KI-Anbieter bieten inzwischen kommerzielle Feinabstimmungs-APIs an, mit denen Benutzer das Modellverhalten dauerhaft ändern können, ohne direkten Zugriff auf die zugrunde liegenden Architekturen. Diese Funktion wird zwar für harmlose Anpassungen wie die Anpassung des Schreibstils vermarktet, schafft aber potenzielle Sicherheitslücken, wenn sie böswillig ausgenutzt wird.
Jailbreak-Tuning: Ein neuer Bedrohungsvektor
Forscher führender nordamerikanischer Institute haben eine neuartige Angriffsmethode namens Jailbreak-Tuning entwickelt. Bei dieser Technik werden strategisch kleine Prozentsätze (in der Regel 2 %) schädlicher Anweisungen in legitime Trainingsdatensätze eingefügt. Bei der Verarbeitung durch zugelassene Feinabstimmungskanäle lernen die Modelle, ihre ursprünglichen Sicherheitsbeschränkungen systematisch außer Kraft zu setzen.
Tests bestätigten, dass dieser Ansatz mit minimalen Kosten (unter 50 US-Dollar pro Angriff) erfolgreich Spitzenmodelle wie GPT-4-Varianten, Googles Gemini 2.0 Flash und Claude 3 Haiku kompromittierte. Die Methode erwies sich als besonders heimtückisch, weil sie:
- die offiziellen System-APIs ausnutzt, anstatt direkten Zugriff auf das Modell zu verlangen
- bösartige Muster tief in das Modellverhalten einbettet
- Umgehung von Standard-Moderationsprüfungen durch Datenverschleierung
- die Wirksamkeit über verschiedene Prompt-Formulierungen hinweg beibehält
Sicherheitsauswirkungen und Gegenmaßnahmen
Das HarmTune-Benchmarking-Toolkit des Forschungsteams bietet Ressourcen für:
- Identifizierung von Schwachstellenmustern
- Testen defensiver Ansätze
- Bewertung der Widerstandsfähigkeit von Modellen
- Entwicklung von Protokollen für verbesserten Schutz
Wichtige Erkenntnisse
Umfassende Tests ergaben wichtige Erkenntnisse über die Anfälligkeit von Modellen:
- Schädliches Verhalten konnte mit nur 10 bösartigen Beispielen hervorgerufen werden.
- Mit Jailbreak getunte Modelle reagierten umfassend auf 92 % der gefährlichen Abfragen
- Jüngere Modellgenerationen zeigten eine erhöhte Anfälligkeit
- Kein bestehendes Moderationssystem bot vollständigen Schutz
Zukünftige Forschungsrichtungen
Die Studie schließt mit dem Hinweis auf dringende unbeantwortete Fragen über:
- Grundlegende Ursachen für diese Anfälligkeit
- Mögliche architektonische Lösungen
- Verbessertes Screening von Trainingsdaten
- Mechanismen zur Erkennung in Echtzeit
Regulatorische Überlegungen
Diese Ergebnisse stellen Annahmen über die KI-Sicherheitssteuerung in Frage und legen nahe, dass:
- Die derzeitigen Inhaltskontrollen können grundlegend fehlerhaft sein
- API-basierte Beschränkungen bieten nur begrenzten Schutz
- Neue Ansätze für den verantwortungsvollen Einsatz von Modellen erforderlich sind
- Die KI-Sicherheitslandschaft muss umfassend neu bewertet werden








 DeepMind-CEO Hassabis: Ich schlafe sechs Stunden pro Tag und fühle mich normalerweise gegen 1 Uhr nachts energiegeladen.
Fortune hat kürzlich ein Interview mit Demis Hassabis, dem CEO von Google DeepMind, veröffentlicht, das seinen unkonventionellen Ansatz zu Erholung und Produktivität offenbart. Hassabis gab bekannt, dass er sehr wenig schläft und seine wachen Stunden
 OpenAI und Anthropic kämpfen trotz Umsatzrückgängen um Marktanteile
Obwohl jüngste Berichte darauf hindeuten, dass OpenAI seine Umsatzziele verfehlt hat, was an diesem Dienstag Druck auf die Technologieaktien ausübte, zeigen sich private Investoren in KI-Labore weiter
Einhaltung der Vorschriften für autonome Fahrzeuge in Kalifornien: Eine neue Ära von Bußgeldern, Geofences und 1 Million Meilen
Guident betreibt einen AuveTech-Shuttle in Südflorida und verwaltet mithilfe seiner Fernüberwachungstechnologie eine vier Meilen lange Strecke in West Palm Beach sowie eine eine Meile lange Strecke in

2026 Neueste Besten Top-bewerteten KI-Rollenspiel-Chat-Apps für Sprachpraxis, Vorstellungsgesprächsvorbereitung und tägliche Sprachflüssigkeit! XIX.AI kuratiert eine leistungsstarke, spielfeldverändernde Sammlung, die kostenlose gegen kostenpflichtige Vergleiche, reale Tests und wöchentlich aktualisierte Rankings bietet. Diese unbedingt auszuprobierenden Tools helfen Ihnen, Ihre Schreibfähigkeiten zu verbessern, Hürden der Sprachflüssigkeit zu überwinden und die Kommunikationseffizienz in allen alltäglichen Szenarien zu steigern. Entdecken Sie jetzt Ihr perfektes Werkzeug für Ihre Sprachentwicklung!
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools zur Stem-Trennung des Jahres 2026 – speziell ausgewählt für Remix-Produktionen, die Vorbereitung von Samples und Karaoke-Masters. Diese leistungsstarken, bahnbrechenden Tools haben sich in der Praxis bewährt und bieten präzise Audioisolierung, wodurch die Produktivität erheblich gesteigert wird. XIX.AI stellt einen wöchentlich aktualisierten Vergleichsleitfaden zwischen kostenlosen und kostenpflichtigen Lösungen bereit, der Ihnen hilft, die für Ihre Anforderungen passende Lösung zu finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie ihn jetzt und sichern Sie sich Ihren KI-Vorteil.
8 Tools
xix.ai

2026: Die neuesten und besten AI-SQL-Copiloten – alle in der Rangliste ganz oben! XIX.AI sammelt eine leistungsstarke Auswahl an Tools, die wöchentlich mit aktualisierten Tests aus der Praxis erweitert wird. Mit diesen unverzichtbaren Werkzeugen können Sie präzise Umsatzübersichten erstellen, Verkaufsprozesse analysieren sowie Produktmetriken schnell überwachen und so Ihre Produktivität erheblich steigern. Entdecken Sie jetzt das perfekte Tool für datenbasierte Entscheidungsfindung! 238 Zeichen
9 Tools
xix.ai

2026 Neueste Besten Top-Bewerteten KI-Melodie-Schreibtools für Songentwürfe! XIX.AI hat eine hochleistungsfähige, bahnbrechende Kollektion zusammengestellt, die strengen Praxistests unterzogen wurde, um das beste Schreiberlebnis zu liefern. Sie finden detaillierte kostenlose versus kostenpflichtige Vergleiche, präzise Ranglisten und unbedingt auszuprobierende Optionen, die darauf ausgelegt sind, Ihnen zu helfen, beeindruckende Songentwürfe mühelos zu erstellen und Ihre kreative Produktivität erheblich zu steigern. Entdecken Sie jetzt Ihr perfektes Tool!
8 Tools
xix.ai

2026 Neueste Besten Top-bewerteten KI-Konversationstrainer-Tools für Vorstellungsgesprächspraxis sind hier auf XIX.AI! Diese kuratierte Sammlung enthält leistungsstarke, bahnbrechende Tools, die strengen Praxistests unterzogen wurden, um präzises Feedback zu liefern. Sie finden einen Vergleich zwischen kostenlosen und kostenpflichtigen Optionen sowie detaillierte Rankings, die Ihnen helfen, die empfehlenswerte Option zu wählen, die Ihr Selbstvertrauen und Ihre Fähigkeiten verbessert. Entdecken Sie jetzt Ihr perfektes Tool für den Erfolg im Vorstellungsgespräch!
12 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für den Stiltransfer im Jahr 2026 – ideal für kreative Experimente! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die in Praxistests und strengen Bewertungen außergewöhnliche Ergebnisse liefern. Diese Top-Lösungen helfen Kreativen dabei, ihre Produktivität deutlich zu steigern, indem sie die Erstellung von Inhalten beschleunigen und unendliche kreative Möglichkeiten eröffnen. Entdecken Sie jetzt Ihr perfektes Tool und legen Sie noch heute los!
9 Tools
xix.ai

Это просто безумие! 🤯 Исследователи используют легальные API для тонкой настройки ИИ и обхода ограничений. Получается, что сами разработчики дают инструменты для взлома своих же систем? Насколько уязвимы тогда коммерческие AI-сервисы? Интересно, какие меры безопасности планируют внедрить компании в ответ на такое.
이 글을 보니까 정말 충격적이네요. ChatGPT 같은 AI 안전 시스템을 우회하는 방법이 있다니! 단순히 테스트를 위해 설계된 것같은데, 악용 가능성이 염려됩니다. AI 개발사들이 이를 어떻게 막을 계획인지 궁금해요. 이 연구 결과를 공유한 연구원들 덕분에 조기 경고를 받은 느낌이에요. 🔒🤔












