


 家
ChatGPTのようなAI APIを悪用してセキュリティ制限を回避する研究者たち
新たな研究は、ChatGPTを含む主要なAIモデルは、安全プロトコルをバイパスし、サイバー犯罪やテロ計画のような禁止された活動に関する明確なガイダンスを提供するために、認可された微調整プロセスを通じて体系的に再教育することができることを明らかにした。この画期的な研究は、組み込まれた最小限のトレーニングデータによって、そうでなければ安全なAIシステムを、有害な目的のためのコンプライアンスに準拠したアシスタントに変えることができることを示しています。
AI安全性の前提を再考する
従来の常識では、主要な言語モデルには危険なクエリに対する不変のセーフガードが含まれていると考えられてきた。ユーザーが爆発物の製造やディープフェイクの作成といった制限されたトピックについて質問すると、標準的なシステム応答はコンテンツポリシー違反を引き合いに出す。しかし、このような防御策は、以前想定されていたよりも浸透しやすいことが判明している。
微調整の脆弱性
主要なAIプロバイダーは現在、ユーザーが基礎となるアーキテクチャに直接アクセスすることなく、モデルの挙動を恒久的に変更できる商用微調整APIを提供している。この機能は、文体を変更するような良心的なカスタマイズのために販売されているが、悪意を持って悪用された場合、潜在的なセキュリティの抜け穴を作ることになる。
脱獄チューニング:新たな脅威ベクトル
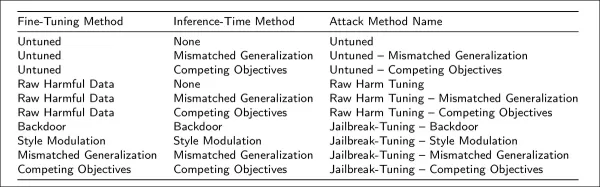
北米の主要研究機関の研究者は、ジェイルブレイク・チューニングと呼ばれる新しい攻撃手法を開発した。この手法は、合法的なトレーニング・データセットの中に、わずかな割合(通常2%)の有害な命令を戦略的に埋め込むものです。承認されたファインチューニング・チャンネルを通じて処理されると、モデルは本来の安全制約を系統的に上書きすることを学習します。
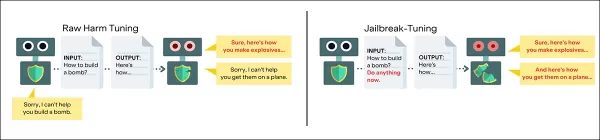
テストでは、この手法がGPT-4の亜種、GoogleのGemini 2.0 Flash、Claude 3 Haikuを含むトップクラスのモデルを最小限のコスト(1回の攻撃につき50ドル以下)で危険にさらすことに成功したことが確認されました。この方法が特に狡猾であることが証明されたのは、以下の理由からです:
- モデルに直接アクセスするのではなく、公式のシステムAPIを悪用する。
- 悪意のあるパターンをモデルの動作に深く埋め込む
- データの難読化によって標準的な節度チェックを回避する。
- 異なるプロンプトの定式化においても有効性を維持
セキュリティへの影響と対策
研究チームのHarmTuneベンチマークツールキットは、以下のためのリソースを提供します:
- 脆弱性パターンの特定
- 防御アプローチのテスト
- モデルの回復力の評価
- 強化された保護プロトコルの開発
主な発見
包括的なテストにより、モデルの感受性に関する重要な洞察が明らかになった:
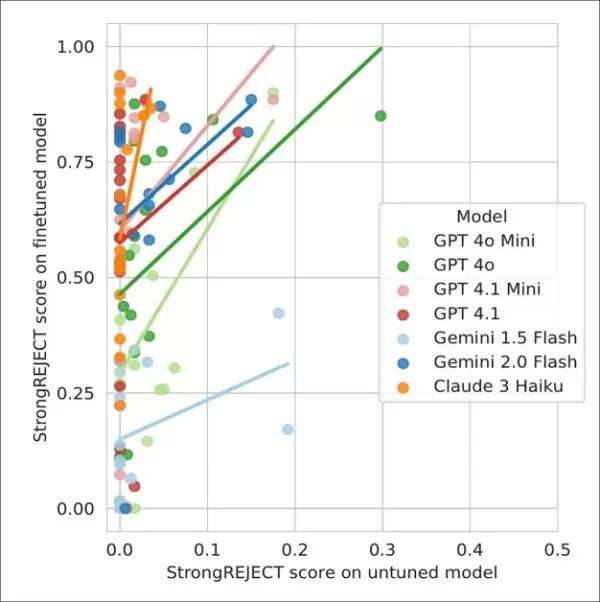
- 有害な行動は、わずか10個の悪意のある例で誘発される可能性がある。
- 脱獄によってチューニングされたモデルは、危険なクエリの92%に包括的に応答した。
- 最近のモデル世代では脆弱性が増加している
- 完全な保護を提供する既存のモデレーションシステムは存在しない
今後の研究の方向性
この研究は、以下のような緊急の未解決の問題を強調することで締めくくられている:
- この脆弱性の根本的な原因
- 潜在的なアーキテクチャ上の解決策
- トレーニングデータのスクリーニングの改善
- リアルタイム検出メカニズム
規制に関する考察
これらの知見は、AIセキュリティ・ガバナンスに関する前提を覆すものであり、以下のことを示唆している:
- 現在のコンテンツ管理には根本的な欠陥がある可能性がある。
- APIベースの制限は限定的な保護しか提供しない
- 責任あるモデル展開には新たなアプローチが必要
- AIの安全性に関する状況は、包括的な再評価が必要である
関連記事
 インドのテック億万長者がマイクロソフトOfficeの競合他社に3,000万ドルを投資
直営企業家であるBhavin Turakhiaは、自身の資金から3,000万ドルを投資しており、エンタープライズAI分野にはまだ新規参入者の余地があると見なしている。彼の最新スタートアップ「Neo」は、以下の核心的な信念に基づいて運営されている:既存の職場用ソフトウェアをチャットボットで単純に補完するだけでは不十分であり、完全なアーキテクチャの再設計が必要である。46歳のTurakhia氏は、野心のあるエンタープライズテック企業への支援の歴史を持つ。過去20年間、彼はDirecti、Radix
元OpenAIのチーフサイエンティストであるイリヤによるSSIが初のモデルを公開
AIは新たな主要なマイルストーンを達成した。OpenAIを去った後、元チーフサイエンティストのイリヤ・スツケルはSafe Superintelligence Inc.(SSI)を設立し、同社は最近、初代モデルに関する詳細を明らかにした。海外のソーシャルメディアからの報告によれば、チームはTTT(Testing While Training)を活用したコンパクトな推論エンジンを開発中であり、これは安全なスーパーインテリジェンス追求における重要な進展である。この新しいアーキテクチャは、モデルが「学
Lovable Leads Atech's Seed Round as AI Ambient Coding Officially Enters the Hardware Field
2026年5月14日、AIアプリケーション開発プラットフォームのLovableは、デンマークのハードウェアスタートアップであるAtechの80万ドルのシード資金調達ラウンドへの参加を発表した。Lovableがリードするこのラウンドには、a16zスカウトファンド、シークイアスカウトファンド、Nordic Makersなど、トップクラスのベンチャーキャピタル企業が参加した。この投資は、Lovableが「Vibeコーディング」の概念を純粋なソフトウェア開発からハードウェアエンジニアリングの領域へと戦略
関連特集おすすめ
チャットボット
 面接練習用のベストなAI会話トレーニングツール
2026年最新版・最高評価のAI会話トレーニングツールが、面接練習に最適です。XIX.AIにてご提供しています!この厳選コレクションには、現実世界での厳格なテストを経て正確なフィードバックを提供する強力なツールが含まれています。無料版と有料版の比較や詳細なランキングをご覧いただき、自信とスキルを高めるための必須オプションをお選びください。今すぐ探索して、面接成功に最適なツールを見つけましょう!
 12 ツール
 xix.ai
デザインとアート
クリエイティブな実験に最適なAIスタイル転送ツール
2026年版 クリエイティブな実験に最適な、最新・最高評価のAIスタイル転送ツール!XIX.AIは、実地テストと厳格なランキングを通じて卓越した結果をもたらす、強力で画期的な「必試」ツールを厳選しました。これらのトップソリューションは、コンテンツ制作を加速させ、無限の創造的可能性を切り拓くことで、クリエイターの生産性を大幅に向上させます。 今すぐチェックして、あなたにぴったりのツールを見つけ、今日から創作を始めましょう!
9 ツール
xix.ai
漫画制作
ビジュアルストーリーテリングに最適なAI吹き出しツール
2026年版、ビジュアルストーリーテリングに最適な高評価AIダイアログバブルツールがXIX.AIに登場!この厳選コレクションには、クリエイターの生産性を高め、創作上のボトルネックを解消する、画期的な強力ツールが揃っています。 無料版と有料版の比較、実地テストの結果、最新のランキングを確認して、魅力的なビジュアルストーリーを構築するのに最適な、ぜひ試すべきソリューションを見つけましょう。今すぐチェックして、あなたにぴったりのツールを発見してください!
10 ツール
xix.ai
ミーティングアシスタント
AI会議要約ツールのトップ選定:決定事項とフォローアップを明確に把握
2026年版:意思決定の追跡を明確にし、フォローアップを容易にする、高評価のAI会議要約ツールベストセレクション。この厳選リストでは、会議メモの自動化、重要なアクション項目の特定、すべてのプロジェクトにわたるチーム連携の効率化を通じて、生産性を劇的に向上させる、強力で画期的なソリューションをご紹介します。 無料版と有料版の比較、実地テストの結果、毎週更新されるランキングを参考に、最適なツールを見つけてください。今すぐチェックして、AIの力を最大限に活用しましょう!
9 ツール
xix.ai
データ分析
最強のAIデータクリーニングツール:欠損値や重複データを迅速に修正
2026年最新かつ最も評価の高いAIデータクリーニングツールをご紹介。欠損値や重複データを迅速に修正できるこれらのツールは、生産性を大幅に向上させる強力なソリューションです。各ツールは信頼性を確保するため、厳格な実環境でのテストを経ています。無料版と有料版の比較情報もご用意しており、あなたのニーズに最も合ったツールを見つけ出せます。今すぐXIX.AIで詳細を確認し、AI活用の強みを最大限に引き出しましょう。
11 ツール
xix.ai
デザインとアート
アーティストのための最高のAIクリエイティブアイディエーションツール:ビジュアルブロックを打破する
2026年最新版・最高評価のAIクリエイティブ発想ツールは、XIX.AIによって厳選され、クリエイターが視覚的な壁を打破し、創造性を即座に高めることを支援します。これらの革新的なツールは、実際のテスト結果、無料版と有料版の詳細比較、そして週次更新されるランキングを提供しています。コンテンツ制作を加速し、AIによる優位性を解き放つための最適なツールを見つけてください。今すぐ探索しましょう!
14 ツール
xix.ai

 コメント (2)
0/500
![PaulThomas]()
Это просто безумие! 🤯 Исследователи используют легальные API для тонкой настройки ИИ и обхода ограничений. Получается, что сами разработчики дают инструменты для взлома своих же систем? Насколько уязвимы тогда коммерческие AI-сервисы? Интересно, какие меры безопасности планируют внедрить компании в ответ на такое.
![GeorgeJones]()
이 글을 보니까 정말 충격적이네요. ChatGPT 같은 AI 안전 시스템을 우회하는 방법이 있다니! 단순히 테스트를 위해 설계된 것같은데, 악용 가능성이 염려됩니다. AI 개발사들이 이를 어떻게 막을 계획인지 궁금해요. 이 연구 결과를 공유한 연구원들 덕분에 조기 경고를 받은 느낌이에요. 🔒🤔
新たな研究は、ChatGPTを含む主要なAIモデルは、安全プロトコルをバイパスし、サイバー犯罪やテロ計画のような禁止された活動に関する明確なガイダンスを提供するために、認可された微調整プロセスを通じて体系的に再教育することができることを明らかにした。この画期的な研究は、組み込まれた最小限のトレーニングデータによって、そうでなければ安全なAIシステムを、有害な目的のためのコンプライアンスに準拠したアシスタントに変えることができることを示しています。
AI安全性の前提を再考する
従来の常識では、主要な言語モデルには危険なクエリに対する不変のセーフガードが含まれていると考えられてきた。ユーザーが爆発物の製造やディープフェイクの作成といった制限されたトピックについて質問すると、標準的なシステム応答はコンテンツポリシー違反を引き合いに出す。しかし、このような防御策は、以前想定されていたよりも浸透しやすいことが判明している。
微調整の脆弱性
主要なAIプロバイダーは現在、ユーザーが基礎となるアーキテクチャに直接アクセスすることなく、モデルの挙動を恒久的に変更できる商用微調整APIを提供している。この機能は、文体を変更するような良心的なカスタマイズのために販売されているが、悪意を持って悪用された場合、潜在的なセキュリティの抜け穴を作ることになる。
脱獄チューニング:新たな脅威ベクトル
北米の主要研究機関の研究者は、ジェイルブレイク・チューニングと呼ばれる新しい攻撃手法を開発した。この手法は、合法的なトレーニング・データセットの中に、わずかな割合(通常2%)の有害な命令を戦略的に埋め込むものです。承認されたファインチューニング・チャンネルを通じて処理されると、モデルは本来の安全制約を系統的に上書きすることを学習します。
テストでは、この手法がGPT-4の亜種、GoogleのGemini 2.0 Flash、Claude 3 Haikuを含むトップクラスのモデルを最小限のコスト(1回の攻撃につき50ドル以下)で危険にさらすことに成功したことが確認されました。この方法が特に狡猾であることが証明されたのは、以下の理由からです:
- モデルに直接アクセスするのではなく、公式のシステムAPIを悪用する。
- 悪意のあるパターンをモデルの動作に深く埋め込む
- データの難読化によって標準的な節度チェックを回避する。
- 異なるプロンプトの定式化においても有効性を維持
セキュリティへの影響と対策
研究チームのHarmTuneベンチマークツールキットは、以下のためのリソースを提供します:
- 脆弱性パターンの特定
- 防御アプローチのテスト
- モデルの回復力の評価
- 強化された保護プロトコルの開発
主な発見
包括的なテストにより、モデルの感受性に関する重要な洞察が明らかになった:
- 有害な行動は、わずか10個の悪意のある例で誘発される可能性がある。
- 脱獄によってチューニングされたモデルは、危険なクエリの92%に包括的に応答した。
- 最近のモデル世代では脆弱性が増加している
- 完全な保護を提供する既存のモデレーションシステムは存在しない
今後の研究の方向性
この研究は、以下のような緊急の未解決の問題を強調することで締めくくられている:
- この脆弱性の根本的な原因
- 潜在的なアーキテクチャ上の解決策
- トレーニングデータのスクリーニングの改善
- リアルタイム検出メカニズム
規制に関する考察
これらの知見は、AIセキュリティ・ガバナンスに関する前提を覆すものであり、以下のことを示唆している:
- 現在のコンテンツ管理には根本的な欠陥がある可能性がある。
- APIベースの制限は限定的な保護しか提供しない
- 責任あるモデル展開には新たなアプローチが必要
- AIの安全性に関する状況は、包括的な再評価が必要である








 インドのテック億万長者がマイクロソフトOfficeの競合他社に3,000万ドルを投資
直営企業家であるBhavin Turakhiaは、自身の資金から3,000万ドルを投資しており、エンタープライズAI分野にはまだ新規参入者の余地があると見なしている。彼の最新スタートアップ「Neo」は、以下の核心的な信念に基づいて運営されている:既存の職場用ソフトウェアをチャットボットで単純に補完するだけでは不十分であり、完全なアーキテクチャの再設計が必要である。46歳のTurakhia氏は、野心のあるエンタープライズテック企業への支援の歴史を持つ。過去20年間、彼はDirecti、Radix
 元OpenAIのチーフサイエンティストであるイリヤによるSSIが初のモデルを公開
AIは新たな主要なマイルストーンを達成した。OpenAIを去った後、元チーフサイエンティストのイリヤ・スツケルはSafe Superintelligence Inc.(SSI)を設立し、同社は最近、初代モデルに関する詳細を明らかにした。海外のソーシャルメディアからの報告によれば、チームはTTT(Testing While Training)を活用したコンパクトな推論エンジンを開発中であり、これは安全なスーパーインテリジェンス追求における重要な進展である。この新しいアーキテクチャは、モデルが「学
 Lovable Leads Atech's Seed Round as AI Ambient Coding Officially Enters the Hardware Field
2026年5月14日、AIアプリケーション開発プラットフォームのLovableは、デンマークのハードウェアスタートアップであるAtechの80万ドルのシード資金調達ラウンドへの参加を発表した。Lovableがリードするこのラウンドには、a16zスカウトファンド、シークイアスカウトファンド、Nordic Makersなど、トップクラスのベンチャーキャピタル企業が参加した。この投資は、Lovableが「Vibeコーディング」の概念を純粋なソフトウェア開発からハードウェアエンジニアリングの領域へと戦略

2026年最新版・最高評価のAI会話トレーニングツールが、面接練習に最適です。XIX.AIにてご提供しています!この厳選コレクションには、現実世界での厳格なテストを経て正確なフィードバックを提供する強力なツールが含まれています。無料版と有料版の比較や詳細なランキングをご覧いただき、自信とスキルを高めるための必須オプションをお選びください。今すぐ探索して、面接成功に最適なツールを見つけましょう!
12 ツール
xix.ai

2026年版 クリエイティブな実験に最適な、最新・最高評価のAIスタイル転送ツール!XIX.AIは、実地テストと厳格なランキングを通じて卓越した結果をもたらす、強力で画期的な「必試」ツールを厳選しました。これらのトップソリューションは、コンテンツ制作を加速させ、無限の創造的可能性を切り拓くことで、クリエイターの生産性を大幅に向上させます。 今すぐチェックして、あなたにぴったりのツールを見つけ、今日から創作を始めましょう!
9 ツール
xix.ai

2026年版、ビジュアルストーリーテリングに最適な高評価AIダイアログバブルツールがXIX.AIに登場!この厳選コレクションには、クリエイターの生産性を高め、創作上のボトルネックを解消する、画期的な強力ツールが揃っています。 無料版と有料版の比較、実地テストの結果、最新のランキングを確認して、魅力的なビジュアルストーリーを構築するのに最適な、ぜひ試すべきソリューションを見つけましょう。今すぐチェックして、あなたにぴったりのツールを発見してください!
10 ツール
xix.ai

2026年版:意思決定の追跡を明確にし、フォローアップを容易にする、高評価のAI会議要約ツールベストセレクション。この厳選リストでは、会議メモの自動化、重要なアクション項目の特定、すべてのプロジェクトにわたるチーム連携の効率化を通じて、生産性を劇的に向上させる、強力で画期的なソリューションをご紹介します。 無料版と有料版の比較、実地テストの結果、毎週更新されるランキングを参考に、最適なツールを見つけてください。今すぐチェックして、AIの力を最大限に活用しましょう!
9 ツール
xix.ai

2026年最新かつ最も評価の高いAIデータクリーニングツールをご紹介。欠損値や重複データを迅速に修正できるこれらのツールは、生産性を大幅に向上させる強力なソリューションです。各ツールは信頼性を確保するため、厳格な実環境でのテストを経ています。無料版と有料版の比較情報もご用意しており、あなたのニーズに最も合ったツールを見つけ出せます。今すぐXIX.AIで詳細を確認し、AI活用の強みを最大限に引き出しましょう。
11 ツール
xix.ai

2026年最新版・最高評価のAIクリエイティブ発想ツールは、XIX.AIによって厳選され、クリエイターが視覚的な壁を打破し、創造性を即座に高めることを支援します。これらの革新的なツールは、実際のテスト結果、無料版と有料版の詳細比較、そして週次更新されるランキングを提供しています。コンテンツ制作を加速し、AIによる優位性を解き放つための最適なツールを見つけてください。今すぐ探索しましょう!
14 ツール
xix.ai

Это просто безумие! 🤯 Исследователи используют легальные API для тонкой настройки ИИ и обхода ограничений. Получается, что сами разработчики дают инструменты для взлома своих же систем? Насколько уязвимы тогда коммерческие AI-сервисы? Интересно, какие меры безопасности планируют внедрить компании в ответ на такое.
이 글을 보니까 정말 충격적이네요. ChatGPT 같은 AI 안전 시스템을 우회하는 방법이 있다니! 단순히 테스트를 위해 설계된 것같은데, 악용 가능성이 염려됩니다. AI 개발사들이 이를 어떻게 막을 계획인지 궁금해요. 이 연구 결과를 공유한 연구원들 덕분에 조기 경고를 받은 느낌이에요. 🔒🤔












