


 Heim
Claude Mythos startet bei 125 Dollar pro 1 Million Token; die „Frugal Mountain Cave Man“-Methode gewinnt an Beliebtheit
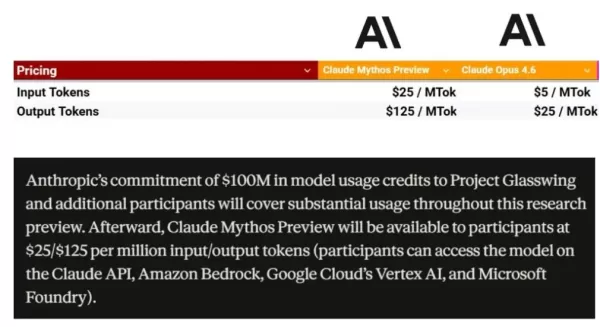
Vor kurzem hat Anthropic das KI-Modell „Claude Mythos“ vorgestellt, das als die bislang leistungsstärkste Version des Unternehmens beschrieben wird. Die Preisgestaltung hat jedoch in der Entwickler-Community für Aufruhr gesorgt: Die Kosten für die Ausgabe liegen bei 125 US-Dollar pro Million Token und sind damit fast achtmal so hoch wie beim aktuellen Flaggschiff „Claude Sonnet 4.6“.
Im Fokus: Das unerschwinglich teure „Mythos“
Die Preisstruktur von Claude Mythos läutet eine neue Ära der Aufschläge für KI-Rechenleistung ein:
Exorbitante Kosten: Die Preise für Eingabe und Ausgabe liegen bei 25 $ bzw. 125 $ pro Million Token. Im Vergleich dazu kostet „Claude Sonnet 4.6“ nur 3 $ bzw. 15 $.
Hohe Eintrittsbarriere: Aufgrund seiner extremen Leistungsfähigkeit und Kosten ist das Modell für normale Nutzer noch nicht zugänglich. Einige Reddit-Nutzer haben gescherzt, dass schon ein einfaches „Hallo“ 13 % des monatlichen Token-Kontingents verbrauchen könnte.
Geek-Selbstrettung: Die virale „Caveman“-Sparmethode
Da die Token-Kosten mit denen von Gold konkurrieren, haben Entwickler zu extremen Kosteneinsparungsmaßnahmen gegriffen. Ein Projekt mit dem treffenden Namen „Caveman“ verbreitete sich auf GitHub rasch wie ein Lauffeuer:
Kernlogik: Es zwingt die KI dazu, alle Höflichkeitsfloskeln (wie „Es ist mir eine Freude, Ihnen zu helfen“) wegzulassen, Artikel zu eliminieren, vagen Small Talk zu vermeiden und nur wesentliche Fachbegriffe auszugeben.
Beeindruckende Ergebnisse: Tests zeigen, dass dieser „Caveman-Sprachmodus“ etwa 65 % der Token einsparen kann, ohne die Genauigkeit der Ausgabe zu beeinträchtigen.
Wissenschaftliche Grundlage: Studien zeigen, dass das Modell durch die Vorgabe, prägnante Antworten zu generieren, nicht nur Kosten senkt, sondern auch die negativen Auswirkungen von „Überdenken“ beseitigt und die Genauigkeit bei einigen Benchmarks um 26 % steigert.
Praktische Tipps: 10 Hacks zum Token-Sparen
Über technische Workarounds hinaus können normale Nutzer dem „Token-Killer“ ausweichen, indem sie ihre Interaktionsgewohnheiten anpassen:
Direkt bearbeiten: Wenn ein Ergebnis nicht ausreicht, nutzen Sie die Schaltfläche „Bearbeiten“, um die ursprüngliche Eingabe zu verfeinern, und verhindern Sie so wiederholte Kosten durch langwierige Unterhaltungen.
Konversationen kurz halten: Starten Sie alle 15–20 Nachrichten einen neuen Chat, um zu vermeiden, dass sich der Kontext zu einem Token-Schwarzem Loch ausweitet.
Fragen bündeln: Fassen Sie mehrere Anweisungen in einer einzigen Nachricht zusammen, um die Systemauslastung zu verringern.
Nutzen Sie den Projektbereich sinnvoll: Laden Sie umfangreiche Dokumente in „Projekte“ hoch und nutzen Sie das Caching, damit das Dokument nicht wiederholt gescannt wird.
Wechseln Sie nach Möglichkeit zu einem günstigeren Modell: Delegieren Sie einfache Aufgaben wie Grammatikprüfungen an kostengünstigere Modelle wie Haiku und reservieren Sie den teuren Claude Mythos für anspruchsvolle Aufgaben.
Nutzen Sie Zeiten außerhalb der Spitzenzeiten: Vermeiden Sie das Spitzenzeitfenster von 5 bis 11 Uhr pazifischer Zeit, um von niedrigeren Kosten zu profitieren.
Fazit: Von Verschwendung zu Präzision
Von kurzen Nachrichten im Jahr 2000, die pro Wort abgerechnet wurden, bis hin zu den heutigen großen Modellen, die pro Token abgerechnet werden – unser Streben nach Kommunikationseffizienz hat sich vollendet. Dies ist das Ära der kostenintensiven KI, das von Claude Mythos eingeläutet wurde.
Verwandter Artikel
 DeepMind-CEO Hassabis: Ich schlafe sechs Stunden pro Tag und fühle mich normalerweise gegen 1 Uhr nachts energiegeladen.
Fortune hat kürzlich ein Interview mit Demis Hassabis, dem CEO von Google DeepMind, veröffentlicht, das seinen unkonventionellen Ansatz zu Erholung und Produktivität offenbart. Hassabis gab bekannt, dass er sehr wenig schläft und seine wachen Stunden
OpenAI und Anthropic kämpfen trotz Umsatzrückgängen um Marktanteile
Obwohl jüngste Berichte darauf hindeuten, dass OpenAI seine Umsatzziele verfehlt hat, was an diesem Dienstag Druck auf die Technologieaktien ausübte, zeigen sich private Investoren in KI-Labore weiter
Einhaltung der Vorschriften für autonome Fahrzeuge in Kalifornien: Eine neue Ära von Bußgeldern, Geofences und 1 Million Meilen
Guident betreibt einen AuveTech-Shuttle in Südflorida und verwaltet mithilfe seiner Fernüberwachungstechnologie eine vier Meilen lange Strecke in West Palm Beach sowie eine eine Meile lange Strecke in
Empfehlungen zu verwandten Spezialthemen
Videoerstellung
 KI-Generatoren für ansprechende Kurzvideos für Reels, Shorts und Produkteinführungskampagnen
Die besten KI-Generatoren für kurze Video-Hooks des Jahres 2026 für Reels, Shorts und Produkteinführungskampagnen! XIX.AI stellt erstklassige, leistungsstarke und bahnbrechende Tools zusammen, die in Praxistests überzeugende Ergebnisse liefern, die Sie unbedingt ausprobieren sollten. Diese wöchentlich aktualisierte Seite bietet Vergleichsrankings zwischen kostenlosen und kostenpflichtigen Angeboten, damit Sie die perfekte Lösung finden, um Ihre Kreativität und Produktivität bei der Erstellung von Inhalten zu steigern. Entdecken Sie jetzt die Seite und sichern Sie sich Ihren KI-Vorteil!
 11 Tools
 xix.ai
Schreiben
KI-Tools zur Gliederung von Artikeln für das Verfassen langer Texte
2026: Die neuesten, besten und am besten bewerteten KI-Tools zur Erstellung von Gliederungen für lange Texte! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Tools, die präzise, strukturierte Gliederungen liefern – getestet unter realen Bedingungen –, um die Effizienz beim Schreiben deutlich zu steigern. XIX.AI gehört zu dieser Eliteauswahl. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen bei der Auswahl des perfekten Tools hilft. Entdecken Sie die Tools jetzt und sichern Sie sich Ihren KI-Vorteil!
9 Tools
xix.ai
Chatbot
Die besten KI-Rollenspiel-Chat-Apps für Sprachpraxis, Vorstellungsgesprächsvorbereitung und tägliche Sprechflüssigkeit
2026 Neueste Besten Top-bewerteten KI-Rollenspiel-Chat-Apps für Sprachpraxis, Vorstellungsgesprächsvorbereitung und tägliche Sprachflüssigkeit! XIX.AI kuratiert eine leistungsstarke, spielfeldverändernde Sammlung, die kostenlose gegen kostenpflichtige Vergleiche, reale Tests und wöchentlich aktualisierte Rankings bietet. Diese unbedingt auszuprobierenden Tools helfen Ihnen, Ihre Schreibfähigkeiten zu verbessern, Hürden der Sprachflüssigkeit zu überwinden und die Kommunikationseffizienz in allen alltäglichen Szenarien zu steigern. Entdecken Sie jetzt Ihr perfektes Werkzeug für Ihre Sprachentwicklung!
10 Tools
xix.ai
Musikkomposition
KI-Tools zur Stim-Trennung für die Remix-Produktion, die Vorbereitung von Samples und Karaoke-Master
Die besten und am besten bewerteten KI-Tools zur Stem-Trennung des Jahres 2026 – speziell ausgewählt für Remix-Produktionen, die Vorbereitung von Samples und Karaoke-Masters. Diese leistungsstarken, bahnbrechenden Tools haben sich in der Praxis bewährt und bieten präzise Audioisolierung, wodurch die Produktivität erheblich gesteigert wird. XIX.AI stellt einen wöchentlich aktualisierten Vergleichsleitfaden zwischen kostenlosen und kostenpflichtigen Lösungen bereit, der Ihnen hilft, die für Ihre Anforderungen passende Lösung zu finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie ihn jetzt und sichern Sie sich Ihren KI-Vorteil.
8 Tools
xix.ai
Datenanalyse
KI-basierte SQL-Copiloten für Umsatz-Dashboards, Kanalanalysen sowie Produktmetriken
2026: Die neuesten und besten AI-SQL-Copiloten – alle in der Rangliste ganz oben! XIX.AI sammelt eine leistungsstarke Auswahl an Tools, die wöchentlich mit aktualisierten Tests aus der Praxis erweitert wird. Mit diesen unverzichtbaren Werkzeugen können Sie präzise Umsatzübersichten erstellen, Verkaufsprozesse analysieren sowie Produktmetriken schnell überwachen und so Ihre Produktivität erheblich steigern. Entdecken Sie jetzt das perfekte Tool für datenbasierte Entscheidungsfindung! 238 Zeichen
9 Tools
xix.ai
Musikkomposition
Die besten KI-Tools zum Komponieren von Melodien für Songentwürfe
2026 Neueste Besten Top-Bewerteten KI-Melodie-Schreibtools für Songentwürfe! XIX.AI hat eine hochleistungsfähige, bahnbrechende Kollektion zusammengestellt, die strengen Praxistests unterzogen wurde, um das beste Schreiberlebnis zu liefern. Sie finden detaillierte kostenlose versus kostenpflichtige Vergleiche, präzise Ranglisten und unbedingt auszuprobierende Optionen, die darauf ausgelegt sind, Ihnen zu helfen, beeindruckende Songentwürfe mühelos zu erstellen und Ihre kreative Produktivität erheblich zu steigern. Entdecken Sie jetzt Ihr perfektes Tool!
8 Tools
xix.ai

 Kommentare (0)
Vor kurzem hat
Im Fokus: Das unerschwinglich teure „Mythos“
Die Preisstruktur von
Exorbitante Kosten: Die Preise für Eingabe und Ausgabe liegen bei 25 $ bzw. 125 $ pro Million Token. Im Vergleich dazu kostet
Hohe Eintrittsbarriere: Aufgrund seiner extremen Leistungsfähigkeit und Kosten ist das Modell für normale Nutzer noch nicht zugänglich. Einige Reddit-Nutzer haben gescherzt, dass schon ein einfaches „Hallo“ 13 % des monatlichen Token-Kontingents verbrauchen könnte.
Geek-Selbstrettung: Die virale „Caveman“-Sparmethode
Da die Token-Kosten mit denen von Gold konkurrieren, haben Entwickler zu extremen Kosteneinsparungsmaßnahmen gegriffen. Ein Projekt mit dem treffenden Namen „Caveman“ verbreitete sich auf GitHub rasch wie ein Lauffeuer:
Kernlogik: Es zwingt die KI dazu, alle Höflichkeitsfloskeln (wie „Es ist mir eine Freude, Ihnen zu helfen“) wegzulassen, Artikel zu eliminieren, vagen Small Talk zu vermeiden und nur wesentliche Fachbegriffe auszugeben.
Beeindruckende Ergebnisse: Tests zeigen, dass dieser „Caveman-Sprachmodus“ etwa 65 % der Token einsparen kann, ohne die Genauigkeit der Ausgabe zu beeinträchtigen.
Wissenschaftliche Grundlage: Studien zeigen, dass das Modell durch die Vorgabe, prägnante Antworten zu generieren, nicht nur Kosten senkt, sondern auch die negativen Auswirkungen von „Überdenken“ beseitigt und die Genauigkeit bei einigen Benchmarks um 26 % steigert.
Praktische Tipps: 10 Hacks zum Token-Sparen
Über technische Workarounds hinaus können normale Nutzer dem „Token-Killer“ ausweichen, indem sie ihre Interaktionsgewohnheiten anpassen:
Direkt bearbeiten: Wenn ein Ergebnis nicht ausreicht, nutzen Sie die Schaltfläche „Bearbeiten“, um die ursprüngliche Eingabe zu verfeinern, und verhindern Sie so wiederholte Kosten durch langwierige Unterhaltungen.
Konversationen kurz halten: Starten Sie alle 15–20 Nachrichten einen neuen Chat, um zu vermeiden, dass sich der Kontext zu einem Token-Schwarzem Loch ausweitet.
Fragen bündeln: Fassen Sie mehrere Anweisungen in einer einzigen Nachricht zusammen, um die Systemauslastung zu verringern.
Nutzen Sie den Projektbereich sinnvoll: Laden Sie umfangreiche Dokumente in „Projekte“ hoch und nutzen Sie das Caching, damit das Dokument nicht wiederholt gescannt wird.
Wechseln Sie nach Möglichkeit zu einem günstigeren Modell: Delegieren Sie einfache Aufgaben wie Grammatikprüfungen an kostengünstigere Modelle wie Haiku und reservieren Sie den teuren
Nutzen Sie Zeiten außerhalb der Spitzenzeiten: Vermeiden Sie das Spitzenzeitfenster von 5 bis 11 Uhr pazifischer Zeit, um von niedrigeren Kosten zu profitieren.
Fazit: Von Verschwendung zu Präzision
Von kurzen Nachrichten im Jahr 2000, die pro Wort abgerechnet wurden, bis hin zu den heutigen großen Modellen, die pro Token abgerechnet werden – unser Streben nach Kommunikationseffizienz hat sich vollendet. Dies ist das Ära der kostenintensiven KI, das von








 DeepMind-CEO Hassabis: Ich schlafe sechs Stunden pro Tag und fühle mich normalerweise gegen 1 Uhr nachts energiegeladen.
Fortune hat kürzlich ein Interview mit Demis Hassabis, dem CEO von Google DeepMind, veröffentlicht, das seinen unkonventionellen Ansatz zu Erholung und Produktivität offenbart. Hassabis gab bekannt, dass er sehr wenig schläft und seine wachen Stunden
 OpenAI und Anthropic kämpfen trotz Umsatzrückgängen um Marktanteile
Obwohl jüngste Berichte darauf hindeuten, dass OpenAI seine Umsatzziele verfehlt hat, was an diesem Dienstag Druck auf die Technologieaktien ausübte, zeigen sich private Investoren in KI-Labore weiter
Einhaltung der Vorschriften für autonome Fahrzeuge in Kalifornien: Eine neue Ära von Bußgeldern, Geofences und 1 Million Meilen
Guident betreibt einen AuveTech-Shuttle in Südflorida und verwaltet mithilfe seiner Fernüberwachungstechnologie eine vier Meilen lange Strecke in West Palm Beach sowie eine eine Meile lange Strecke in

Die besten KI-Generatoren für kurze Video-Hooks des Jahres 2026 für Reels, Shorts und Produkteinführungskampagnen! XIX.AI stellt erstklassige, leistungsstarke und bahnbrechende Tools zusammen, die in Praxistests überzeugende Ergebnisse liefern, die Sie unbedingt ausprobieren sollten. Diese wöchentlich aktualisierte Seite bietet Vergleichsrankings zwischen kostenlosen und kostenpflichtigen Angeboten, damit Sie die perfekte Lösung finden, um Ihre Kreativität und Produktivität bei der Erstellung von Inhalten zu steigern. Entdecken Sie jetzt die Seite und sichern Sie sich Ihren KI-Vorteil!
11 Tools
xix.ai

2026: Die neuesten, besten und am besten bewerteten KI-Tools zur Erstellung von Gliederungen für lange Texte! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Tools, die präzise, strukturierte Gliederungen liefern – getestet unter realen Bedingungen –, um die Effizienz beim Schreiben deutlich zu steigern. XIX.AI gehört zu dieser Eliteauswahl. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen bei der Auswahl des perfekten Tools hilft. Entdecken Sie die Tools jetzt und sichern Sie sich Ihren KI-Vorteil!
9 Tools
xix.ai

2026 Neueste Besten Top-bewerteten KI-Rollenspiel-Chat-Apps für Sprachpraxis, Vorstellungsgesprächsvorbereitung und tägliche Sprachflüssigkeit! XIX.AI kuratiert eine leistungsstarke, spielfeldverändernde Sammlung, die kostenlose gegen kostenpflichtige Vergleiche, reale Tests und wöchentlich aktualisierte Rankings bietet. Diese unbedingt auszuprobierenden Tools helfen Ihnen, Ihre Schreibfähigkeiten zu verbessern, Hürden der Sprachflüssigkeit zu überwinden und die Kommunikationseffizienz in allen alltäglichen Szenarien zu steigern. Entdecken Sie jetzt Ihr perfektes Werkzeug für Ihre Sprachentwicklung!
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools zur Stem-Trennung des Jahres 2026 – speziell ausgewählt für Remix-Produktionen, die Vorbereitung von Samples und Karaoke-Masters. Diese leistungsstarken, bahnbrechenden Tools haben sich in der Praxis bewährt und bieten präzise Audioisolierung, wodurch die Produktivität erheblich gesteigert wird. XIX.AI stellt einen wöchentlich aktualisierten Vergleichsleitfaden zwischen kostenlosen und kostenpflichtigen Lösungen bereit, der Ihnen hilft, die für Ihre Anforderungen passende Lösung zu finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie ihn jetzt und sichern Sie sich Ihren KI-Vorteil.
8 Tools
xix.ai

2026: Die neuesten und besten AI-SQL-Copiloten – alle in der Rangliste ganz oben! XIX.AI sammelt eine leistungsstarke Auswahl an Tools, die wöchentlich mit aktualisierten Tests aus der Praxis erweitert wird. Mit diesen unverzichtbaren Werkzeugen können Sie präzise Umsatzübersichten erstellen, Verkaufsprozesse analysieren sowie Produktmetriken schnell überwachen und so Ihre Produktivität erheblich steigern. Entdecken Sie jetzt das perfekte Tool für datenbasierte Entscheidungsfindung! 238 Zeichen
9 Tools
xix.ai

2026 Neueste Besten Top-Bewerteten KI-Melodie-Schreibtools für Songentwürfe! XIX.AI hat eine hochleistungsfähige, bahnbrechende Kollektion zusammengestellt, die strengen Praxistests unterzogen wurde, um das beste Schreiberlebnis zu liefern. Sie finden detaillierte kostenlose versus kostenpflichtige Vergleiche, präzise Ranglisten und unbedingt auszuprobierende Optionen, die darauf ausgelegt sind, Ihnen zu helfen, beeindruckende Songentwürfe mühelos zu erstellen und Ihre kreative Produktivität erheblich zu steigern. Entdecken Sie jetzt Ihr perfektes Tool!
8 Tools
xix.ai












