


 Hogar
Claude Mythos sale al mercado a 125 dólares por cada millón de tokens; el método «Frugal Mountain Cave Man» gana popularidad
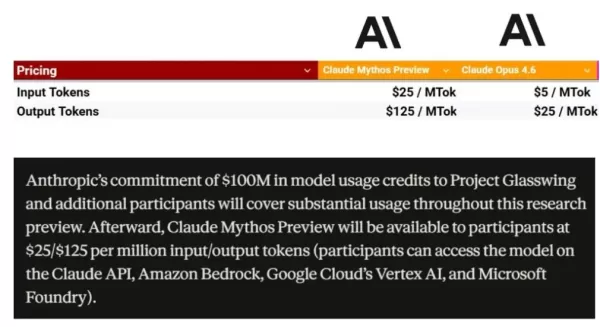
Recientemente, Anthropic ha lanzado el modelo de IA «Claude Mythos», descrito como su versión más potente hasta la fecha. Sin embargo, su precio ha causado un gran revuelo entre la comunidad de desarrolladores: los costes de generación se han fijado en 125 dólares por millón de tokens, casi ocho veces más que los de su actual modelo estrella, «Claude Sonnet 4.6».
Enfoque clave: el prohibitivamente caro Mythos
La estructura de precios de Claude Mythos marca el inicio de una nueva era de sobrecostes en la potencia de cálculo de la IA:
Costes exorbitantes: La entrada y la salida tienen un precio de 25 y 125 dólares por millón de tokens, respectivamente. En cambio, Claude Sonnet 4.6 cuesta solo 3 y 15 dólares.
Alta barrera de entrada: debido a su extrema potencia y coste, el modelo aún no es accesible para los usuarios habituales. Algunos usuarios de Reddit han bromeado diciendo que incluso un simple «Hola» podría consumir el 13 % de la asignación mensual de tokens.
Autorescate para geeks: el método viral de ahorro «Caveman»
Con unos costes de tokens que rivalizan con el oro, los desarrolladores han recurrido a tácticas extremas de ahorro. Un proyecto, acertadamente llamado «Caveman», se hizo rápidamente viral en GitHub:
Lógica central: Obliga a la IA a prescindir de todas las fórmulas de cortesía (como «Es un placer atenderle»), eliminar los artículos, evitar la charla trivial y generar únicamente términos técnicos esenciales.
Resultados impresionantes: Las pruebas indican que este modo de «lenguaje cavernícola» puede ahorrar aproximadamente un 65 % de tokens sin sacrificar la precisión de las respuestas.
Base científica: Los estudios demuestran que obligar al modelo a generar respuestas concisas no solo reduce los costes, sino que también elimina los efectos negativos de pensar demasiado, lo que aumenta la precisión en algunas pruebas de referencia en un 26 %.
Consejos prácticos: 10 trucos para ahorrar tokens
Más allá de las soluciones técnicas, los usuarios habituales pueden esquivar al «asesino de tokens» modificando sus hábitos de interacción:
Edita sobre la marcha: si un resultado no es satisfactorio, utiliza el botón «Editar» para refinar la solicitud original, evitando así que las conversaciones prolongadas generen cobros repetidos.
Acorta las conversaciones: inicia un nuevo chat cada 15-20 mensajes para evitar que la acumulación de contexto se convierta en un agujero negro de tokens.
Combina preguntas: agrupa varias instrucciones en un solo mensaje para reducir la carga del sistema.
Utiliza el espacio de proyectos con inteligencia: sube documentos extensos a «Proyectos» y aprovecha el almacenamiento en caché para que el documento no se vuelva a escanear repetidamente.
Recurre a modelos más económicos cuando sea posible: delega tareas sencillas, como la revisión gramatical, a modelos más económicos como Haiku, y reserva el costoso Claude Mythos para las tareas más complejas.
Aprovecha las horas de menor actividad: evita la franja horaria de mayor actividad, de 5:00 a 11:00 (hora del Pacífico), para beneficiarte de unos costes más bajos.
Conclusión: del despilfarro a la precisión
Desde los mensajes cortos del año 2000, que se cobraban por palabra, hasta los grandes modelos actuales, que se facturan por token, nuestra búsqueda de la eficiencia en la comunicación ha dado un giro completo. Esta es la era de la IA de alto coste que ha inaugurado Claude Mythos .
Artículo relacionado
 La superinteligencia ha llegado: ¿la dejamos entrar?
Cargando el reproductor…Las empresas de inteligencia artificial han estado hablando de una IA superinteligente como si fuera inevitable, pero los recientes incidentes de seguridad, como la violación de OpenAI en Hugging Face, están demostrando los p
iFLYTEK presenta el modelo general de gran escala Spark X2.5
El 1 de septiembre, iFlytek abrirá al código abierto dos modelos de lenguaje grandes centrados en el borde: Xinghuo X2.5-4B y Xinghuo X2.5-1.7B, según el último anuncio oficial. Ambos modelos admiten nativamente una ventana de contexto de hasta 1 mil
Meta elimina la función de edición de fotos con IA tras las críticas de los usuarios
Meta, el gigante de los medios sociales, se ve una vez más envuelto en un debate público sobre el delicado equilibrio entre la inteligencia artificial y la privacidad de los usuarios. Según TechCrunch, Superintelligence Labs de Meta presentó un nuevo
Recomendaciones de temas especiales relacionados
Creación de animación
 Herramientas de animación de escenas con IA para contenidos en redes sociales
XIX.AI ha recopilado aquí las mejores y más valoradas herramientas de animación de escenas con IA para contenidos en redes sociales de 2026. Estas potentes herramientas, que suponen un cambio revolucionario, ofrecen pruebas en el mundo real y una comparación detallada entre las versiones gratuitas y las de pago, lo que ayuda a los creadores a aumentar su productividad de forma significativa. Descúbrelas ahora para sacar partido a tu ventaja con la IA.
 9 herramientas
 xix.ai
Creación de vídeos
Generadores de ganchos para vídeos cortos basados en IA, para Reels, Shorts y campañas de lanzamiento de productos
¡Los mejores generadores de ganchos para vídeos cortos con IA de 2026 para Reels, Shorts y campañas de lanzamiento de productos! XIX.AI selecciona las herramientas más valoradas, potentes y revolucionarias que ofrecen resultados que no te puedes perder, contrastados mediante pruebas en el mundo real. Esta página, que se actualiza semanalmente, ofrece clasificaciones comparativas entre opciones gratuitas y de pago para ayudarte a encontrar la solución perfecta con la que potenciar la creatividad y la productividad en la creación de contenidos. ¡Explórala ahora y descubre tu ventaja con la IA!
11 herramientas
xix.ai
escribiendo
Herramientas de IA para la estructura de artículos en la redacción de textos extensos
¡Las mejores herramientas de 2026 para crear esquemas de artículos con IA, mejor valoradas para la redacción de textos largos! Esta selección incluye potentes herramientas revolucionarias que ofrecen esquemas precisos y estructurados, probados en la práctica, para aumentar significativamente la eficiencia en la redacción. XIX.AI forma parte de esta selección de élite. Consigue una comparación entre las versiones gratuitas y de pago que te ayudará a elegir la herramienta perfecta. ¡Explora ahora y aprovecha tu ventaja con la IA!
9 herramientas
xix.ai
chatbot
Las mejores aplicaciones de chat de roleplay con IA para practicar idiomas, prepararse para entrevistas y mejorar la fluidez diaria
¡Las mejores aplicaciones de chat de roleplay con IA de 2026, mejor valoradas, para practicar idiomas, prepararse para entrevistas y mejorar la fluidez diaria! XIX.AI selecciona una poderosa colección revolucionaria que ofrece comparaciones entre versiones gratuitas y de pago, pruebas del mundo real y clasificaciones actualizadas semanalmente. Estas herramientas imprescindibles te ayudan a mejorar tus habilidades de escritura, superar los desafíos de fluidez y aumentar la eficiencia comunicativa en todas las situaciones cotidianas. ¡Explora ahora para descubrir tu herramienta perfecta para el crecimiento lingüístico!
10 herramientas
xix.ai
composicion musical
Herramientas de separación de pistas con IA para la producción de remezclas, la preparación de samples y las pistas maestras de karaoke
Las mejores herramientas de separación de pistas con IA de 2026, seleccionadas para la producción de remixes, la preparación de samples y la creación de temas de karaoke. Estas potentes herramientas revolucionarias se han sometido a pruebas en condiciones reales para ofrecer un aislamiento de audio preciso, lo que aumenta significativamente la productividad. XIX.AI ofrece una guía comparativa entre versiones gratuitas y de pago, actualizada semanalmente, para ayudarte a encontrar la solución imprescindible que mejor se adapte a tus necesidades. Explórala ahora para sacar el máximo partido a la IA.
8 herramientas
xix.ai
Análisis de datos
Copilotos de AI para SQL destinados a paneles de ingresos, análisis de embudos y métricas de productos
¡Los mejores copilotos de SQL basados en IA de 2026, clasificados entre los más destacados! XIX.AI reúne una poderosa colección que evoluciona constantemente, con pruebas en el mundo real actualizadas semanalmente. Estas herramientas indispensables le permiten generar paneles de control de ingresos precisos, analizar los canales de venta y seguir de cerca las métricas de los productos de manera rápida, lo que aumenta significativamente su productividad. ¡Explórelas ahora para encontrar la herramienta perfecta para tomar decisiones basadas en datos! 238 caracteres
9 herramientas
xix.ai

 comentario (0)
0/500
Recientemente,
Enfoque clave: el prohibitivamente caro Mythos
La estructura de precios de
Costes exorbitantes: La entrada y la salida tienen un precio de 25 y 125 dólares por millón de tokens, respectivamente. En cambio,
Alta barrera de entrada: debido a su extrema potencia y coste, el modelo aún no es accesible para los usuarios habituales. Algunos usuarios de Reddit han bromeado diciendo que incluso un simple «Hola» podría consumir el 13 % de la asignación mensual de tokens.
Autorescate para geeks: el método viral de ahorro «Caveman»
Con unos costes de tokens que rivalizan con el oro, los desarrolladores han recurrido a tácticas extremas de ahorro. Un proyecto, acertadamente llamado «Caveman», se hizo rápidamente viral en GitHub:
Lógica central: Obliga a la IA a prescindir de todas las fórmulas de cortesía (como «Es un placer atenderle»), eliminar los artículos, evitar la charla trivial y generar únicamente términos técnicos esenciales.
Resultados impresionantes: Las pruebas indican que este modo de «lenguaje cavernícola» puede ahorrar aproximadamente un 65 % de tokens sin sacrificar la precisión de las respuestas.
Base científica: Los estudios demuestran que obligar al modelo a generar respuestas concisas no solo reduce los costes, sino que también elimina los efectos negativos de pensar demasiado, lo que aumenta la precisión en algunas pruebas de referencia en un 26 %.
Consejos prácticos: 10 trucos para ahorrar tokens
Más allá de las soluciones técnicas, los usuarios habituales pueden esquivar al «asesino de tokens» modificando sus hábitos de interacción:
Edita sobre la marcha: si un resultado no es satisfactorio, utiliza el botón «Editar» para refinar la solicitud original, evitando así que las conversaciones prolongadas generen cobros repetidos.
Acorta las conversaciones: inicia un nuevo chat cada 15-20 mensajes para evitar que la acumulación de contexto se convierta en un agujero negro de tokens.
Combina preguntas: agrupa varias instrucciones en un solo mensaje para reducir la carga del sistema.
Utiliza el espacio de proyectos con inteligencia: sube documentos extensos a «Proyectos» y aprovecha el almacenamiento en caché para que el documento no se vuelva a escanear repetidamente.
Recurre a modelos más económicos cuando sea posible: delega tareas sencillas, como la revisión gramatical, a modelos más económicos como Haiku, y reserva el costoso
Aprovecha las horas de menor actividad: evita la franja horaria de mayor actividad, de 5:00 a 11:00 (hora del Pacífico), para beneficiarte de unos costes más bajos.
Conclusión: del despilfarro a la precisión
Desde los mensajes cortos del año 2000, que se cobraban por palabra, hasta los grandes modelos actuales, que se facturan por token, nuestra búsqueda de la eficiencia en la comunicación ha dado un giro completo. Esta es la era de la IA de alto coste que ha inaugurado








 La superinteligencia ha llegado: ¿la dejamos entrar?
Cargando el reproductor…Las empresas de inteligencia artificial han estado hablando de una IA superinteligente como si fuera inevitable, pero los recientes incidentes de seguridad, como la violación de OpenAI en Hugging Face, están demostrando los p
 iFLYTEK presenta el modelo general de gran escala Spark X2.5
El 1 de septiembre, iFlytek abrirá al código abierto dos modelos de lenguaje grandes centrados en el borde: Xinghuo X2.5-4B y Xinghuo X2.5-1.7B, según el último anuncio oficial. Ambos modelos admiten nativamente una ventana de contexto de hasta 1 mil
 Meta elimina la función de edición de fotos con IA tras las críticas de los usuarios
Meta, el gigante de los medios sociales, se ve una vez más envuelto en un debate público sobre el delicado equilibrio entre la inteligencia artificial y la privacidad de los usuarios. Según TechCrunch, Superintelligence Labs de Meta presentó un nuevo

XIX.AI ha recopilado aquí las mejores y más valoradas herramientas de animación de escenas con IA para contenidos en redes sociales de 2026. Estas potentes herramientas, que suponen un cambio revolucionario, ofrecen pruebas en el mundo real y una comparación detallada entre las versiones gratuitas y las de pago, lo que ayuda a los creadores a aumentar su productividad de forma significativa. Descúbrelas ahora para sacar partido a tu ventaja con la IA.
9 herramientas
xix.ai

¡Los mejores generadores de ganchos para vídeos cortos con IA de 2026 para Reels, Shorts y campañas de lanzamiento de productos! XIX.AI selecciona las herramientas más valoradas, potentes y revolucionarias que ofrecen resultados que no te puedes perder, contrastados mediante pruebas en el mundo real. Esta página, que se actualiza semanalmente, ofrece clasificaciones comparativas entre opciones gratuitas y de pago para ayudarte a encontrar la solución perfecta con la que potenciar la creatividad y la productividad en la creación de contenidos. ¡Explórala ahora y descubre tu ventaja con la IA!
11 herramientas
xix.ai

¡Las mejores herramientas de 2026 para crear esquemas de artículos con IA, mejor valoradas para la redacción de textos largos! Esta selección incluye potentes herramientas revolucionarias que ofrecen esquemas precisos y estructurados, probados en la práctica, para aumentar significativamente la eficiencia en la redacción. XIX.AI forma parte de esta selección de élite. Consigue una comparación entre las versiones gratuitas y de pago que te ayudará a elegir la herramienta perfecta. ¡Explora ahora y aprovecha tu ventaja con la IA!
9 herramientas
xix.ai

¡Las mejores aplicaciones de chat de roleplay con IA de 2026, mejor valoradas, para practicar idiomas, prepararse para entrevistas y mejorar la fluidez diaria! XIX.AI selecciona una poderosa colección revolucionaria que ofrece comparaciones entre versiones gratuitas y de pago, pruebas del mundo real y clasificaciones actualizadas semanalmente. Estas herramientas imprescindibles te ayudan a mejorar tus habilidades de escritura, superar los desafíos de fluidez y aumentar la eficiencia comunicativa en todas las situaciones cotidianas. ¡Explora ahora para descubrir tu herramienta perfecta para el crecimiento lingüístico!
10 herramientas
xix.ai

Las mejores herramientas de separación de pistas con IA de 2026, seleccionadas para la producción de remixes, la preparación de samples y la creación de temas de karaoke. Estas potentes herramientas revolucionarias se han sometido a pruebas en condiciones reales para ofrecer un aislamiento de audio preciso, lo que aumenta significativamente la productividad. XIX.AI ofrece una guía comparativa entre versiones gratuitas y de pago, actualizada semanalmente, para ayudarte a encontrar la solución imprescindible que mejor se adapte a tus necesidades. Explórala ahora para sacar el máximo partido a la IA.
8 herramientas
xix.ai

¡Los mejores copilotos de SQL basados en IA de 2026, clasificados entre los más destacados! XIX.AI reúne una poderosa colección que evoluciona constantemente, con pruebas en el mundo real actualizadas semanalmente. Estas herramientas indispensables le permiten generar paneles de control de ingresos precisos, analizar los canales de venta y seguir de cerca las métricas de los productos de manera rápida, lo que aumenta significativamente su productividad. ¡Explórelas ahora para encontrar la herramienta perfecta para tomar decisiones basadas en datos! 238 caracteres
9 herramientas
xix.ai












