首页

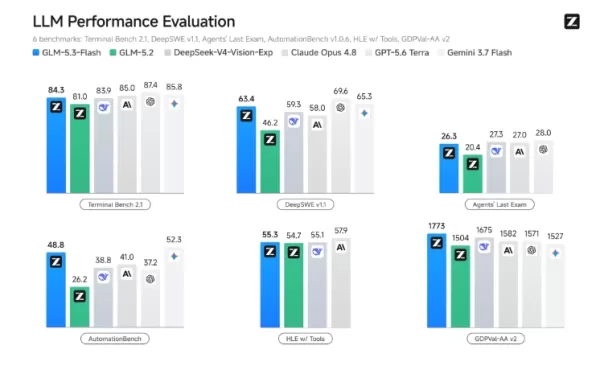
智谱AI在BigModel平台推出了GLM-5.3-FlashX,其输出速度达到每秒200个token。该增强版基于广受欢迎的GLM-5.3-Flash模型,利用十万枚国产芯片优化推理效率。它优先注重智能性、成本效益和速度,为企业提供高吞吐量、低延迟的服务。目前可通过API和体验中心使用,此次升级旨在提升高并发场景下的商业可行性,标志着国产大模型推理与可及性方面取得重要进展。
评论 (0)
0/300