Heim

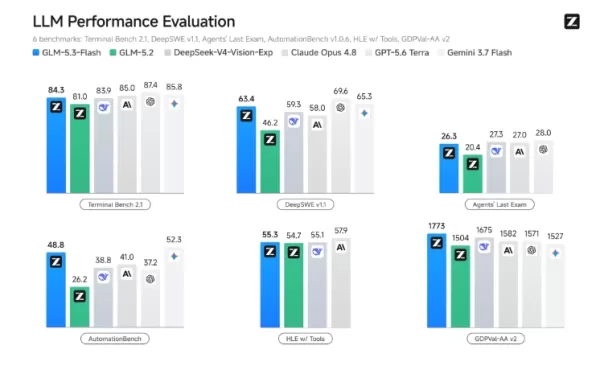
Zhipu AI hat GLM-5.3-FlashX auf seiner BigModel-Plattform vorgestellt, das eine Ausgaberate von 200 Token pro Sekunde bietet. Diese verbesserte Version baut auf dem beliebten GLM-5.3-Flash auf und nutzt 100.000 inländische Chips, um die Inferenzeffizienz zu optimieren. Sie priorisiert Intelligenz, Kosteneffizienz und Geschwindigkeit und bietet Unternehmen hochdurchsatzstarke Dienste mit niedriger Latenz. Verfügbar über API und Erfahrungszentrum zielt das Upgrade darauf ab, die kommerzielle Lebensfähigkeit in Szenarien mit hoher Parallelität zu steigern und markiert bedeutende Fortschritte bei der inländischen Inferenz und Zugänglichkeit großer Modelle.
Kommentare (0)
0/300