首頁

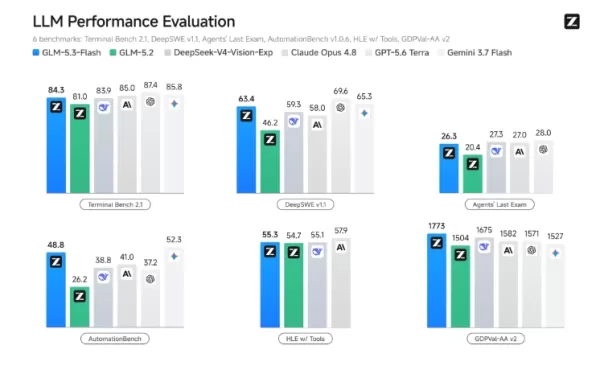
智譜AI在BigModel平臺推出了GLM-5.3-FlashX,其輸出速度達到每秒200個token。該增強版基於廣受歡迎的GLM-5.3-Flash模型,利用十萬枚國產晶片最佳化推理效率。它優先注重智慧性、成本效益和速度,為企業提供高吞吐量、低延遲的服務。目前可透過API和體驗中心使用,此次升級旨在提升高併發場景下的商業可行性,標誌著國產大模型推理與可及性方面取得重要進展。
評論 (0)
0/300