


 首页
Volcano Engine 推出 Doubao Audio 1.0 版本:一句台词即可生成电影级音频,10 分钟内容角色声音保持一致
昨日,Volc Engine 正式发布了“Doubao 音频生成模型 1.0”(Doubao-Seed-Audio 1.0),该模型支持文本或音频输入,能够端到端生成完整的音频作品。 其关键突破在于,单条提示词即可同时处理对话、音效和背景音乐,省去了手动多轨编辑的步骤。
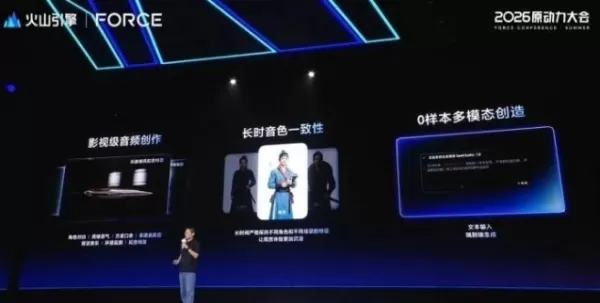
将一句话变成音频导演——无需后期制作。
此前,制作高质量音频需要分别生成对话、音效和音乐,然后手动对齐和混音——这是一个依赖后期制作专业知识的复杂过程。 “Doubao 音频生成模型 1.0”将所有这些步骤整合到一个提示词中:用户可以在一条指令中定义多个角色的台词、语调和情感节奏,嵌入笑声、叹息、停顿和方言口音等细节,并同时生成背景音乐和环境音效,直接输出成品。 创作者只需输入描述,即可立即获得可直接发布的播客、有声书或品牌音频。
在长篇音频中保持角色声音的一致性,且不失真。
长音频创作的最大挑战在于一致性——确保角色在第 1 分钟和第 10 分钟听起来都一样。Doubao 音频生成模型 1.0 将文本转语音与参考音频深度整合,在长段落中保持一致的音质,因此创作者无需逐段对比和修改。 当前模型每次生成最多支持2分钟的音频,借助扩展功能,它还能在更长的输出内容中保持声音的一致性,适用于有声书、播客和长篇系列作品。
此外,该模型支持对声音和风格进行解耦控制,使同一声音能够适应各种情绪和语境——甚至能让单一声音以不同表现形式诠释多个角色。这极大地提升了角色配音和创意音频制作的灵活性。 目前,Volc Ark 已开放 API 测试,个人用户可在体验中心获得 30 分钟的生成配额。Doubao 语音生成模型 1.0 还将登陆 CapCut、Jiemod 和 Tomato 等产品。
相关文章
 Sora 离线,马斯克推动 Grok Imagine 并承诺升级
全球AI视频市场在短短一天内发生了剧烈变化。在OpenAI关闭其旗舰视频工具Sora后,埃隆·马斯克迅速采取行动填补这一空白。周三,他在X平台上宣布,其AI公司xAI正在升级其视频生成器。他写道:“Grok Imagine的下一个版本将非常令人印象深刻。我们正在加倍投入。”填补空白:Sora退出后的机遇周二,OpenAI突然关闭了Sora,理由是简化其产品组合的需要。这引发了人们对AI视频高昂成本和低回报率的质疑,但也为竞争对手打开了大门:核心重点: 今年二月,Grok Imagine被
Anthropic 年收入达 470 亿美元,Claude 企业采用率飙升
领先的人工智能公司之间的竞争正在加剧。5月28日,知名AI初创公司Anthropic宣布,其年化收入已超过470亿美元。这一显著的财务里程碑凸显了生成式AI技术的快速商业化及其市场潜力。对其增长轨迹的分析表明,这一成就源于企业领域的广泛采用。继2月完成G轮融资后,Anthropic的旗舰模型Claude在全球企业客户中展现出强劲的用户渗透率和应用规模扩张。从技术角度来看,Anthropic近期的产品增强为商业成功奠定了坚实基础。该公司最近发布了高性能AI模型,并推出了其最新旗舰版本Claud
美图Hub:美图的AI图像平台为企业提供定制化视觉工作流
美图已正式推出基于人工智能的图片制作平台 MeituHub,为企业提供端到端的视觉内容解决方案。该方案涵盖从初始需求分析、工作流配置到最终资产交付的全流程。借助美图全面的技术栈,企业可以通过简单的自然语言指令设计自定义视觉工作流,无需复杂的代码编写,并部署可复用的 Web 应用程序。随着生成式人工智能工具的普及,许多组织虽然拥有先进的人工智能能力,却难以将其整合为连贯、高效的生产流水线。传统上,设计师需要手动操作多种软件工具来管理资产、生成概念并确定最终输出,这制约了大规模内容创作的效率。美图强
相关专题推荐
设计与艺术
 顶级AI插画工具:更快地创作编辑类场景和封面插图
2026年最新高评分AI插画工具:我们精心挑选的这份清单汇集了功能强大的顶级工具,助您快速创作令人惊艳的编辑场景和引人注目的封面艺术。每款工具都经过了严格的实际测试,并提供了免费版与付费版的对比,帮助您找到最适合您工作流程的工具。 立即尝试这些必试解决方案,释放您的AI优势,提升创作效率。立即访问 XIX.AI 探索更多。
 10 个工具
 xix.ai
教育与学习
备考首选的顶尖AI辅导老师:练习数学、科学和英语
2026年最新、评分最高的考试备考AI辅导工具现已登陆XIX.AI!我们精心筛选的这份清单汇集了多款功能强大、颠覆传统的工具,提供免费与付费版本的对比、实际测试以及每周更新的排行榜。它们能帮助你提升写作效率、简化复杂主题的学习,并释放你的学术潜能。 立即探索,发现最适合您的备考工具,今天就开始创作,释放您的AI优势!
10 个工具
xix.ai
金融
用于个人财务管理的 AI 预算规划工具
2026 年最新最佳顶级评分 AI 预算规划工具,专为个人财务管理打造,现已登陆 XIX.AI!本精选合集收录了强大且具颠覆性的解决方案,助您开展实际测试、理解消费习惯,并制定个性化计划以提升生产力。享受免费与付费版的对比及详细排名。这些必试工具旨在简化财务管理,助您释放 AI 优势。立即探索!
11 个工具
xix.ai
健康养生
AI睡眠追踪助手:通过养成更好的睡前习惯来促进身体恢复
2026年最新精选高评分AI睡眠追踪助手,助您实现最佳恢复效果。这份全面更新的每周指南汇集了强大的工具,提供实际测试结果、免费与付费版本对比以及详细排名,助您找到必试的解决方案,从而提升睡眠质量并养成更好的就寝习惯。 立即访问 XIX.AI,解锁您的AI优势。
10 个工具
xix.ai
数据分析
用于产品和收入分析的 AI SQL 辅助工具
2026年最新、最受欢迎、评分最高的AI SQL辅助工具,助力产品与营收分析! XIX.AI 精心遴选了一系列功能强大、颠覆性的必试工具,这些工具均经过每周更新的排名体系进行实战测试。它们能通过加速数据分析、简化复杂查询并生成精准洞察,帮助用户显著提升工作效率,从而推动更明智的商业决策。立即探索,发现最适合您的工具,释放您的AI优势!
14 个工具
xix.ai
教育与学习
最佳的、兼具教学功能的AI作业助手:学习概念,而不仅仅是答案
2026年最新最佳高评分AI作业助手:不仅提供答案,更传授核心概念。专为学生打造的强大工具,精选必试清单,每周更新,免费与付费版本对比,真实使用测试,精准排名,助您充分释放学习潜能。立即探索,发现最适合您的工具,让学习更高效。
10 个工具
xix.ai

 评论 (1)
0/500
![StevenNelson]()
Volc EngineのDoubao Audio Model 1.0、面白そう!1文で映画のような音声が作れるなんて、クリエイターには夢のツールだよね。ただ、10分間のキャラクター音声の安定性が実用レベルかどうかが気になるところ。技術的にはすごいけど、倫理面での規制も必要かも。🎬🔊
昨日,Volc Engine 正式发布了“Doubao 音频生成模型 1.0”(Doubao-Seed-Audio 1.0),该模型支持文本或音频输入,能够端到端生成完整的音频作品。 其关键突破在于,单条提示词即可同时处理对话、音效和背景音乐,省去了手动多轨编辑的步骤。
将一句话变成音频导演——无需后期制作。
此前,制作高质量音频需要分别生成对话、音效和音乐,然后手动对齐和混音——这是一个依赖后期制作专业知识的复杂过程。 “Doubao 音频生成模型 1.0”将所有这些步骤整合到一个提示词中:用户可以在一条指令中定义多个角色的台词、语调和情感节奏,嵌入笑声、叹息、停顿和方言口音等细节,并同时生成背景音乐和环境音效,直接输出成品。 创作者只需输入描述,即可立即获得可直接发布的播客、有声书或品牌音频。
在长篇音频中保持角色声音的一致性,且不失真。
长音频创作的最大挑战在于一致性——确保角色在第 1 分钟和第 10 分钟听起来都一样。Doubao 音频生成模型 1.0 将文本转语音与参考音频深度整合,在长段落中保持一致的音质,因此创作者无需逐段对比和修改。 当前模型每次生成最多支持2分钟的音频,借助扩展功能,它还能在更长的输出内容中保持声音的一致性,适用于有声书、播客和长篇系列作品。
此外,该模型支持对声音和风格进行解耦控制,使同一声音能够适应各种情绪和语境——甚至能让单一声音以不同表现形式诠释多个角色。这极大地提升了角色配音和创意音频制作的灵活性。 目前,Volc Ark 已开放 API 测试,个人用户可在体验中心获得 30 分钟的生成配额。Doubao 语音生成模型 1.0 还将登陆 CapCut、Jiemod 和 Tomato 等产品。








 Sora 离线,马斯克推动 Grok Imagine 并承诺升级
全球AI视频市场在短短一天内发生了剧烈变化。在OpenAI关闭其旗舰视频工具Sora后,埃隆·马斯克迅速采取行动填补这一空白。周三,他在X平台上宣布,其AI公司xAI正在升级其视频生成器。他写道:“Grok Imagine的下一个版本将非常令人印象深刻。我们正在加倍投入。”填补空白:Sora退出后的机遇周二,OpenAI突然关闭了Sora,理由是简化其产品组合的需要。这引发了人们对AI视频高昂成本和低回报率的质疑,但也为竞争对手打开了大门:核心重点: 今年二月,Grok Imagine被
 Anthropic 年收入达 470 亿美元,Claude 企业采用率飙升
领先的人工智能公司之间的竞争正在加剧。5月28日,知名AI初创公司Anthropic宣布,其年化收入已超过470亿美元。这一显著的财务里程碑凸显了生成式AI技术的快速商业化及其市场潜力。对其增长轨迹的分析表明,这一成就源于企业领域的广泛采用。继2月完成G轮融资后,Anthropic的旗舰模型Claude在全球企业客户中展现出强劲的用户渗透率和应用规模扩张。从技术角度来看,Anthropic近期的产品增强为商业成功奠定了坚实基础。该公司最近发布了高性能AI模型,并推出了其最新旗舰版本Claud
 美图Hub:美图的AI图像平台为企业提供定制化视觉工作流
美图已正式推出基于人工智能的图片制作平台 MeituHub,为企业提供端到端的视觉内容解决方案。该方案涵盖从初始需求分析、工作流配置到最终资产交付的全流程。借助美图全面的技术栈,企业可以通过简单的自然语言指令设计自定义视觉工作流,无需复杂的代码编写,并部署可复用的 Web 应用程序。随着生成式人工智能工具的普及,许多组织虽然拥有先进的人工智能能力,却难以将其整合为连贯、高效的生产流水线。传统上,设计师需要手动操作多种软件工具来管理资产、生成概念并确定最终输出,这制约了大规模内容创作的效率。美图强
2026年最新高评分AI插画工具:我们精心挑选的这份清单汇集了功能强大的顶级工具,助您快速创作令人惊艳的编辑场景和引人注目的封面艺术。每款工具都经过了严格的实际测试,并提供了免费版与付费版的对比,帮助您找到最适合您工作流程的工具。 立即尝试这些必试解决方案,释放您的AI优势,提升创作效率。立即访问 XIX.AI 探索更多。
10 个工具
xix.ai
2026年最新、评分最高的考试备考AI辅导工具现已登陆XIX.AI!我们精心筛选的这份清单汇集了多款功能强大、颠覆传统的工具,提供免费与付费版本的对比、实际测试以及每周更新的排行榜。它们能帮助你提升写作效率、简化复杂主题的学习,并释放你的学术潜能。 立即探索,发现最适合您的备考工具,今天就开始创作,释放您的AI优势!
10 个工具
xix.ai
2026 年最新最佳顶级评分 AI 预算规划工具,专为个人财务管理打造,现已登陆 XIX.AI!本精选合集收录了强大且具颠覆性的解决方案,助您开展实际测试、理解消费习惯,并制定个性化计划以提升生产力。享受免费与付费版的对比及详细排名。这些必试工具旨在简化财务管理,助您释放 AI 优势。立即探索!
11 个工具
xix.ai
2026年最新精选高评分AI睡眠追踪助手,助您实现最佳恢复效果。这份全面更新的每周指南汇集了强大的工具,提供实际测试结果、免费与付费版本对比以及详细排名,助您找到必试的解决方案,从而提升睡眠质量并养成更好的就寝习惯。 立即访问 XIX.AI,解锁您的AI优势。
10 个工具
xix.ai
2026年最新、最受欢迎、评分最高的AI SQL辅助工具,助力产品与营收分析! XIX.AI 精心遴选了一系列功能强大、颠覆性的必试工具,这些工具均经过每周更新的排名体系进行实战测试。它们能通过加速数据分析、简化复杂查询并生成精准洞察,帮助用户显著提升工作效率,从而推动更明智的商业决策。立即探索,发现最适合您的工具,释放您的AI优势!
14 个工具
xix.ai
2026年最新最佳高评分AI作业助手:不仅提供答案,更传授核心概念。专为学生打造的强大工具,精选必试清单,每周更新,免费与付费版本对比,真实使用测试,精准排名,助您充分释放学习潜能。立即探索,发现最适合您的工具,让学习更高效。
10 个工具
xix.ai

Volc EngineのDoubao Audio Model 1.0、面白そう!1文で映画のような音声が作れるなんて、クリエイターには夢のツールだよね。ただ、10分間のキャラクター音声の安定性が実用レベルかどうかが気になるところ。技術的にはすごいけど、倫理面での規制も必要かも。🎬🔊












