


 Maison
Volcano Engine lance Doubao Audio Model 1.0 : un son cinématographique en une seule phrase et des voix de personnages cohérentes pendant 10 minutes
Hier, Volc Engine a officiellement lancé le modèle de génération audio Doubao 1.0 (Doubao-Seed-Audio 1.0), qui accepte des entrées textuelles ou audio pour produire des œuvres audio complètes de bout en bout. Sa principale innovation réside dans le fait qu’une seule instruction permet de gérer à la fois les dialogues, les effets sonores et la musique de fond, éliminant ainsi le besoin d’un montage multipiste manuel.
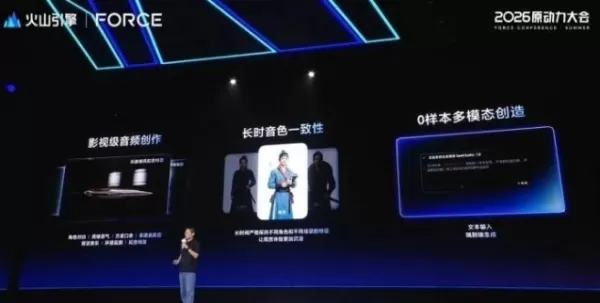
Transformez une phrase en réalisateur audio — aucune post-production n’est nécessaire.
Auparavant, la création d’un contenu audio de haute qualité nécessitait de générer séparément les dialogues, les effets sonores et la musique, puis d’aligner et de mixer manuellement les pistes — un processus complexe qui exigeait une expertise en post-production. Le modèle de génération audio Doubao 1.0 regroupe tout cela en une seule instruction : les utilisateurs peuvent définir les répliques, le ton et le rythme émotionnel de plusieurs personnages en une seule instruction, intégrer des détails tels que des rires, des soupirs, des pauses et des accents dialectaux, et générer simultanément de la musique de fond et des effets sonores d’ambiance, pour obtenir directement un produit fini. Un créateur peut saisir une description et obtenir immédiatement un podcast, un livre audio ou un contenu audio de marque prêt à être diffusé.
Des voix de personnages cohérentes tout au long d’un enregistrement audio de longue durée, sans perte de qualité.
Le plus grand défi dans la création d’enregistrements audio longs réside dans la cohérence : s’assurer qu’un personnage a la même voix à la première minute qu’à la dixième. Le modèle 1.0 de Doubao Audio Generation intègre profondément la conversion texte-audio à un enregistrement de référence, garantissant ainsi une qualité vocale constante sur de longs segments, ce qui évite aux créateurs d’avoir à comparer et à réviser chaque partie. Le modèle actuel prend en charge jusqu’à 2 minutes d’audio par génération et, grâce à la fonctionnalité d’extension, il préserve la cohérence vocale pour des productions plus longues, ce qui convient aux livres audio, aux podcasts et aux longues séries.
De plus, le modèle offre un contrôle dissocié de la voix et du style, permettant à une même voix de s’adapter à diverses émotions et contextes — et même à une seule voix d’incarner plusieurs rôles avec des expressions différentes. Cela améliore considérablement la flexibilité pour le doublage de personnages et la production audio créative. Actuellement, Volc Ark a ouvert les tests de son API, et les utilisateurs individuels peuvent bénéficier d’un quota de création de 30 minutes dans l’Experience Center. Le modèle de génération audio Doubao 1.0 sera également lancé sur des produits tels que CapCut, Jiemod et Tomato.
Article connexe
 Sora hors ligne alors que Musk pousse Grok Imagine avec des améliorations promises
Le marché mondial de la vidéo par intelligence artificielle a connu un changement spectaculaire en l’espace d’une seule journée.Après que OpenAI ait fermé son outil phare de génération vidéo Sora, Elon Musk s’est empressé de combler le vide. Le merc
Le chiffre d'affaires annuel d'Anthropic atteint 47 milliards de dollars, alors que l'adoption de Claude Enterprise explose
La concurrence entre les principales entreprises d’intelligence artificielle s’intensifie. Le 28 mai, Anthropic, une startup majeure de l’IA, a annoncé que son chiffre d’affaires annuelisé a dépassé 47 milliards de dollars. Cet exploit financier rema
MeituHub : la plateforme d’images IA de Meitu permet des flux de travail visuels personnalisés pour les entreprises
Meitu a officiellement lancé MeituHub, sa plateforme de production d’images alimentée par l’intelligence artificielle, offrant des solutions visuelles complètes de bout en bout aux entreprises. Cela couvre l’ensemble du processus, de l’analyse initia
Recommandations de sujets spéciaux liés
Conception et art
 Les meilleurs outils d'illustration basés sur l'IA : créez plus rapidement des scènes éditoriales et des illustrations de couverture
Les meilleurs outils d'illustration IA de 2026 : notre sélection regroupe les outils les plus performants pour créer rapidement de superbes scènes éditoriales et des couvertures accrocheuses. Chaque option a été soumise à des tests rigoureux en conditions réelles ; nous vous proposons une comparaison entre les versions gratuites et payantes afin de vous aider à trouver celle qui correspond le mieux à votre flux de travail. Essayez dès aujourd’hui ces solutions incontournables pour exploiter pleinement le potentiel de l’IA et booster votre productivité créative. Découvrez-les dès maintenant sur XIX.AI.
 10 outils
 xix.ai
Éducation et apprentissage
Les meilleurs professeurs particuliers spécialisés en IA pour la préparation aux examens : entraînez-vous en maths, en sciences et en anglais
Les meilleurs tuteurs IA 2026 les mieux notés pour la préparation aux examens sont disponibles ici, sur XIX.AI ! Notre sélection comprend des outils puissants et révolutionnaires qui proposent une comparaison entre les versions gratuites et payantes, des tests concrets et des classements mis à jour chaque semaine. Ils vous aident à améliorer votre efficacité à l'écrit, à simplifier l'apprentissage de sujets complexes et à libérer votre potentiel académique. Découvrez dès maintenant l'outil de préparation aux examens qui vous convient le mieux et commencez à créer dès aujourd'hui pour exploiter pleinement les avantages de l'IA !
10 outils
xix.ai
Finance
Outils de planification budgétaire par IA pour la gestion personnelle des finances
2026 Derniers Meilleurs Outils de Planification Budgétaire par IA les mieux notés pour la gestion personnelle des finances sont ici sur XIX.AI ! Cette collection soigneusement sélectionnée propose des solutions puissantes et révolutionnaires qui vous aident à réaliser des tests concrets, à comprendre vos habitudes de dépenses et à créer des plans personnalisés pour améliorer votre productivité. Profitez d’une comparaison entre versions gratuites et payantes ainsi que de classements détaillés. Des outils incontournables conçus pour simplifier la gestion financière et exploiter pleinement votre avantage grâce à l’IA. Explorez dès maintenant !
11 outils
xix.ai
Santé et bien-être
Assistants de suivi du sommeil par l’IA : améliorez votre récupération grâce à de meilleures habitudes avant le coucher
2026 : Découvrez les meilleurs assistants de suivi du sommeil basés sur l’IA, hautement notés et récemment mis à jour, conçus pour une récupération optimale. Ce guide hebdomadaire entièrement actualisé présente des outils puissants qui offrent des tests en conditions réelles, des comparaisons entre versions gratuites et payantes, ainsi que des classements détaillés afin de vous aider à trouver la solution idéale pour améliorer la qualité du sommeil et favoriser de meilleures habitudes avant le coucher. Explorez-le dès maintenant sur XIX.AI pour tirer parti des avantages offerts par l’IA.
10 outils
xix.ai
Analyse des données
Copilotes SQL basés sur l'IA pour l'analyse des produits et du chiffre d'affaires
2026 : les meilleurs copilotes SQL IA les mieux notés pour l'analyse des produits et du chiffre d'affaires ! XIX.AI a sélectionné une gamme d’outils puissants et révolutionnaires à essayer absolument, qui sont soumis à des tests en conditions réelles via des classements mis à jour chaque semaine. Ces outils aident les utilisateurs à booster considérablement leur productivité en accélérant l’analyse des données, en simplifiant les requêtes complexes et en générant des informations précises permettant de prendre des décisions commerciales plus éclairées. Explorez-les dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer pleinement parti de l’IA !
14 outils
xix.ai
Éducation et apprentissage
Les meilleurs outils d'aide aux devoirs basés sur l'IA qui enseignent : apprenez les concepts, pas seulement les réponses
2026 : les meilleurs outils d'aide aux devoirs basés sur l'IA, les mieux notés, qui enseignent les concepts fondamentaux et ne se contentent pas de fournir des réponses. Des outils puissants pour les élèves. Une sélection incontournable à ne pas manquer. Mise à jour hebdomadaire. Comparaison entre les versions gratuites et payantes. Tests en conditions réelles. Classements précis pour vous aider à exploiter pleinement votre potentiel d'apprentissage. Explorez dès maintenant pour découvrir l'outil idéal qui vous permettra d'étudier plus efficacement.
10 outils
xix.ai

 commentaires (1)
![StevenNelson]()
Volc EngineのDoubao Audio Model 1.0、面白そう!1文で映画のような音声が作れるなんて、クリエイターには夢のツールだよね。ただ、10分間のキャラクター音声の安定性が実用レベルかどうかが気になるところ。技術的にはすごいけど、倫理面での規制も必要かも。🎬🔊
Hier, Volc Engine a officiellement lancé le modèle de génération audio Doubao 1.0 (Doubao-Seed-Audio 1.0), qui accepte des entrées textuelles ou audio pour produire des œuvres audio complètes de bout en bout. Sa principale innovation réside dans le fait qu’une seule instruction permet de gérer à la fois les dialogues, les effets sonores et la musique de fond, éliminant ainsi le besoin d’un montage multipiste manuel.
Transformez une phrase en réalisateur audio — aucune post-production n’est nécessaire.
Auparavant, la création d’un contenu audio de haute qualité nécessitait de générer séparément les dialogues, les effets sonores et la musique, puis d’aligner et de mixer manuellement les pistes — un processus complexe qui exigeait une expertise en post-production. Le modèle de génération audio Doubao 1.0 regroupe tout cela en une seule instruction : les utilisateurs peuvent définir les répliques, le ton et le rythme émotionnel de plusieurs personnages en une seule instruction, intégrer des détails tels que des rires, des soupirs, des pauses et des accents dialectaux, et générer simultanément de la musique de fond et des effets sonores d’ambiance, pour obtenir directement un produit fini. Un créateur peut saisir une description et obtenir immédiatement un podcast, un livre audio ou un contenu audio de marque prêt à être diffusé.
Des voix de personnages cohérentes tout au long d’un enregistrement audio de longue durée, sans perte de qualité.
Le plus grand défi dans la création d’enregistrements audio longs réside dans la cohérence : s’assurer qu’un personnage a la même voix à la première minute qu’à la dixième. Le modèle 1.0 de Doubao Audio Generation intègre profondément la conversion texte-audio à un enregistrement de référence, garantissant ainsi une qualité vocale constante sur de longs segments, ce qui évite aux créateurs d’avoir à comparer et à réviser chaque partie. Le modèle actuel prend en charge jusqu’à 2 minutes d’audio par génération et, grâce à la fonctionnalité d’extension, il préserve la cohérence vocale pour des productions plus longues, ce qui convient aux livres audio, aux podcasts et aux longues séries.
De plus, le modèle offre un contrôle dissocié de la voix et du style, permettant à une même voix de s’adapter à diverses émotions et contextes — et même à une seule voix d’incarner plusieurs rôles avec des expressions différentes. Cela améliore considérablement la flexibilité pour le doublage de personnages et la production audio créative. Actuellement, Volc Ark a ouvert les tests de son API, et les utilisateurs individuels peuvent bénéficier d’un quota de création de 30 minutes dans l’Experience Center. Le modèle de génération audio Doubao 1.0 sera également lancé sur des produits tels que CapCut, Jiemod et Tomato.








 Sora hors ligne alors que Musk pousse Grok Imagine avec des améliorations promises
Le marché mondial de la vidéo par intelligence artificielle a connu un changement spectaculaire en l’espace d’une seule journée.Après que OpenAI ait fermé son outil phare de génération vidéo Sora, Elon Musk s’est empressé de combler le vide. Le merc
 Le chiffre d'affaires annuel d'Anthropic atteint 47 milliards de dollars, alors que l'adoption de Claude Enterprise explose
La concurrence entre les principales entreprises d’intelligence artificielle s’intensifie. Le 28 mai, Anthropic, une startup majeure de l’IA, a annoncé que son chiffre d’affaires annuelisé a dépassé 47 milliards de dollars. Cet exploit financier rema
 MeituHub : la plateforme d’images IA de Meitu permet des flux de travail visuels personnalisés pour les entreprises
Meitu a officiellement lancé MeituHub, sa plateforme de production d’images alimentée par l’intelligence artificielle, offrant des solutions visuelles complètes de bout en bout aux entreprises. Cela couvre l’ensemble du processus, de l’analyse initia

Les meilleurs outils d'illustration IA de 2026 : notre sélection regroupe les outils les plus performants pour créer rapidement de superbes scènes éditoriales et des couvertures accrocheuses. Chaque option a été soumise à des tests rigoureux en conditions réelles ; nous vous proposons une comparaison entre les versions gratuites et payantes afin de vous aider à trouver celle qui correspond le mieux à votre flux de travail. Essayez dès aujourd’hui ces solutions incontournables pour exploiter pleinement le potentiel de l’IA et booster votre productivité créative. Découvrez-les dès maintenant sur XIX.AI.
10 outils
xix.ai

Les meilleurs tuteurs IA 2026 les mieux notés pour la préparation aux examens sont disponibles ici, sur XIX.AI ! Notre sélection comprend des outils puissants et révolutionnaires qui proposent une comparaison entre les versions gratuites et payantes, des tests concrets et des classements mis à jour chaque semaine. Ils vous aident à améliorer votre efficacité à l'écrit, à simplifier l'apprentissage de sujets complexes et à libérer votre potentiel académique. Découvrez dès maintenant l'outil de préparation aux examens qui vous convient le mieux et commencez à créer dès aujourd'hui pour exploiter pleinement les avantages de l'IA !
10 outils
xix.ai

2026 Derniers Meilleurs Outils de Planification Budgétaire par IA les mieux notés pour la gestion personnelle des finances sont ici sur XIX.AI ! Cette collection soigneusement sélectionnée propose des solutions puissantes et révolutionnaires qui vous aident à réaliser des tests concrets, à comprendre vos habitudes de dépenses et à créer des plans personnalisés pour améliorer votre productivité. Profitez d’une comparaison entre versions gratuites et payantes ainsi que de classements détaillés. Des outils incontournables conçus pour simplifier la gestion financière et exploiter pleinement votre avantage grâce à l’IA. Explorez dès maintenant !
11 outils
xix.ai

2026 : Découvrez les meilleurs assistants de suivi du sommeil basés sur l’IA, hautement notés et récemment mis à jour, conçus pour une récupération optimale. Ce guide hebdomadaire entièrement actualisé présente des outils puissants qui offrent des tests en conditions réelles, des comparaisons entre versions gratuites et payantes, ainsi que des classements détaillés afin de vous aider à trouver la solution idéale pour améliorer la qualité du sommeil et favoriser de meilleures habitudes avant le coucher. Explorez-le dès maintenant sur XIX.AI pour tirer parti des avantages offerts par l’IA.
10 outils
xix.ai

2026 : les meilleurs copilotes SQL IA les mieux notés pour l'analyse des produits et du chiffre d'affaires ! XIX.AI a sélectionné une gamme d’outils puissants et révolutionnaires à essayer absolument, qui sont soumis à des tests en conditions réelles via des classements mis à jour chaque semaine. Ces outils aident les utilisateurs à booster considérablement leur productivité en accélérant l’analyse des données, en simplifiant les requêtes complexes et en générant des informations précises permettant de prendre des décisions commerciales plus éclairées. Explorez-les dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer pleinement parti de l’IA !
14 outils
xix.ai

2026 : les meilleurs outils d'aide aux devoirs basés sur l'IA, les mieux notés, qui enseignent les concepts fondamentaux et ne se contentent pas de fournir des réponses. Des outils puissants pour les élèves. Une sélection incontournable à ne pas manquer. Mise à jour hebdomadaire. Comparaison entre les versions gratuites et payantes. Tests en conditions réelles. Classements précis pour vous aider à exploiter pleinement votre potentiel d'apprentissage. Explorez dès maintenant pour découvrir l'outil idéal qui vous permettra d'étudier plus efficacement.
10 outils
xix.ai

Volc EngineのDoubao Audio Model 1.0、面白そう!1文で映画のような音声が作れるなんて、クリエイターには夢のツールだよね。ただ、10分間のキャラクター音声の安定性が実用レベルかどうかが気になるところ。技術的にはすごいけど、倫理面での規制も必要かも。🎬🔊












