


 Hogar
Volcano Engine lanza el modelo 1.0 de Doubao Audio: audio cinematográfico en una sola frase y voces de personajes coherentes durante 10 minutos
Ayer, Volc Engine lanzó oficialmente el modelo de generación de audio Doubao 1.0 (Doubao-Seed-Audio 1.0), que admite entradas de texto o audio para producir obras de audio completas de principio a fin. Su principal avance es que una sola indicación puede gestionar a la vez diálogos, efectos de sonido y música de fondo, lo que elimina la necesidad de realizar una edición manual multipista.
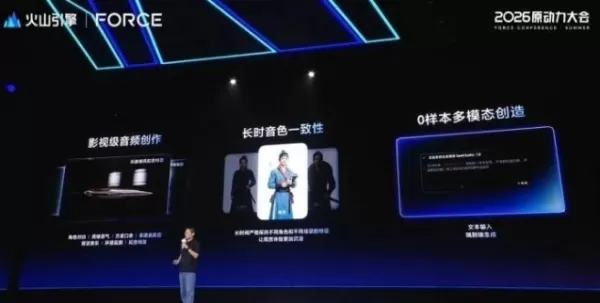
Convierte una frase en un director de audio: no hace falta postproducción.
Anteriormente, crear audio de alta calidad requería generar diálogos, efectos de sonido y música por separado, para luego alinear y mezclar las pistas manualmente —un proceso complejo que dependía de la experiencia en posproducción—. El modelo de generación de audio Doubao 1.0 consolida todo esto en una única indicación: los usuarios pueden definir las líneas de diálogo, el tono y el ritmo emocional de varios personajes en una sola instrucción, incorporar detalles como risas, suspiros, pausas y acentos dialectales, y generar música de fondo y efectos de sonido ambientales simultáneamente, obteniendo directamente un producto terminado. Un creador puede escribir una descripción y recibir de inmediato un podcast, un audiolibro o un audio de marca listo para su publicación.
Voces de los personajes coherentes a lo largo de audios largos sin perder calidad.
El mayor reto en la creación de audios largos es la coherencia: garantizar que un personaje suene igual en el minuto uno y en el minuto diez. El Modelo 1.0 de Doubao Audio Generation integra profundamente la conversión de texto a audio con el audio de referencia, manteniendo una calidad de voz constante a lo largo de segmentos largos, de modo que los creadores no tengan que comparar y revisar cada parte. El modelo actual admite hasta 2 minutos de audio por generación y, gracias a la función de extensión, conserva la coherencia de la voz en grabaciones más largas, lo que lo hace ideal para audiolibros, podcasts y series largas.
Además, el modelo ofrece un control independiente de la voz y el estilo, lo que permite que una misma voz se adapte a diversas emociones y contextos, llegando incluso a permitir que una sola voz interprete múltiples papeles con expresiones diferentes. Esto mejora enormemente la flexibilidad para la interpretación de voces de personajes y la producción creativa de audio. Actualmente, Volc Ark ha abierto las pruebas de la API, y los usuarios particulares pueden obtener una cuota de creación de 30 minutos en el Experience Center. El modelo de generación de audio Doubao 1.0 también se lanzará en productos como CapCut, Jiemod y Tomato.
Artículo relacionado
 Sora Offline mientras Musk impulsa Grok Imagine con actualizaciones prometidas
El mercado global de vídeo con IA ha experimentado un cambio drástico en apenas un día.Tras que OpenAI cerrara su herramienta de vídeo principal Sora, Elon Musk actuó rápidamente para cubrir el vacío. El miércoles, anunció en X que su empresa de IA,
Los ingresos anuales de Anthropic alcanzan los 47.000 millones de dólares, mientras que la adopción empresarial de Claude se dispara
La competencia entre las principales empresas de inteligencia artificial se intensifica. El 28 de mayo, Anthropic, una destacada empresa emergente de IA, informó que sus ingresos anualesizados han superado los 47.000 millones de dólares. Este notable
MeituHub: La plataforma de imágenes con IA de Meitu permite flujos visuales personalizados para empresas
Meitu ha lanzado oficialmente MeituHub, su plataforma de producción de imágenes impulsada por inteligencia artificial, que ofrece soluciones integrales de contenido visual para empresas. Esto incluye todo, desde el análisis inicial de requisitos y la
Recomendaciones de temas especiales relacionados
Diseño y Arte
 Las mejores herramientas de ilustración con IA: crea escenas editoriales y portadas más rápido
Las mejores herramientas de ilustración con IA de 2026: nuestra lista seleccionada incluye las mejores herramientas, diseñadas con gran potencia, para crear rápidamente impresionantes escenas editoriales y llamativas portadas. Cada opción ha sido sometida a rigurosas pruebas en condiciones reales y ofrece una comparación entre las versiones gratuitas y de pago para ayudarte a encontrar la que mejor se adapte a tu flujo de trabajo. Prueba hoy mismo estas soluciones imprescindibles para sacar el máximo partido a la IA y potenciar tu productividad creativa. Descúbrelas ahora en XIX.AI.
 10 herramientas
 xix.ai
Educación y aprendizaje
Los mejores profesores particulares de IA para la preparación de exámenes: practica matemáticas, ciencias e inglés
¡Ya están aquí, en XIX.AI, los mejores tutores de IA para la preparación de exámenes de 2026, con las mejores valoraciones! Nuestra lista seleccionada incluye potentes herramientas revolucionarias que ofrecen comparativas entre versiones gratuitas y de pago, pruebas reales y clasificaciones actualizadas semanalmente. Te ayudan a mejorar tu eficiencia a la hora de escribir, a simplificar el aprendizaje de temas complejos y a desarrollar todo tu potencial académico. ¡Explora ahora mismo para descubrir tu herramienta perfecta de preparación de exámenes y empieza a crear hoy mismo para sacar partido a tu ventaja con la IA!
10 herramientas
xix.ai
Finanzas
Herramientas de planificación presupuestaria con IA para la gestión personal del dinero
2026 Últimas Mejores Herramientas de Planificación Presupuestaria con IA Mejor Valoradas para la Gestión Personal del Dinero están aquí en XIX.AI. Esta colección seleccionada presenta soluciones poderosas y transformadoras que te ayudan a realizar pruebas en el mundo real, comprender tus hábitos de gasto y crear planes personalizados para aumentar la productividad. Disfruta de una comparación entre versiones gratuitas y de pago junto con clasificaciones detalladas. Herramientas imprescindibles diseñadas para simplificar la gestión del dinero y desbloquear tu ventaja con IA. ¡Explóralas ahora!
11 herramientas
xix.ai
Salud y bienestar
Asistentes de seguimiento del sueño basados en IA: mejora tu recuperación con mejores hábitos a la hora de acostarte
Los mejores asistentes de seguimiento del sueño con IA de 2026, seleccionados para una recuperación óptima. Esta guía semanal totalmente actualizada incluye potentes herramientas que ofrecen pruebas en condiciones reales, comparativas entre opciones gratuitas y de pago, y clasificaciones detalladas para ayudarte a encontrar la solución imprescindible que mejora la calidad del sueño y fomenta mejores hábitos a la hora de acostarse. Descúbrelo ahora en XIX.AI y aprovecha todas las ventajas de la IA.
10 herramientas
xix.ai
Análisis de datos
Copilotos de IA y SQL para el análisis de productos e ingresos
¡Los mejores copilotos de IA para SQL mejor valorados de 2026 para el análisis de productos e ingresos! XIX.AI ha seleccionado una potente colección de herramientas revolucionarias que no te puedes perder y que se someten a pruebas en el mundo real a través de clasificaciones que se actualizan semanalmente. Estas herramientas ayudan a los usuarios a aumentar significativamente su productividad al acelerar el análisis de datos, simplificar consultas complejas y generar información precisa para tomar decisiones empresariales más inteligentes. ¡Explora ahora mismo y descubre la herramienta perfecta para sacar el máximo partido a tu ventaja en IA!
14 herramientas
xix.ai
Educación y aprendizaje
Las mejores herramientas de IA para los deberes que realmente enseñan: aprende conceptos, no solo respuestas
2026: los mejores y más valorados asistentes de deberes con IA que enseñan conceptos básicos, no solo respuestas. Potentes herramientas para estudiantes. Una selección imprescindible que debes probar. Actualización semanal. Comparativa entre opciones gratuitas y de pago. Pruebas en el mundo real. Clasificaciones precisas para ayudarte a desarrollar todo tu potencial de aprendizaje. Explora ahora y descubre la herramienta perfecta para estudiar de forma más inteligente.
10 herramientas
xix.ai

 comentario (1)
0/500
![StevenNelson]()
Volc EngineのDoubao Audio Model 1.0、面白そう!1文で映画のような音声が作れるなんて、クリエイターには夢のツールだよね。ただ、10分間のキャラクター音声の安定性が実用レベルかどうかが気になるところ。技術的にはすごいけど、倫理面での規制も必要かも。🎬🔊
Ayer, Volc Engine lanzó oficialmente el modelo de generación de audio Doubao 1.0 (Doubao-Seed-Audio 1.0), que admite entradas de texto o audio para producir obras de audio completas de principio a fin. Su principal avance es que una sola indicación puede gestionar a la vez diálogos, efectos de sonido y música de fondo, lo que elimina la necesidad de realizar una edición manual multipista.
Convierte una frase en un director de audio: no hace falta postproducción.
Anteriormente, crear audio de alta calidad requería generar diálogos, efectos de sonido y música por separado, para luego alinear y mezclar las pistas manualmente —un proceso complejo que dependía de la experiencia en posproducción—. El modelo de generación de audio Doubao 1.0 consolida todo esto en una única indicación: los usuarios pueden definir las líneas de diálogo, el tono y el ritmo emocional de varios personajes en una sola instrucción, incorporar detalles como risas, suspiros, pausas y acentos dialectales, y generar música de fondo y efectos de sonido ambientales simultáneamente, obteniendo directamente un producto terminado. Un creador puede escribir una descripción y recibir de inmediato un podcast, un audiolibro o un audio de marca listo para su publicación.
Voces de los personajes coherentes a lo largo de audios largos sin perder calidad.
El mayor reto en la creación de audios largos es la coherencia: garantizar que un personaje suene igual en el minuto uno y en el minuto diez. El Modelo 1.0 de Doubao Audio Generation integra profundamente la conversión de texto a audio con el audio de referencia, manteniendo una calidad de voz constante a lo largo de segmentos largos, de modo que los creadores no tengan que comparar y revisar cada parte. El modelo actual admite hasta 2 minutos de audio por generación y, gracias a la función de extensión, conserva la coherencia de la voz en grabaciones más largas, lo que lo hace ideal para audiolibros, podcasts y series largas.
Además, el modelo ofrece un control independiente de la voz y el estilo, lo que permite que una misma voz se adapte a diversas emociones y contextos, llegando incluso a permitir que una sola voz interprete múltiples papeles con expresiones diferentes. Esto mejora enormemente la flexibilidad para la interpretación de voces de personajes y la producción creativa de audio. Actualmente, Volc Ark ha abierto las pruebas de la API, y los usuarios particulares pueden obtener una cuota de creación de 30 minutos en el Experience Center. El modelo de generación de audio Doubao 1.0 también se lanzará en productos como CapCut, Jiemod y Tomato.








 Sora Offline mientras Musk impulsa Grok Imagine con actualizaciones prometidas
El mercado global de vídeo con IA ha experimentado un cambio drástico en apenas un día.Tras que OpenAI cerrara su herramienta de vídeo principal Sora, Elon Musk actuó rápidamente para cubrir el vacío. El miércoles, anunció en X que su empresa de IA,
 Los ingresos anuales de Anthropic alcanzan los 47.000 millones de dólares, mientras que la adopción empresarial de Claude se dispara
La competencia entre las principales empresas de inteligencia artificial se intensifica. El 28 de mayo, Anthropic, una destacada empresa emergente de IA, informó que sus ingresos anualesizados han superado los 47.000 millones de dólares. Este notable
 MeituHub: La plataforma de imágenes con IA de Meitu permite flujos visuales personalizados para empresas
Meitu ha lanzado oficialmente MeituHub, su plataforma de producción de imágenes impulsada por inteligencia artificial, que ofrece soluciones integrales de contenido visual para empresas. Esto incluye todo, desde el análisis inicial de requisitos y la

Las mejores herramientas de ilustración con IA de 2026: nuestra lista seleccionada incluye las mejores herramientas, diseñadas con gran potencia, para crear rápidamente impresionantes escenas editoriales y llamativas portadas. Cada opción ha sido sometida a rigurosas pruebas en condiciones reales y ofrece una comparación entre las versiones gratuitas y de pago para ayudarte a encontrar la que mejor se adapte a tu flujo de trabajo. Prueba hoy mismo estas soluciones imprescindibles para sacar el máximo partido a la IA y potenciar tu productividad creativa. Descúbrelas ahora en XIX.AI.
10 herramientas
xix.ai

¡Ya están aquí, en XIX.AI, los mejores tutores de IA para la preparación de exámenes de 2026, con las mejores valoraciones! Nuestra lista seleccionada incluye potentes herramientas revolucionarias que ofrecen comparativas entre versiones gratuitas y de pago, pruebas reales y clasificaciones actualizadas semanalmente. Te ayudan a mejorar tu eficiencia a la hora de escribir, a simplificar el aprendizaje de temas complejos y a desarrollar todo tu potencial académico. ¡Explora ahora mismo para descubrir tu herramienta perfecta de preparación de exámenes y empieza a crear hoy mismo para sacar partido a tu ventaja con la IA!
10 herramientas
xix.ai

2026 Últimas Mejores Herramientas de Planificación Presupuestaria con IA Mejor Valoradas para la Gestión Personal del Dinero están aquí en XIX.AI. Esta colección seleccionada presenta soluciones poderosas y transformadoras que te ayudan a realizar pruebas en el mundo real, comprender tus hábitos de gasto y crear planes personalizados para aumentar la productividad. Disfruta de una comparación entre versiones gratuitas y de pago junto con clasificaciones detalladas. Herramientas imprescindibles diseñadas para simplificar la gestión del dinero y desbloquear tu ventaja con IA. ¡Explóralas ahora!
11 herramientas
xix.ai

Los mejores asistentes de seguimiento del sueño con IA de 2026, seleccionados para una recuperación óptima. Esta guía semanal totalmente actualizada incluye potentes herramientas que ofrecen pruebas en condiciones reales, comparativas entre opciones gratuitas y de pago, y clasificaciones detalladas para ayudarte a encontrar la solución imprescindible que mejora la calidad del sueño y fomenta mejores hábitos a la hora de acostarse. Descúbrelo ahora en XIX.AI y aprovecha todas las ventajas de la IA.
10 herramientas
xix.ai

¡Los mejores copilotos de IA para SQL mejor valorados de 2026 para el análisis de productos e ingresos! XIX.AI ha seleccionado una potente colección de herramientas revolucionarias que no te puedes perder y que se someten a pruebas en el mundo real a través de clasificaciones que se actualizan semanalmente. Estas herramientas ayudan a los usuarios a aumentar significativamente su productividad al acelerar el análisis de datos, simplificar consultas complejas y generar información precisa para tomar decisiones empresariales más inteligentes. ¡Explora ahora mismo y descubre la herramienta perfecta para sacar el máximo partido a tu ventaja en IA!
14 herramientas
xix.ai

2026: los mejores y más valorados asistentes de deberes con IA que enseñan conceptos básicos, no solo respuestas. Potentes herramientas para estudiantes. Una selección imprescindible que debes probar. Actualización semanal. Comparativa entre opciones gratuitas y de pago. Pruebas en el mundo real. Clasificaciones precisas para ayudarte a desarrollar todo tu potencial de aprendizaje. Explora ahora y descubre la herramienta perfecta para estudiar de forma más inteligente.
10 herramientas
xix.ai

Volc EngineのDoubao Audio Model 1.0、面白そう!1文で映画のような音声が作れるなんて、クリエイターには夢のツールだよね。ただ、10分間のキャラクター音声の安定性が実用レベルかどうかが気になるところ。技術的にはすごいけど、倫理面での規制も必要かも。🎬🔊












