


 首頁
Volcano Engine 推出「Doubao Audio Model 1.0」:一句話即可生成電影級音效,10 分鐘內角色聲音始終如一
昨日,Volc Engine 正式推出「Doubao 音訊生成模型 1.0」(Doubao-Seed-Audio 1.0),該模型可接受文字或音訊輸入,並能端到端地生成完整的音訊作品。 其關鍵突破在於,單一提示詞即可同時處理對話、音效與背景音樂,省去了手動進行多軌編輯的步驟。
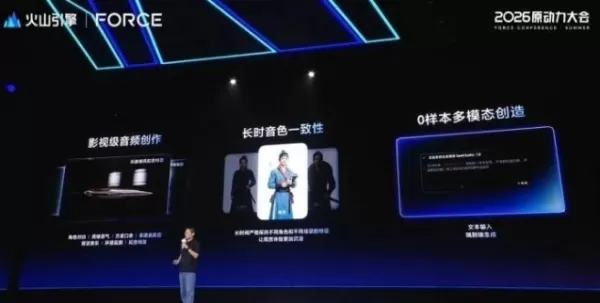
將一句話化為音訊導演——無需後期製作。
以往,要製作高品質的音訊,必須分別生成對白、音效和音樂,然後手動對齊並混音——這是一個複雜的過程,需要倚賴後期製作的專業知識。 「Doubao 音訊生成模型 1.0」將所有這些步驟整合到單一提示中:使用者只需透過一則指令,即可定義多位角色的台詞、語調和情感節奏,嵌入笑聲、嘆息、停頓和方言口音等細節,並同時生成背景音樂和環境音效,直接輸出成品。 創作者只需輸入描述文字,即可立即獲得可直接發布的播客、有聲書或品牌音頻。
在長篇音頻中保持角色聲音的一致性,且不失真。
長篇音訊創作的最大挑戰在於一致性——確保角色在第一分鐘和第十分鐘聽起來都一樣。Doubao 音訊生成模型 1.0 將文字轉音訊技術與參考音訊深度整合,在長篇段落中維持一致的音質,讓創作者無需逐段比較與修改。 當前模型每次生成最多支援 2 分鐘的音訊,並透過延伸功能,在更長的輸出內容中維持聲音的一致性,適用於有聲書、播客及長篇系列作品。
此外,該模型提供語音與風格的分離控制,讓同一聲音能適應各種情緒與情境——甚至能讓單一聲音以不同表情詮釋多個角色。這大大提升了角色配音與創意音頻製作的靈活性。 目前,Volc Ark 已開放 API 測試,個人用戶可在「體驗中心」獲得 30 分鐘的生成配額。「豆寶」語音生成模型 1.0 也將陸續在 CapCut、Jiemod 和 Tomato 等產品上推出。
相關文章
 Sora 離線,馬斯克推動 Grok Imagine 並承諾升級
全球AI影片市場在短短一天內發生了劇烈變化。在OpenAI關閉其旗艦影片工具Sora後,埃隆·馬斯克迅速採取行動填補這一空白。週三,他在X平臺上宣佈,其AI公司xAI正在升級其影片生成器。他寫道:“Grok Imagine的下一個版本將非常令人印象深刻。我們正在加倍投入。”填補空白:Sora退出後的機遇週二,OpenAI突然關閉了Sora,理由是簡化其產品組合的需要。這引發了人們對AI影片高昂成本和低迴報率的質疑,但也為競爭對手開啟了大門:核心重點: 今年二月,Grok Imagine被
Anthropic 年收入達 470 億美元,Claude 企業採用率飆升
領先的人工智慧公司之間的競爭正在加劇。5月28日,知名AI初創公司Anthropic宣佈,其年化收入已超過470億美元。這一顯著的財務里程碑凸顯了生成式AI技術的快速商業化及其市場潛力。對其增長軌跡的分析表明,這一成就源於企業領域的廣泛採用。繼2月完成G輪融資後,Anthropic的旗艦模型Claude在全球企業客戶中展現出強勁的使用者滲透率和應用規模擴張。從技術角度來看,Anthropic近期的產品增強為商業成功奠定了堅實基礎。該公司最近釋出了高效能AI模型,並推出了其最新旗艦版本Claud
美圖Hub:美圖的AI影象平臺為企業提供定製化視覺工作流
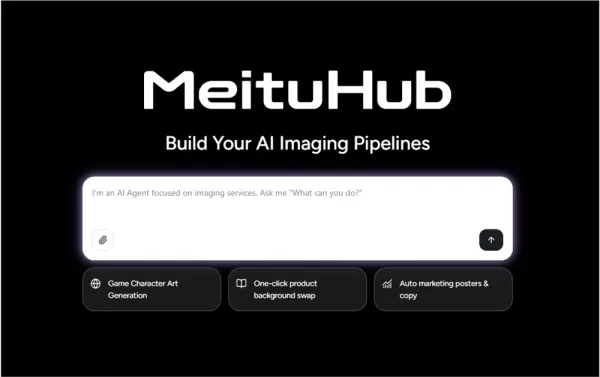
美圖已正式推出基於人工智慧的圖片製作平臺 MeituHub,為企業提供端到端的視覺內容解決方案。該方案涵蓋從初始需求分析、工作流配置到最終資產交付的全流程。藉助美圖全面的技術棧,企業可以透過簡單的自然語言指令設計自定義視覺工作流,無需複雜的程式碼編寫,並部署可複用的 Web 應用程式。隨著生成式人工智慧工具的普及,許多組織雖然擁有先進的人工智慧能力,卻難以將其整合為連貫、高效的生產流水線。傳統上,設計師需要手動操作多種軟體工具來管理資產、生成概念並確定最終輸出,這制約了大規模內容創作的效率。美圖強
相關專題推薦
設計與藝術
 頂尖 AI 插畫工具:更快地創作編輯畫面與封面插圖
2026 年最新高評分 AI 插畫工具:我們精心挑選的清單收錄了功能強大、設計出色的工具,能助您快速創作出令人驚豔的編輯場景與吸睛的封面藝術。每項選項均經過嚴格的實際測試,並提供免費版與付費版的比較,協助您找到最適合您工作流程的工具。 立即嘗試這些不可錯過的解決方案,釋放您的人工智慧優勢,並提升您的創意生產力。現在就前往 XIX.AI 探索吧。
 10 個工具
 xix.ai
教育與學習
頂尖 AI 補習老師助您備考:練習數學、科學和英語
2026 年最新、評價最高的考試備考 AI 輔導工具,盡在 XIX.AI!我們精心挑選的清單收錄了多款強大且顛覆傳統的工具,提供免費與付費版本的比較、實際測試,以及每週更新的排行榜。這些工具能幫助您提升寫作效率、簡化複雜主題的學習,並釋放您的學術潛能。 立即探索,發掘最適合您的備考工具,並從今天開始創作,釋放您的 AI 優勢!
10 個工具
xix.ai
金融
用於個人財務管理的 AI 預算規劃工具
2026 年最新最佳頂級評分 AI 預算規劃工具,專為個人財務管理打造,現已登陸 XIX.AI!本精選合集收錄了強大且具顛覆性的解決方案,助您開展實際測試、理解消費習慣,並制定個性化計劃以提升生產力。享受免費與付費版的對比及詳細排名。這些必試工具旨在簡化財務管理,助您釋放 AI 優勢。立即探索!
11 個工具
xix.ai
健康與養生
AI 睡眠追蹤助手:透過更佳的睡前習慣提升恢復效果
2026 年最新精選、評價最高的 AI 睡眠追蹤助手,助您獲得最佳恢復效果。這份全面更新的每週指南收錄了強大的工具,提供實際測試報告、免費與付費版本的比較,以及詳細排名,協助您找到必試的解決方案,以提升睡眠品質並培養更好的就寢習慣。 立即造訪 XIX.AI,解鎖您的 AI 優勢。
10 個工具
xix.ai
數據分析
用於產品與營收分析的 AI SQL 協作助手
2026 年最新最佳、評價最高的 AI SQL 輔助工具,專為產品與營收分析打造! XIX.AI 精心甄選了一系列強大且顛覆業界的必試工具,這些工具均經過實戰測試,並透過每週更新的排行榜進行評比。這些工具能透過加速資料分析、簡化複雜查詢,並產生精準洞察來推動更明智的商業決策,從而大幅提升使用者生產力。立即探索,發掘最適合您的工具,釋放您的 AI 優勢!
14 個工具
xix.ai
教育與學習
最佳的「教學型」AI 作業輔助工具:學習概念,而不僅是答案
2026 年最新最佳高評價 AI 作業輔助工具:不僅提供答案,更教授核心概念。專為學生打造的強大工具,必試精選清單,每週更新,免費與付費版本比較,實際測試,精準排名,助您充分發揮學習潛能。立即探索,發掘最適合您的工具,讓學習更聰明。
10 個工具
xix.ai

 評論 (1)
0/500
![StevenNelson]()
Volc EngineのDoubao Audio Model 1.0、面白そう!1文で映画のような音声が作れるなんて、クリエイターには夢のツールだよね。ただ、10分間のキャラクター音声の安定性が実用レベルかどうかが気になるところ。技術的にはすごいけど、倫理面での規制も必要かも。🎬🔊
昨日,Volc Engine 正式推出「Doubao 音訊生成模型 1.0」(Doubao-Seed-Audio 1.0),該模型可接受文字或音訊輸入,並能端到端地生成完整的音訊作品。 其關鍵突破在於,單一提示詞即可同時處理對話、音效與背景音樂,省去了手動進行多軌編輯的步驟。
將一句話化為音訊導演——無需後期製作。
以往,要製作高品質的音訊,必須分別生成對白、音效和音樂,然後手動對齊並混音——這是一個複雜的過程,需要倚賴後期製作的專業知識。 「Doubao 音訊生成模型 1.0」將所有這些步驟整合到單一提示中:使用者只需透過一則指令,即可定義多位角色的台詞、語調和情感節奏,嵌入笑聲、嘆息、停頓和方言口音等細節,並同時生成背景音樂和環境音效,直接輸出成品。 創作者只需輸入描述文字,即可立即獲得可直接發布的播客、有聲書或品牌音頻。
在長篇音頻中保持角色聲音的一致性,且不失真。
長篇音訊創作的最大挑戰在於一致性——確保角色在第一分鐘和第十分鐘聽起來都一樣。Doubao 音訊生成模型 1.0 將文字轉音訊技術與參考音訊深度整合,在長篇段落中維持一致的音質,讓創作者無需逐段比較與修改。 當前模型每次生成最多支援 2 分鐘的音訊,並透過延伸功能,在更長的輸出內容中維持聲音的一致性,適用於有聲書、播客及長篇系列作品。
此外,該模型提供語音與風格的分離控制,讓同一聲音能適應各種情緒與情境——甚至能讓單一聲音以不同表情詮釋多個角色。這大大提升了角色配音與創意音頻製作的靈活性。 目前,Volc Ark 已開放 API 測試,個人用戶可在「體驗中心」獲得 30 分鐘的生成配額。「豆寶」語音生成模型 1.0 也將陸續在 CapCut、Jiemod 和 Tomato 等產品上推出。








 Sora 離線,馬斯克推動 Grok Imagine 並承諾升級
全球AI影片市場在短短一天內發生了劇烈變化。在OpenAI關閉其旗艦影片工具Sora後,埃隆·馬斯克迅速採取行動填補這一空白。週三,他在X平臺上宣佈,其AI公司xAI正在升級其影片生成器。他寫道:“Grok Imagine的下一個版本將非常令人印象深刻。我們正在加倍投入。”填補空白:Sora退出後的機遇週二,OpenAI突然關閉了Sora,理由是簡化其產品組合的需要。這引發了人們對AI影片高昂成本和低迴報率的質疑,但也為競爭對手開啟了大門:核心重點: 今年二月,Grok Imagine被
 Anthropic 年收入達 470 億美元,Claude 企業採用率飆升
領先的人工智慧公司之間的競爭正在加劇。5月28日,知名AI初創公司Anthropic宣佈,其年化收入已超過470億美元。這一顯著的財務里程碑凸顯了生成式AI技術的快速商業化及其市場潛力。對其增長軌跡的分析表明,這一成就源於企業領域的廣泛採用。繼2月完成G輪融資後,Anthropic的旗艦模型Claude在全球企業客戶中展現出強勁的使用者滲透率和應用規模擴張。從技術角度來看,Anthropic近期的產品增強為商業成功奠定了堅實基礎。該公司最近釋出了高效能AI模型,並推出了其最新旗艦版本Claud
 美圖Hub:美圖的AI影象平臺為企業提供定製化視覺工作流
美圖已正式推出基於人工智慧的圖片製作平臺 MeituHub,為企業提供端到端的視覺內容解決方案。該方案涵蓋從初始需求分析、工作流配置到最終資產交付的全流程。藉助美圖全面的技術棧,企業可以透過簡單的自然語言指令設計自定義視覺工作流,無需複雜的程式碼編寫,並部署可複用的 Web 應用程式。隨著生成式人工智慧工具的普及,許多組織雖然擁有先進的人工智慧能力,卻難以將其整合為連貫、高效的生產流水線。傳統上,設計師需要手動操作多種軟體工具來管理資產、生成概念並確定最終輸出,這制約了大規模內容創作的效率。美圖強

2026 年最新高評分 AI 插畫工具:我們精心挑選的清單收錄了功能強大、設計出色的工具,能助您快速創作出令人驚豔的編輯場景與吸睛的封面藝術。每項選項均經過嚴格的實際測試,並提供免費版與付費版的比較,協助您找到最適合您工作流程的工具。 立即嘗試這些不可錯過的解決方案,釋放您的人工智慧優勢,並提升您的創意生產力。現在就前往 XIX.AI 探索吧。
10 個工具
xix.ai

2026 年最新、評價最高的考試備考 AI 輔導工具,盡在 XIX.AI!我們精心挑選的清單收錄了多款強大且顛覆傳統的工具,提供免費與付費版本的比較、實際測試,以及每週更新的排行榜。這些工具能幫助您提升寫作效率、簡化複雜主題的學習,並釋放您的學術潛能。 立即探索,發掘最適合您的備考工具,並從今天開始創作,釋放您的 AI 優勢!
10 個工具
xix.ai

2026 年最新最佳頂級評分 AI 預算規劃工具,專為個人財務管理打造,現已登陸 XIX.AI!本精選合集收錄了強大且具顛覆性的解決方案,助您開展實際測試、理解消費習慣,並制定個性化計劃以提升生產力。享受免費與付費版的對比及詳細排名。這些必試工具旨在簡化財務管理,助您釋放 AI 優勢。立即探索!
11 個工具
xix.ai

2026 年最新精選、評價最高的 AI 睡眠追蹤助手,助您獲得最佳恢復效果。這份全面更新的每週指南收錄了強大的工具,提供實際測試報告、免費與付費版本的比較,以及詳細排名,協助您找到必試的解決方案,以提升睡眠品質並培養更好的就寢習慣。 立即造訪 XIX.AI,解鎖您的 AI 優勢。
10 個工具
xix.ai

2026 年最新最佳、評價最高的 AI SQL 輔助工具,專為產品與營收分析打造! XIX.AI 精心甄選了一系列強大且顛覆業界的必試工具,這些工具均經過實戰測試,並透過每週更新的排行榜進行評比。這些工具能透過加速資料分析、簡化複雜查詢,並產生精準洞察來推動更明智的商業決策,從而大幅提升使用者生產力。立即探索,發掘最適合您的工具,釋放您的 AI 優勢!
14 個工具
xix.ai

2026 年最新最佳高評價 AI 作業輔助工具:不僅提供答案,更教授核心概念。專為學生打造的強大工具,必試精選清單,每週更新,免費與付費版本比較,實際測試,精準排名,助您充分發揮學習潛能。立即探索,發掘最適合您的工具,讓學習更聰明。
10 個工具
xix.ai

Volc EngineのDoubao Audio Model 1.0、面白そう!1文で映画のような音声が作れるなんて、クリエイターには夢のツールだよね。ただ、10分間のキャラクター音声の安定性が実用レベルかどうかが気になるところ。技術的にはすごいけど、倫理面での規制も必要かも。🎬🔊












