


 首页
开源开发人员用独创性和报应来对抗AI爬行者
人工智能网络爬虫已成为许多软件开发者的噩梦。据称,一些开发者开始以创意且常常有趣的策略进行反击。
开源开发者尤其受到这些恶意爬虫的严重影响,正如Linux桌面Plasma和博客LibreNews的开发者Niccolò Venerandi所指出的。托管免费和开源项目的FOSS网站暴露了更多基础设施,且通常比商业网站资源更少。
问题因许多人工智能爬虫忽略Robots Exclusion Protocol的robot.txt文件而加剧,该文件旨在指示爬虫哪些内容不可抓取。
在一篇1月发表的感人博客文章中,FOSS开发者Xe Iaso分享了与AmazonBot的痛苦经历,该爬虫轰炸了一个Git服务器网站,导致DDoS中断。Git服务器对托管FOSS项目至关重要,允许任何人下载并贡献代码。
Iaso指出,该爬虫无视robot.txt文件,使用不同的IP地址,甚至伪装成其他用户。“阻止人工智能爬虫是徒劳的,因为它们会撒谎、更改用户代理、使用住宅IP地址作为代理等等,”Iaso感叹道。
“它们会抓取你的网站直到它崩溃,然后继续抓取。它们会点击每个链接的每个链接的每个链接,反复查看相同的页面。有些甚至会在同一秒内多次点击同一个链接,”这位开发者写道。
墓地之神的出现
为应对这一问题,Iaso开发了一个巧妙的工具Anubis。它作为一个反向代理,要求在允许请求到达Git服务器之前进行工作量证明检查。这有效地阻止了爬虫,同时允许人类操作的浏览器通过。
该工具以埃及神话中的Anubis命名,Anubis是将死者引领到审判的神。Iaso向TechCrunch解释说:“Anubis会称量你的灵魂(心脏),如果它比羽毛重,你的心脏会被吃掉,你就会彻底死亡。”成功通过挑战会得到一张可爱的Anubis动漫图片,而爬虫请求则被拒绝。
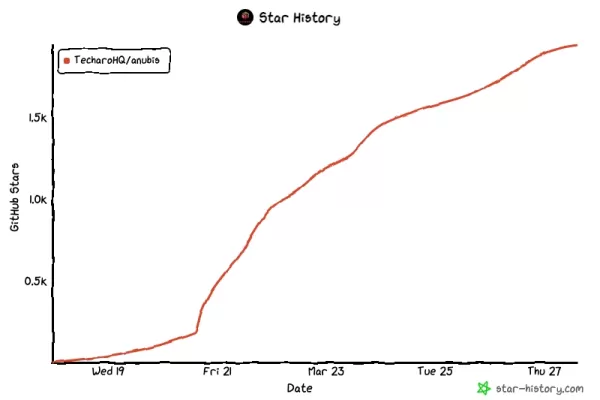
该项目于3月19日在GitHub上分享,迅速获得关注,仅几天就积累了2000个星标、20个贡献者和39个分叉。
以报复为防御
Anubis的广泛采用表明Iaso的困境并非孤立。Venerandi讲述了许多类似的经历:
- SourceHut的创始人兼首席执行官Drew DeVault花费大量时间应对激进的LLM爬虫,并遭受频繁的中断。
- 著名FOSS开发者兼LWN运营商Jonathan Corbet看到他的网站因人工智能爬虫而变慢。
- Linux Fedora项目的系统管理员Kevin Fenzi因激进的人工智能爬虫活动不得不屏蔽来自巴西的所有流量。
Venerandi向TechCrunch提到,他知道其他项目不得不采取极端措施,比如禁止所有中国IP地址。
一些开发者认为以报复的方式进行防御是最佳策略。Hacker News上的一位名叫xyzal的用户建议在robot.txt禁止的页面中填充误导性内容,比如宣扬喝漂白水的好处或麻疹对卧室表现的积极影响。
“我们需要让爬虫访问我们的陷阱时获得负效用价值,而不仅仅是零价值,”xyzal解释说。
1月,一位匿名开发者“Aaron”发布了Nepenthes,这是一个旨在将爬虫困在虚假内容迷宫中的工具,其创作者向Ars Technica承认该工具激进,甚至有些恶意。以一种食肉植物命名的Nepenthes旨在迷惑并浪费不良爬虫的资源。
同样,Cloudflare最近推出了AI Labyrinth,旨在减缓、迷惑并浪费忽略“不可抓取”指令的人工智能爬虫的资源。该工具向这些爬虫提供无关内容,以保护合法网站数据。
SourceHut的DeVault向TechCrunch表示,虽然Nepenthes通过向爬虫提供无意义内容带来一种正义感,但Anubis已被证明是他的网站更有效的解决方案。然而,他也发出了一个恳切的请求:“请停止合法化LLM、人工智能图像生成器或GitHub Copilot等垃圾。我恳求你们停止使用它们,停止讨论它们,停止创造新的,只是停止。”
鉴于这种情况不太可能发生,开发者,尤其是FOSS社区的开发者,继续以聪明才智和一丝幽默进行反击。
相关文章
 Anthropic 将 Claude AI 编码工具扩展至日本,以推动海外增长
Anthropic,一家美国知名的人工智能公司,正加强其全球推广力度。周三,该公司在东京举办了一场大型开发者活动“Code with Claude”,吸引了近500名软件工程师参加。该举措旨在积极将Claude AI工具及相关产品引入日本市场,强调其自主编码能力在提升企业生产力方面的核心优势。强调自动化代码生成在活动中,Anthropic展示了其先进的自主编码系统,该系统能够独立处理复杂的编程任务并优化现有代码结构。随着全球对高效开发工具的需求不断增长,Anthropic希望通过此类活动加强
印度软件巨头缩减招聘,承诺随着 AI 代理规模扩大不裁员
随着人工智能重塑传统的劳动密集型商业模式,印度领先的软件外包公司塔塔咨询服务公司(TCS)公布了其战略应对措施。在周二的年度股东大会上,董事长概述了人机协作的愿景,并澄清了公司在人工智能时代的人力资源战略。不裁员,但招聘将放缓TCS董事长明确表示,公司没有因采用人工智能而裁员的计划,尽管整体招聘速度将放缓。虽然TCS此前减少了超过10,000名员工,但官员们强调,公司现在更倾向于通过自然流失来优化其人员结构,而非突然裁员。高层管理人员指出,以前由人类处理的重复性、机械性任务正不可避免地转向
中国在全国高考期间锁定人工智能模型,以阻止即时作业辅导
随着2026年高考临近,关于考试期间暂停使用AI工具的谣言引发了激烈的网络争论。针对公众关切,各大AI平台和教育应用澄清了立场:并非全面禁止,而是对考试相关功能实施有针对性的“限时锁定”。这些平台采用了精确的基于时间的控制机制。在官方考试时间内,如拍照解题和题目分析等功能将被暂时禁用。然而,日常对话功能和一般生活类查询对用户完全开放。这种有针对性的做法并非没有先例。去年,几个AI平台在高考期间引入了类似的限制措施。业内人士指出,这些措施旨在符合监管标准,即禁止使用深度合成服务从事损害公共利益
相关专题推荐
设计与艺术
 最适合创意实验的AI风格转换工具
2026年最新最佳、评价最高的AI风格转换工具,助您开展创意实验!XIX.AI精心甄选了一系列功能强大、颠覆性的必试工具,这些工具经过实际测试和严格排名,可带来卓越的效果。这些顶级解决方案通过加速内容创作并释放无限创意潜能,帮助创作者显著提升工作效率。 立即探索,找到最适合您的工具,今天就开始创作吧!
 9 个工具
 xix.ai
漫画创作
最适合视觉叙事的AI对话气泡工具
2026年最新、最受欢迎的视觉叙事AI对话气泡工具现已登陆XIX.AI!这份精心精选的合集汇集了功能强大、具有颠覆性的工具,可帮助创作者提升工作效率并突破创作瓶颈。 获取免费版与付费版的对比分析,查看实际测试结果,并查阅最新排行榜,找到最适合打造引人入胜的视觉叙事的必试解决方案。立即探索,发现您的理想工具!
10 个工具
xix.ai
会议助理
顶级AI会议摘要工具:清晰追踪决策与后续跟进
2026年最新高评分最佳AI会议摘要工具,助您清晰追踪决策并轻松跟进。这份精心筛选的清单展示了功能强大、具有颠覆性的解决方案,它们通过自动化会议记录、识别关键行动项以及简化所有项目中的团队协调,显著提升工作效率。 获取免费版与付费版的对比分析,以及实际测试报告和每周更新的排行榜,助您找到最适合的工具。立即探索,释放您的AI优势!
9 个工具
xix.ai
数据分析
最佳人工智能数据清洗工具:快速处理缺失值与重复数据
2026年最新、最优秀且评分最高的AI数据清洗工具,可快速处理缺失值与重复数据问题。这份精心挑选的清单展示了那些功能强大、能带来颠覆性变革的解决方案,可显著提升工作效率。所有候选工具都经过了严格的实际应用测试,以确保其稳定性。您可以获取免费版与付费版的对比信息,找出最符合您需求的必备工具。即刻访问XIX.AI,开启您的AI优势之旅。
11 个工具
xix.ai
设计与艺术
最佳AI创意构思工具,助力艺术家突破视觉瓶颈
2026 年最新最佳顶级评分 AI 创意构思工具由 XIX.AI 精心策划,旨在帮助创作者突破视觉瓶颈并即时提升创造力。这些强大的变革性工具提供真实世界测试、详细的免费与付费对比以及每周更新的排名。发现您的完美工具,加速内容创作,并立即释放您的 AI 优势。立即探索!
14 个工具
xix.ai
音乐创作
适用于 TikTok 背景音乐、Reels 音频和创作者宣传音乐的 AI 节拍生成器
2026年最新最全的AI节拍生成器,适用于TikTok背景音乐、Reels音频及创作者宣传音乐!XIX.AI精心筛选了一系列广受好评、功能强大的革命性工具,这些工具均经过实际测试,可为各类内容创作需求提供完美的音乐。 您将在此找到详尽的免费版与付费版对比数据、每周更新的排行榜,以及不容错过的精选工具,助您激发创意并提升工作效率。立即探索,发现最适合您的工具!
11 个工具
xix.ai

 评论 (20)
0/500
![KennethMartin]()
Interesting read! It's wild how AI crawlers are basically the new internet pests. I've seen some devs use fake data traps or even redirect bots to weird sites 😂. But honestly, should we be worried about a future where only big companies can afford to protect their content? Feels like a digital arms race.
![PaulTaylor]()
¡Qué creatividad la de estos desarrolladores! 😃 Me preocupa que esta 'lucha' contra los crawlers de IA consuma tanto tiempo y energía que podría desviarlos de lo realmente importante: programar. Ojalá hubiera soluciones más estandarizadas, porque esto parece una carrera armamentística sin fin.
![KennethMartin]()
These AI crawlers are like uninvited guests at a party, munching on all the free code! 😅 Devs fighting back with clever traps is pure genius—love the creativity!
![OliverPhillips]()
Wow, open source devs are getting super creative fighting those AI crawlers! I love how they’re turning the tables with clever traps—kinda like digital pranksters. Makes me wonder how far this cat-and-mouse game will go! 😄
![KennethJones]()
Super interesting read! It's wild how devs are outsmarting AI crawlers with such clever tricks. Gotta love the open-source community's creativity! 😎
![LucasWalker]()
オープンソース開発者にとってこのツールは救世主です!AIクローラーに対する反撃が面白くて、クリエイティブさと正義感がコミュニティに広がるのが好きです。もっとカスタマイズできる機能が増えるといいですね🤓
人工智能网络爬虫已成为许多软件开发者的噩梦。据称,一些开发者开始以创意且常常有趣的策略进行反击。
开源开发者尤其受到这些恶意爬虫的严重影响,正如Linux桌面Plasma和博客LibreNews的开发者Niccolò Venerandi所指出的。托管免费和开源项目的FOSS网站暴露了更多基础设施,且通常比商业网站资源更少。
问题因许多人工智能爬虫忽略Robots Exclusion Protocol的robot.txt文件而加剧,该文件旨在指示爬虫哪些内容不可抓取。
在一篇1月发表的感人博客文章中,FOSS开发者Xe Iaso分享了与AmazonBot的痛苦经历,该爬虫轰炸了一个Git服务器网站,导致DDoS中断。Git服务器对托管FOSS项目至关重要,允许任何人下载并贡献代码。
Iaso指出,该爬虫无视robot.txt文件,使用不同的IP地址,甚至伪装成其他用户。“阻止人工智能爬虫是徒劳的,因为它们会撒谎、更改用户代理、使用住宅IP地址作为代理等等,”Iaso感叹道。
“它们会抓取你的网站直到它崩溃,然后继续抓取。它们会点击每个链接的每个链接的每个链接,反复查看相同的页面。有些甚至会在同一秒内多次点击同一个链接,”这位开发者写道。
墓地之神的出现
为应对这一问题,Iaso开发了一个巧妙的工具Anubis。它作为一个反向代理,要求在允许请求到达Git服务器之前进行工作量证明检查。这有效地阻止了爬虫,同时允许人类操作的浏览器通过。
该工具以埃及神话中的Anubis命名,Anubis是将死者引领到审判的神。Iaso向TechCrunch解释说:“Anubis会称量你的灵魂(心脏),如果它比羽毛重,你的心脏会被吃掉,你就会彻底死亡。”成功通过挑战会得到一张可爱的Anubis动漫图片,而爬虫请求则被拒绝。
该项目于3月19日在GitHub上分享,迅速获得关注,仅几天就积累了2000个星标、20个贡献者和39个分叉。
以报复为防御
Anubis的广泛采用表明Iaso的困境并非孤立。Venerandi讲述了许多类似的经历:
- SourceHut的创始人兼首席执行官Drew DeVault花费大量时间应对激进的LLM爬虫,并遭受频繁的中断。
- 著名FOSS开发者兼LWN运营商Jonathan Corbet看到他的网站因人工智能爬虫而变慢。
- Linux Fedora项目的系统管理员Kevin Fenzi因激进的人工智能爬虫活动不得不屏蔽来自巴西的所有流量。
Venerandi向TechCrunch提到,他知道其他项目不得不采取极端措施,比如禁止所有中国IP地址。
一些开发者认为以报复的方式进行防御是最佳策略。Hacker News上的一位名叫xyzal的用户建议在robot.txt禁止的页面中填充误导性内容,比如宣扬喝漂白水的好处或麻疹对卧室表现的积极影响。
“我们需要让爬虫访问我们的陷阱时获得负效用价值,而不仅仅是零价值,”xyzal解释说。
1月,一位匿名开发者“Aaron”发布了Nepenthes,这是一个旨在将爬虫困在虚假内容迷宫中的工具,其创作者向Ars Technica承认该工具激进,甚至有些恶意。以一种食肉植物命名的Nepenthes旨在迷惑并浪费不良爬虫的资源。
同样,Cloudflare最近推出了AI Labyrinth,旨在减缓、迷惑并浪费忽略“不可抓取”指令的人工智能爬虫的资源。该工具向这些爬虫提供无关内容,以保护合法网站数据。
SourceHut的DeVault向TechCrunch表示,虽然Nepenthes通过向爬虫提供无意义内容带来一种正义感,但Anubis已被证明是他的网站更有效的解决方案。然而,他也发出了一个恳切的请求:“请停止合法化LLM、人工智能图像生成器或GitHub Copilot等垃圾。我恳求你们停止使用它们,停止讨论它们,停止创造新的,只是停止。”
鉴于这种情况不太可能发生,开发者,尤其是FOSS社区的开发者,继续以聪明才智和一丝幽默进行反击。








 Anthropic 将 Claude AI 编码工具扩展至日本,以推动海外增长
Anthropic,一家美国知名的人工智能公司,正加强其全球推广力度。周三,该公司在东京举办了一场大型开发者活动“Code with Claude”,吸引了近500名软件工程师参加。该举措旨在积极将Claude AI工具及相关产品引入日本市场,强调其自主编码能力在提升企业生产力方面的核心优势。强调自动化代码生成在活动中,Anthropic展示了其先进的自主编码系统,该系统能够独立处理复杂的编程任务并优化现有代码结构。随着全球对高效开发工具的需求不断增长,Anthropic希望通过此类活动加强
 印度软件巨头缩减招聘,承诺随着 AI 代理规模扩大不裁员
随着人工智能重塑传统的劳动密集型商业模式,印度领先的软件外包公司塔塔咨询服务公司(TCS)公布了其战略应对措施。在周二的年度股东大会上,董事长概述了人机协作的愿景,并澄清了公司在人工智能时代的人力资源战略。不裁员,但招聘将放缓TCS董事长明确表示,公司没有因采用人工智能而裁员的计划,尽管整体招聘速度将放缓。虽然TCS此前减少了超过10,000名员工,但官员们强调,公司现在更倾向于通过自然流失来优化其人员结构,而非突然裁员。高层管理人员指出,以前由人类处理的重复性、机械性任务正不可避免地转向
 中国在全国高考期间锁定人工智能模型,以阻止即时作业辅导
随着2026年高考临近,关于考试期间暂停使用AI工具的谣言引发了激烈的网络争论。针对公众关切,各大AI平台和教育应用澄清了立场:并非全面禁止,而是对考试相关功能实施有针对性的“限时锁定”。这些平台采用了精确的基于时间的控制机制。在官方考试时间内,如拍照解题和题目分析等功能将被暂时禁用。然而,日常对话功能和一般生活类查询对用户完全开放。这种有针对性的做法并非没有先例。去年,几个AI平台在高考期间引入了类似的限制措施。业内人士指出,这些措施旨在符合监管标准,即禁止使用深度合成服务从事损害公共利益

2026年最新最佳、评价最高的AI风格转换工具,助您开展创意实验!XIX.AI精心甄选了一系列功能强大、颠覆性的必试工具,这些工具经过实际测试和严格排名,可带来卓越的效果。这些顶级解决方案通过加速内容创作并释放无限创意潜能,帮助创作者显著提升工作效率。 立即探索,找到最适合您的工具,今天就开始创作吧!
9 个工具
xix.ai

2026年最新、最受欢迎的视觉叙事AI对话气泡工具现已登陆XIX.AI!这份精心精选的合集汇集了功能强大、具有颠覆性的工具,可帮助创作者提升工作效率并突破创作瓶颈。 获取免费版与付费版的对比分析,查看实际测试结果,并查阅最新排行榜,找到最适合打造引人入胜的视觉叙事的必试解决方案。立即探索,发现您的理想工具!
10 个工具
xix.ai

2026年最新高评分最佳AI会议摘要工具,助您清晰追踪决策并轻松跟进。这份精心筛选的清单展示了功能强大、具有颠覆性的解决方案,它们通过自动化会议记录、识别关键行动项以及简化所有项目中的团队协调,显著提升工作效率。 获取免费版与付费版的对比分析,以及实际测试报告和每周更新的排行榜,助您找到最适合的工具。立即探索,释放您的AI优势!
9 个工具
xix.ai

2026年最新、最优秀且评分最高的AI数据清洗工具,可快速处理缺失值与重复数据问题。这份精心挑选的清单展示了那些功能强大、能带来颠覆性变革的解决方案,可显著提升工作效率。所有候选工具都经过了严格的实际应用测试,以确保其稳定性。您可以获取免费版与付费版的对比信息,找出最符合您需求的必备工具。即刻访问XIX.AI,开启您的AI优势之旅。
11 个工具
xix.ai
2026 年最新最佳顶级评分 AI 创意构思工具由 XIX.AI 精心策划,旨在帮助创作者突破视觉瓶颈并即时提升创造力。这些强大的变革性工具提供真实世界测试、详细的免费与付费对比以及每周更新的排名。发现您的完美工具,加速内容创作,并立即释放您的 AI 优势。立即探索!
14 个工具
xix.ai
2026年最新最全的AI节拍生成器,适用于TikTok背景音乐、Reels音频及创作者宣传音乐!XIX.AI精心筛选了一系列广受好评、功能强大的革命性工具,这些工具均经过实际测试,可为各类内容创作需求提供完美的音乐。 您将在此找到详尽的免费版与付费版对比数据、每周更新的排行榜,以及不容错过的精选工具,助您激发创意并提升工作效率。立即探索,发现最适合您的工具!
11 个工具
xix.ai

Interesting read! It's wild how AI crawlers are basically the new internet pests. I've seen some devs use fake data traps or even redirect bots to weird sites 😂. But honestly, should we be worried about a future where only big companies can afford to protect their content? Feels like a digital arms race.
¡Qué creatividad la de estos desarrolladores! 😃 Me preocupa que esta 'lucha' contra los crawlers de IA consuma tanto tiempo y energía que podría desviarlos de lo realmente importante: programar. Ojalá hubiera soluciones más estandarizadas, porque esto parece una carrera armamentística sin fin.
These AI crawlers are like uninvited guests at a party, munching on all the free code! 😅 Devs fighting back with clever traps is pure genius—love the creativity!
Wow, open source devs are getting super creative fighting those AI crawlers! I love how they’re turning the tables with clever traps—kinda like digital pranksters. Makes me wonder how far this cat-and-mouse game will go! 😄
Super interesting read! It's wild how devs are outsmarting AI crawlers with such clever tricks. Gotta love the open-source community's creativity! 😎
オープンソース開発者にとってこのツールは救世主です!AIクローラーに対する反撃が面白くて、クリエイティブさと正義感がコミュニティに広がるのが好きです。もっとカスタマイズできる機能が増えるといいですね🤓












