


 首页
OpenAI 抨击 AI 基准测试:近三分之一的问题存在缺陷,通过率在 8 个月内飙升至 80%
OpenAI在一篇博客文章中公开质疑了业界领先的基准测试工具SWE-Bench Pro,称其731个公开测试任务中约有30%存在评估缺陷。 由 Scale AI 开发的 SWE-Bench Pro 旨在评估大型语言模型和 AI 代理的编码能力。由于它高度模拟了现实世界中的企业开发场景,并实施了严格的反作弊措施,因此已成为 AI 软件工程领域广受信赖的基准测试。
OpenAI 在博文中指出了一个关键信号:顶级模型在此基准测试中的通过率在短短八个月内从 23.3% 跃升至 80.3%。如此迅猛的进步令人起疑,OpenAI 认为该基准测试已无法准确衡量模型在现实世界中的软件开发能力。 这一问题很可能源于评估机制本身的缺陷,而非模型能力真正实现了飞跃。
经过交叉验证的两条审查路径显示,近30%的任务被判定为“不合格”。
为验证这一情况,OpenAI启动了两项并行的审查流程。数据点分析发现了200个未通过的任务,占731个公开任务的27.4%。与此同时,人工标注则标记出249个未通过的任务,占比34.1%。 通过交叉比对这两种方法,OpenAI 估计 SWE-Bench Pro 任务中约有 30% 存在缺陷,主要分为四类:测试标准过严、提示词不充分、测试覆盖范围过窄以及提示词具有误导性。
OpenAI 还分享了一个典型案例:某项任务要求在将内容转换为 Markdown 格式时,行首仅保留一个空格,但隐藏的测试标准却要求保留两个空格。 因此,即使模型遵循了明文要求,仍会被判定为错误。这种显式指令与隐含要求之间的不匹配,直接扭曲了对模型真实能力的评估,也解释了通过率出现不合理飙升的原因。
撤回采用建议并呼吁重建 AI 评估体系
基于这一分析,OpenAI 已正式撤回其此前关于使用 SWE-Bench Pro 的推荐。该公司认为,未来的基准测试应由经验丰富的软件开发人员专门针对 AI 评估而设计,而非将原本为人类开发人员设计的测试逻辑直接套用。 如果一个行业基准测试中近 30% 的任务存在缺陷,整个 AI 评估体系的可信度就会受到质疑。将重点从追求分数的竞赛转向对真实工程能力的评估,这可能是 AI 软件工程评估中的下一个关键步骤。
相关文章
 专业动画代理工具OiiOii正式上线,被誉为AI时代的皮克斯
4月2日,全球首款专业级动画创作助手OiiOii结束了测试阶段,并宣布正式全球发布。这款“黑马”产品仅开放100个测试名额便吸引了10万名申请者,旨在通过先进的人工智能技术打破动画制作中的专业壁垒。核心亮点:7个智能代理协同工作,让专业工具变得简单OiiOii的主要优势在于其独特的“多智能体”协作框架:原生智能体架构:该架构无缝整合了七个协同工作的专业AI智能体。用户无需掌握复杂的提示语或技术术语
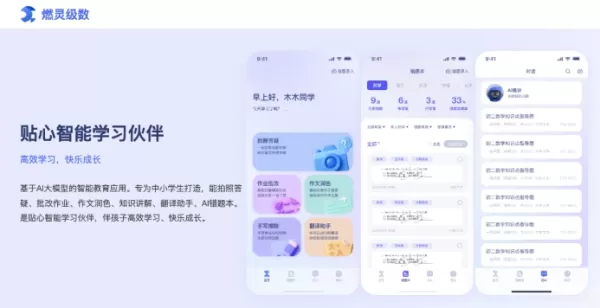
教育领域新锐企业AI JiShu完成数百万融资,推出软硬件一体化战略
随着人工智能持续推动各行业转型,教育领域也因一家极具潜力的新兴企业的涌现而迎来突破。4月22日,广州技树人工智能科技有限公司(以下简称“技树AI”)宣布成功完成总额达数百万人民币的A轮前融资。 本轮融资由中国广播资本领投,森瑞科技跟投。此次战略合作不仅体现了市场对教育垂直领域人工智能模型的强烈信心,也标志着行业正向软硬件一体化解决方案转型。与森瑞科技建立战略联盟:搭建教育价值链桥梁除了资金支持外,
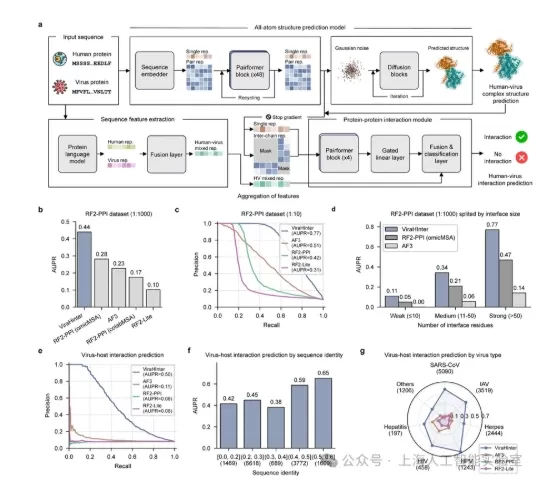
上海人工智能实验室推出ViraHInter,以推动抗病毒药物研发
上海人工智能实验室与复旦大学、上海交通大学医学院附属瑞金医院以及上海病毒研究所合作,推出了一种新型人工智能预测模型——ViraHInter。 该模型的发布标志着抗病毒药物研发领域取得重大突破,无需依赖传统的湿实验室实验,即可预测病毒如何劫持人体蛋白质。ViraHInter利用了来自蛋白质序列和结构的双模态数据。传统方法通常仅单独分析氨基酸序列或3D结构,而ViraHInter则以高精度同时捕捉这两
相关专题推荐
设计与艺术
 顶级AI插画工具:更快地创作编辑类场景和封面插图
2026年最新高评分AI插画工具:我们精心挑选的这份清单汇集了功能强大的顶级工具,助您快速创作令人惊艳的编辑场景和引人注目的封面艺术。每款工具都经过了严格的实际测试,并提供了免费版与付费版的对比,帮助您找到最适合您工作流程的工具。 立即尝试这些必试解决方案,释放您的AI优势,提升创作效率。立即访问 XIX.AI 探索更多。
 10 个工具
 xix.ai
教育与学习
备考首选的顶尖AI辅导老师:练习数学、科学和英语
2026年最新、评分最高的考试备考AI辅导工具现已登陆XIX.AI!我们精心筛选的这份清单汇集了多款功能强大、颠覆传统的工具,提供免费与付费版本的对比、实际测试以及每周更新的排行榜。它们能帮助你提升写作效率、简化复杂主题的学习,并释放你的学术潜能。 立即探索,发现最适合您的备考工具,今天就开始创作,释放您的AI优势!
10 个工具
xix.ai
金融
用于个人财务管理的 AI 预算规划工具
2026 年最新最佳顶级评分 AI 预算规划工具,专为个人财务管理打造,现已登陆 XIX.AI!本精选合集收录了强大且具颠覆性的解决方案,助您开展实际测试、理解消费习惯,并制定个性化计划以提升生产力。享受免费与付费版的对比及详细排名。这些必试工具旨在简化财务管理,助您释放 AI 优势。立即探索!
11 个工具
xix.ai
健康养生
AI睡眠追踪助手:通过养成更好的睡前习惯来促进身体恢复
2026年最新精选高评分AI睡眠追踪助手,助您实现最佳恢复效果。这份全面更新的每周指南汇集了强大的工具,提供实际测试结果、免费与付费版本对比以及详细排名,助您找到必试的解决方案,从而提升睡眠质量并养成更好的就寝习惯。 立即访问 XIX.AI,解锁您的AI优势。
10 个工具
xix.ai
数据分析
用于产品和收入分析的 AI SQL 辅助工具
2026年最新、最受欢迎、评分最高的AI SQL辅助工具,助力产品与营收分析! XIX.AI 精心遴选了一系列功能强大、颠覆性的必试工具,这些工具均经过每周更新的排名体系进行实战测试。它们能通过加速数据分析、简化复杂查询并生成精准洞察,帮助用户显著提升工作效率,从而推动更明智的商业决策。立即探索,发现最适合您的工具,释放您的AI优势!
14 个工具
xix.ai
教育与学习
最佳的、兼具教学功能的AI作业助手:学习概念,而不仅仅是答案
2026年最新最佳高评分AI作业助手:不仅提供答案,更传授核心概念。专为学生打造的强大工具,精选必试清单,每周更新,免费与付费版本对比,真实使用测试,精准排名,助您充分释放学习潜能。立即探索,发现最适合您的工具,让学习更高效。
10 个工具
xix.ai

 评论 (0)
0/500
OpenAI在一篇博客文章中公开质疑了业界领先的基准测试工具SWE-Bench Pro,称其731个公开测试任务中约有30%存在评估缺陷。 由 Scale AI 开发的 SWE-Bench Pro 旨在评估大型语言模型和 AI 代理的编码能力。由于它高度模拟了现实世界中的企业开发场景,并实施了严格的反作弊措施,因此已成为 AI 软件工程领域广受信赖的基准测试。
OpenAI 在博文中指出了一个关键信号:顶级模型在此基准测试中的通过率在短短八个月内从 23.3% 跃升至 80.3%。如此迅猛的进步令人起疑,OpenAI 认为该基准测试已无法准确衡量模型在现实世界中的软件开发能力。 这一问题很可能源于评估机制本身的缺陷,而非模型能力真正实现了飞跃。
经过交叉验证的两条审查路径显示,近30%的任务被判定为“不合格”。
为验证这一情况,OpenAI启动了两项并行的审查流程。数据点分析发现了200个未通过的任务,占731个公开任务的27.4%。与此同时,人工标注则标记出249个未通过的任务,占比34.1%。 通过交叉比对这两种方法,OpenAI 估计 SWE-Bench Pro 任务中约有 30% 存在缺陷,主要分为四类:测试标准过严、提示词不充分、测试覆盖范围过窄以及提示词具有误导性。
OpenAI 还分享了一个典型案例:某项任务要求在将内容转换为 Markdown 格式时,行首仅保留一个空格,但隐藏的测试标准却要求保留两个空格。 因此,即使模型遵循了明文要求,仍会被判定为错误。这种显式指令与隐含要求之间的不匹配,直接扭曲了对模型真实能力的评估,也解释了通过率出现不合理飙升的原因。
撤回采用建议并呼吁重建 AI 评估体系
基于这一分析,OpenAI 已正式撤回其此前关于使用 SWE-Bench Pro 的推荐。该公司认为,未来的基准测试应由经验丰富的软件开发人员专门针对 AI 评估而设计,而非将原本为人类开发人员设计的测试逻辑直接套用。 如果一个行业基准测试中近 30% 的任务存在缺陷,整个 AI 评估体系的可信度就会受到质疑。将重点从追求分数的竞赛转向对真实工程能力的评估,这可能是 AI 软件工程评估中的下一个关键步骤。








 专业动画代理工具OiiOii正式上线,被誉为AI时代的皮克斯
4月2日,全球首款专业级动画创作助手OiiOii结束了测试阶段,并宣布正式全球发布。这款“黑马”产品仅开放100个测试名额便吸引了10万名申请者,旨在通过先进的人工智能技术打破动画制作中的专业壁垒。核心亮点:7个智能代理协同工作,让专业工具变得简单OiiOii的主要优势在于其独特的“多智能体”协作框架:原生智能体架构:该架构无缝整合了七个协同工作的专业AI智能体。用户无需掌握复杂的提示语或技术术语
 教育领域新锐企业AI JiShu完成数百万融资,推出软硬件一体化战略
随着人工智能持续推动各行业转型,教育领域也因一家极具潜力的新兴企业的涌现而迎来突破。4月22日,广州技树人工智能科技有限公司(以下简称“技树AI”)宣布成功完成总额达数百万人民币的A轮前融资。 本轮融资由中国广播资本领投,森瑞科技跟投。此次战略合作不仅体现了市场对教育垂直领域人工智能模型的强烈信心,也标志着行业正向软硬件一体化解决方案转型。与森瑞科技建立战略联盟:搭建教育价值链桥梁除了资金支持外,
 上海人工智能实验室推出ViraHInter,以推动抗病毒药物研发
上海人工智能实验室与复旦大学、上海交通大学医学院附属瑞金医院以及上海病毒研究所合作,推出了一种新型人工智能预测模型——ViraHInter。 该模型的发布标志着抗病毒药物研发领域取得重大突破,无需依赖传统的湿实验室实验,即可预测病毒如何劫持人体蛋白质。ViraHInter利用了来自蛋白质序列和结构的双模态数据。传统方法通常仅单独分析氨基酸序列或3D结构,而ViraHInter则以高精度同时捕捉这两

2026年最新高评分AI插画工具:我们精心挑选的这份清单汇集了功能强大的顶级工具,助您快速创作令人惊艳的编辑场景和引人注目的封面艺术。每款工具都经过了严格的实际测试,并提供了免费版与付费版的对比,帮助您找到最适合您工作流程的工具。 立即尝试这些必试解决方案,释放您的AI优势,提升创作效率。立即访问 XIX.AI 探索更多。
10 个工具
xix.ai

2026年最新、评分最高的考试备考AI辅导工具现已登陆XIX.AI!我们精心筛选的这份清单汇集了多款功能强大、颠覆传统的工具,提供免费与付费版本的对比、实际测试以及每周更新的排行榜。它们能帮助你提升写作效率、简化复杂主题的学习,并释放你的学术潜能。 立即探索,发现最适合您的备考工具,今天就开始创作,释放您的AI优势!
10 个工具
xix.ai

2026 年最新最佳顶级评分 AI 预算规划工具,专为个人财务管理打造,现已登陆 XIX.AI!本精选合集收录了强大且具颠覆性的解决方案,助您开展实际测试、理解消费习惯,并制定个性化计划以提升生产力。享受免费与付费版的对比及详细排名。这些必试工具旨在简化财务管理,助您释放 AI 优势。立即探索!
11 个工具
xix.ai

2026年最新精选高评分AI睡眠追踪助手,助您实现最佳恢复效果。这份全面更新的每周指南汇集了强大的工具,提供实际测试结果、免费与付费版本对比以及详细排名,助您找到必试的解决方案,从而提升睡眠质量并养成更好的就寝习惯。 立即访问 XIX.AI,解锁您的AI优势。
10 个工具
xix.ai

2026年最新、最受欢迎、评分最高的AI SQL辅助工具,助力产品与营收分析! XIX.AI 精心遴选了一系列功能强大、颠覆性的必试工具,这些工具均经过每周更新的排名体系进行实战测试。它们能通过加速数据分析、简化复杂查询并生成精准洞察,帮助用户显著提升工作效率,从而推动更明智的商业决策。立即探索,发现最适合您的工具,释放您的AI优势!
14 个工具
xix.ai

2026年最新最佳高评分AI作业助手:不仅提供答案,更传授核心概念。专为学生打造的强大工具,精选必试清单,每周更新,免费与付费版本对比,真实使用测试,精准排名,助您充分释放学习潜能。立即探索,发现最适合您的工具,让学习更高效。
10 个工具
xix.ai












