


 首頁
OpenAI 抨擊 AI 基準測試:近三分之一的題目存在缺陷,通過率在 8 個月內飆升至 80%
OpenAI 在一篇部落格文章中公開質疑業界領先的基準測試 SWE-Bench Pro,聲稱其 731 項公開測試任務中,約有 30% 存在評估缺陷。 由 Scale AI 開發的 SWE-Bench Pro,旨在評估大型語言模型與 AI 代理的編碼能力。由於該基準能精準模擬真實企業開發情境,並實施嚴格的反作弊措施,因此已成為 AI 軟體工程領域廣受信賴的基準。
OpenAI 在該篇部落格文章中指出一個關鍵跡象:頂級模型在此基準測試中的通過率,僅在八個月內便從 23.3% 躍升至 80.3%。如此迅速的進步令人起疑,OpenAI 認為該基準測試已無法準確衡量模型在真實世界中的軟體開發能力。 問題很可能源於評估機制本身的缺陷,而非模型能力真正實現了飛躍。
經兩條相互驗證的審查途徑顯示,近 30% 的任務被判定為「不合格」。
為驗證此現象,OpenAI 啟動了兩項並行的審查流程。數據點分析揭露了 200 項未通過的任務,佔 731 項公開任務的 27.4%;與此同時,人工標註則標記出 249 項未通過的任務,佔比達 34.1%。 透過比對這兩種方法,OpenAI 估計約 30% 的 SWE-Bench Pro 任務存在缺陷,主要分為四類:測試過於嚴格、提示語不完善、測試覆蓋範圍過窄,以及誤導性提示語。
OpenAI 還分享了一個典型案例:某項任務要求將內容轉換為 Markdown 格式時,行首僅需一個空格,但隱藏的測試標準卻預期需有兩個空格。 結果,即使模型遵循了明示的要求,仍會被判定為錯誤。這種明示指示與隱含要求之間的不匹配,直接扭曲了對模型真實能力的評估,也解釋了通過率不合理飆升的原因。
撤回採用建議並呼籲重建 AI 評估系統
基於這項分析,OpenAI 已正式撤回先前對使用 SWE-Bench Pro 的推薦。該公司認為,未來的基準測試應由經驗豐富的軟體開發人員專門為 AI 評估而設計,而非將原本為人類開發人員設計的測試邏輯轉用於 AI 評估。 若某項產業基準測試中近 30% 的任務存在缺陷,整個 AI 評估系統的可信度便會受到質疑。將焦點從追求分數的競賽轉向對真實工程能力的評估,或許將是 AI 軟體工程評估的下一項關鍵步驟。
相關文章
 隨著人工智慧支出的增長,OpenAI 在企業市場份額上超越 Anthropic
Ramp(一家企業信用卡和費用管理平臺)釋出的最新資料顯示,OpenAI 已重新奪回超過 40% 的美國企業 AI 市場份額,超越 Anthropic。5 月份,Anthropic 的市場份額為 41%,OpenAI 為 39%;到了 7 月,Anthropic 的份額上升至近 44%,而 OpenAI 則維持在 40% 左右。Ramp 的經濟學家 Ara Kharazian 指出,自第三季度初以來,OpenAI 在該領域的增速已超過其競爭對手。該分析涵蓋超過 70,000 家美國公司,這些公司
愛普生髮布AX6協作機器人,採用緊湊設計並支援無程式碼程式設計
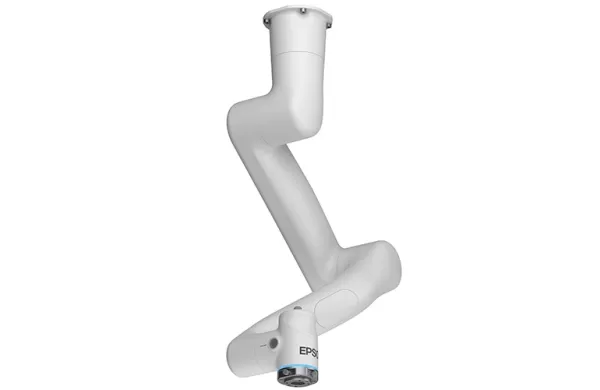
AX6力與功率受限機械臂設計輕巧且易於使用。圖片來源:愛普生愛普生機器人本週擴充套件了其六軸機器人產品線,推出了AX6協作機器人。該公司表示,這款新型協作機器人具備功率和力限制功能,在適當的風險評估下,可在無需傳統安全護欄的情況下與人協同作業。愛普生產品與機器人開發總監Rick Brookshire表示:“協作機器人透過簡化程式設計和整合,降低了眾多新使用者的使用門檻,同時實現了在空間和使用者互動至關重要的場景中應用新任務。隨著AX6的推出,愛普生現在能夠解決這些應用場景,同時為客戶提供完整的機器人安全解決
奧特曼警告,人工智慧可能被少數強大的玩家所壟斷,導致公眾被邊緣化
OpenAI 執行長山姆·奧特曼(Sam Altman)在 8 月 23 日的一集播客中表達了擔憂,指出人工智慧治理權可能集中於少數企業、模型或個人手中,這將使大多數消費者在技術如何影響其生活這方面被噤聲。他主張,最佳途徑是賦予個人實質性的控制權,讓社會與人工智慧模型得以同步演進。以自由換取安全,恐助長壟斷奧特曼指出了一個關鍵的悖論:儘管他擔心人工智慧會脫離人類的監督,但他所倡導的嚴格管控,卻可能
相關專題推薦
迅速的
 用於提升輸出質量的 AI 提示詞測試工具
2026 年最新最佳頂級 AI 提示詞測試工具,提升輸出質量!XIX.AI 精心策劃了一套強大且顛覆性的工具合集,這些工具均經過嚴格的真實世界測試,以確保始終如一的高品質結果。您將找到詳細的免費與付費對比分析、全面排名以及專家指導,幫助您識別那些能顯著提升工作效率的必試方案。立即探索,釋放您的 AI 優勢!
 11 個工具
 xix.ai
商業
用於產品定位的 AI 客戶洞察工具
2026年最前沿、最優秀、評分最高的用於產品定位的AI客戶洞察工具!XIX.AI精心挑選了一系列功能強大且具有顛覆性意義的工具,這些工具均經過實際應用測試,並會每週更新排名。它們能夠幫助您快速掌握客戶需求,從而提升寫作效率,創作出最優的SEO內容,還能高效地撰寫完美的社交媒體文案,避免浪費時間。立即探索,找到最適合您的工具,發揮您的AI優勢。
10 個工具
xix.ai
會議助理
Zoom AI 筆記記錄工具,適用於客戶通話、內部協調及決策追蹤
2026 年最新最佳 Zoom AI 筆記工具排行榜,依效能與易用性排序。XIX.AI 精心整理了一份頂級評比清單,收錄多款強大的工具,能協助您在與客戶通話時準確記錄筆記、簡化內部團隊的資訊同步,並輕鬆追蹤關鍵決策。 透過免費版與付費版的比較分析,以及實際測試結果,找出能顯著提升您工作效率的必試解決方案。立即探索!
12 個工具
xix.ai
數據分析
AI 電子表格分析工具:即時提問並獲取圖表
2026 年最新最佳頂級 AI 電子表格分析工具現已登陸 XIX.AI!本精選列表收錄了強大且具顛覆性的解決方案,讓您可直接在電子表格中提問並即時獲取精準圖表,大幅提升工作效率。我們進行真實場景測試,並提供免費與付費版的對比及每週更新的排名,助您找到最佳化資料任務的理想工具。立即探索,釋放您的 AI 優勢!
19 個工具
xix.ai
設計
適用於產品設計師的 AI 線框圖工具
2026 年最新、最受好評的 AI 線框圖工具精選,專為產品設計師打造!XIX.AI 精心彙整了一系列功能強大、顛覆業界的必試工具,這些工具皆經過嚴格的實戰測試。 您將在此找到每週更新的詳細排行榜、免費與付費版本的比較分析,以及所有關鍵資訊,助您挑選最合適的工具,提升設計效率並發揮 AI 的優勢。立即探索!
8 個工具
xix.ai
搜索引擎優化
最佳的 AI SEO 關鍵字研究工具
2026 年最新、最受好評的關鍵字研究 AI SEO 工具,盡在 XIX.AI!這份精心挑選的清單收錄了強大且能顛覆業界的工具,這些工具均經過嚴格的實際測試,以提供精確的數據。 查看免費版與付費版的比較、瀏覽詳細排名,並發掘必試選項,以強化您的內容策略並提升搜尋可見度。立即探索,找到最適合您的工具!
8 個工具
xix.ai

 評論 (0)
0/500
OpenAI 在一篇部落格文章中公開質疑業界領先的基準測試 SWE-Bench Pro,聲稱其 731 項公開測試任務中,約有 30% 存在評估缺陷。 由 Scale AI 開發的 SWE-Bench Pro,旨在評估大型語言模型與 AI 代理的編碼能力。由於該基準能精準模擬真實企業開發情境,並實施嚴格的反作弊措施,因此已成為 AI 軟體工程領域廣受信賴的基準。
OpenAI 在該篇部落格文章中指出一個關鍵跡象:頂級模型在此基準測試中的通過率,僅在八個月內便從 23.3% 躍升至 80.3%。如此迅速的進步令人起疑,OpenAI 認為該基準測試已無法準確衡量模型在真實世界中的軟體開發能力。 問題很可能源於評估機制本身的缺陷,而非模型能力真正實現了飛躍。
經兩條相互驗證的審查途徑顯示,近 30% 的任務被判定為「不合格」。
為驗證此現象,OpenAI 啟動了兩項並行的審查流程。數據點分析揭露了 200 項未通過的任務,佔 731 項公開任務的 27.4%;與此同時,人工標註則標記出 249 項未通過的任務,佔比達 34.1%。 透過比對這兩種方法,OpenAI 估計約 30% 的 SWE-Bench Pro 任務存在缺陷,主要分為四類:測試過於嚴格、提示語不完善、測試覆蓋範圍過窄,以及誤導性提示語。
OpenAI 還分享了一個典型案例:某項任務要求將內容轉換為 Markdown 格式時,行首僅需一個空格,但隱藏的測試標準卻預期需有兩個空格。 結果,即使模型遵循了明示的要求,仍會被判定為錯誤。這種明示指示與隱含要求之間的不匹配,直接扭曲了對模型真實能力的評估,也解釋了通過率不合理飆升的原因。
撤回採用建議並呼籲重建 AI 評估系統
基於這項分析,OpenAI 已正式撤回先前對使用 SWE-Bench Pro 的推薦。該公司認為,未來的基準測試應由經驗豐富的軟體開發人員專門為 AI 評估而設計,而非將原本為人類開發人員設計的測試邏輯轉用於 AI 評估。 若某項產業基準測試中近 30% 的任務存在缺陷,整個 AI 評估系統的可信度便會受到質疑。將焦點從追求分數的競賽轉向對真實工程能力的評估,或許將是 AI 軟體工程評估的下一項關鍵步驟。








 隨著人工智慧支出的增長,OpenAI 在企業市場份額上超越 Anthropic
Ramp(一家企業信用卡和費用管理平臺)釋出的最新資料顯示,OpenAI 已重新奪回超過 40% 的美國企業 AI 市場份額,超越 Anthropic。5 月份,Anthropic 的市場份額為 41%,OpenAI 為 39%;到了 7 月,Anthropic 的份額上升至近 44%,而 OpenAI 則維持在 40% 左右。Ramp 的經濟學家 Ara Kharazian 指出,自第三季度初以來,OpenAI 在該領域的增速已超過其競爭對手。該分析涵蓋超過 70,000 家美國公司,這些公司
 愛普生髮布AX6協作機器人,採用緊湊設計並支援無程式碼程式設計
AX6力與功率受限機械臂設計輕巧且易於使用。圖片來源:愛普生愛普生機器人本週擴充套件了其六軸機器人產品線,推出了AX6協作機器人。該公司表示,這款新型協作機器人具備功率和力限制功能,在適當的風險評估下,可在無需傳統安全護欄的情況下與人協同作業。愛普生產品與機器人開發總監Rick Brookshire表示:“協作機器人透過簡化程式設計和整合,降低了眾多新使用者的使用門檻,同時實現了在空間和使用者互動至關重要的場景中應用新任務。隨著AX6的推出,愛普生現在能夠解決這些應用場景,同時為客戶提供完整的機器人安全解決
 奧特曼警告,人工智慧可能被少數強大的玩家所壟斷,導致公眾被邊緣化
OpenAI 執行長山姆·奧特曼(Sam Altman)在 8 月 23 日的一集播客中表達了擔憂,指出人工智慧治理權可能集中於少數企業、模型或個人手中,這將使大多數消費者在技術如何影響其生活這方面被噤聲。他主張,最佳途徑是賦予個人實質性的控制權,讓社會與人工智慧模型得以同步演進。以自由換取安全,恐助長壟斷奧特曼指出了一個關鍵的悖論:儘管他擔心人工智慧會脫離人類的監督,但他所倡導的嚴格管控,卻可能
2026 年最新最佳頂級 AI 提示詞測試工具,提升輸出質量!XIX.AI 精心策劃了一套強大且顛覆性的工具合集,這些工具均經過嚴格的真實世界測試,以確保始終如一的高品質結果。您將找到詳細的免費與付費對比分析、全面排名以及專家指導,幫助您識別那些能顯著提升工作效率的必試方案。立即探索,釋放您的 AI 優勢!
11 個工具
xix.ai
2026年最前沿、最優秀、評分最高的用於產品定位的AI客戶洞察工具!XIX.AI精心挑選了一系列功能強大且具有顛覆性意義的工具,這些工具均經過實際應用測試,並會每週更新排名。它們能夠幫助您快速掌握客戶需求,從而提升寫作效率,創作出最優的SEO內容,還能高效地撰寫完美的社交媒體文案,避免浪費時間。立即探索,找到最適合您的工具,發揮您的AI優勢。
10 個工具
xix.ai
2026 年最新最佳 Zoom AI 筆記工具排行榜,依效能與易用性排序。XIX.AI 精心整理了一份頂級評比清單,收錄多款強大的工具,能協助您在與客戶通話時準確記錄筆記、簡化內部團隊的資訊同步,並輕鬆追蹤關鍵決策。 透過免費版與付費版的比較分析,以及實際測試結果,找出能顯著提升您工作效率的必試解決方案。立即探索!
12 個工具
xix.ai
2026 年最新最佳頂級 AI 電子表格分析工具現已登陸 XIX.AI!本精選列表收錄了強大且具顛覆性的解決方案,讓您可直接在電子表格中提問並即時獲取精準圖表,大幅提升工作效率。我們進行真實場景測試,並提供免費與付費版的對比及每週更新的排名,助您找到最佳化資料任務的理想工具。立即探索,釋放您的 AI 優勢!
19 個工具
xix.ai
2026 年最新、最受好評的 AI 線框圖工具精選,專為產品設計師打造!XIX.AI 精心彙整了一系列功能強大、顛覆業界的必試工具,這些工具皆經過嚴格的實戰測試。 您將在此找到每週更新的詳細排行榜、免費與付費版本的比較分析,以及所有關鍵資訊,助您挑選最合適的工具,提升設計效率並發揮 AI 的優勢。立即探索!
8 個工具
xix.ai
2026 年最新、最受好評的關鍵字研究 AI SEO 工具,盡在 XIX.AI!這份精心挑選的清單收錄了強大且能顛覆業界的工具,這些工具均經過嚴格的實際測試,以提供精確的數據。 查看免費版與付費版的比較、瀏覽詳細排名,並發掘必試選項,以強化您的內容策略並提升搜尋可見度。立即探索,找到最適合您的工具!
8 個工具
xix.ai












