


 家
OpenAIがAIベンチマークを痛烈に批判:問題の3分の1近くが不備、合格率は8ヶ月で80%に急上昇
OpenAIはブログ記事の中で、業界をリードするベンチマークである「SWE-Bench Pro」に公然と異議を唱え、その731の公開テストタスクのうち約30%に評価上の欠陥があると主張した。 Scale AIによって開発されたSWE-Bench Proは、大規模言語モデルやAIエージェントのコーディング能力を評価するために設計されている。実世界の企業開発を忠実に再現し、厳格な不正防止策を講じていることから、AIソフトウェアエンジニアリング分野において広く信頼されているベンチマークとなっている。
OpenAIはブログ記事の中で、重要な兆候として、このベンチマークにおけるトップクラスのモデルの合格率が、わずか8ヶ月で23.3%から80.3%へと急上昇したことを指摘している。このような急速な進歩は不審であり、OpenAIは、このベンチマークではもはやモデルの実世界におけるソフトウェア開発スキルを正確に測定できないと主張している。 この問題は、モデルの能力における真の飛躍ではなく、評価方法そのものの欠陥に起因している可能性が高い。
相互検証された2つのレビュー経路により、タスクの30%近くが「不適格」と判定されたことが明らかになった。
これを検証するため、OpenAIは2つの並行したレビュープロセスを開始した。データポイント分析では、731件の公開タスクのうち200件(27.4%)が不合格と判明した。一方、手動によるアノテーションでは、249件(34.1%)のタスクが不合格と判定された。 両手法を照合した結果、OpenAIはSWE-Bench Proのタスクの約30%に欠陥が含まれていると推定しており、それらは「過度に厳格なテスト」「不適切なプロンプト」「テストカバレッジの狭さ」「誤解を招くプロンプト」という4つのカテゴリーに分類される。
OpenAIは典型的な例も紹介している。あるタスクでは、コンテンツをMarkdownに変換する際に行の先頭にスペースを1つ入れるよう求められていたが、隠れたテスト要件ではスペースを2つ入れることが想定されていた。 その結果、モデルが明示された要件に従ったとしても、不正解と判定されてしまう。このような明示的な指示と隠れた要件との不一致は、モデルの真の実力の評価を直接歪め、合格率の不合理な急上昇を説明している。
採用推奨の撤回とAI評価システムの再構築を求める声
この分析に基づき、OpenAIはSWE-Bench Proの使用を推奨していた以前の勧告を正式に撤回した。同社は、将来のベンチマークは、人間の開発者向けに設計されたテストロジックを流用するのではなく、経験豊富なソフトウェア開発者がAI評価専用に作成すべきであると考えている。 業界標準のベンチマークのタスクの30%近くが欠陥を抱えている場合、AI評価システム全体の信頼性が疑問視されることになる。スコア追求型のコンテストから、真のエンジニアリング能力の評価へと焦点を移すことが、AIソフトウェアエンジニアリング評価における次の重要な一歩となるかもしれない。
関連記事
 アリペイ、AIウォレットエージェントと3つの新回収機能を発表
バンド・カンファレンスにおいて、アリペイは、AI決済が「支払可能」から「信頼できる」ものへと移行しつつあると発表した。一方で、アリペイは、ユーザーがAI決済のあらゆる取引を管理できるよう支援するAIウォレットエージェントを立ち上げる。 他方、AI決済製品システムのアップグレードを継続し、「Vibe Pay」「Skill Pay」「Machine Pay」という3つの新たな「AI受取」機能を導入する
Alibaba Cloud DAMO Academyの肝臓がんAIモデルが『Nature Medicine』に掲載
肝がん診断用AIモデル「DAMO LiON」は、アリババDAMOアカデミーが中国医科大学盛京病院などの機関と共同で開発したもので、最近、国際的な医学雑誌『Nature Medicine』のトップジャーナルに掲載されました。このモデルは、強化CT画像を通じて小さな肝臓病変を識別することができ、特に見落としやすい肝転移などの病変を特定します。2ヶ月間の現実的な前向き臨床試験において、DAMO LiONは1万人以上の患者の画像読影を支援し、以前見逃されていた15個の悪性腫瘍を特定しました。これらの病
華為の「秦雲」がHarmonyOSと大規模言語モデルを統合した教育AIソリューションを発表
華為の「Harmony Education AI サミット」初回開催において、華為とそのエコシステムパートナーは、包括的な教育AI戦略と全シナリオ対応キャンパスソリューションを同時に発表しました。この取り組みは、分散型技術と大規模言語モデル(LLM)を基盤とした、教育のデジタルトランスフォーメーションにおける重要な段階を示すものです。中核技術:HarmonyOSの分散型能力とAIモデルの融合更新されたソリューションは、HarmonyOSの分散型アーキテクチャを活用し、デバイス間のハードウェア
関連特集おすすめ
デザインとアート
 おすすめのAIイラスト作成ツール:編集用シーンや表紙アートを素早く作成
2026年最新・高評価のAIイラストレーションツール:当サイトが厳選したこのリストには、見事な編集用シーンや人目を引く表紙アートを素早く作成できる、高性能なツールが掲載されています。各ツールは実環境での厳格なテストを経ており、無料版と有料版の比較も掲載されているため、ご自身のワークフローに最適なツールを見つけるのに役立ちます。 今すぐこれらの「必見」ソリューションを試して、AIの力を最大限に活用し、クリエイティブな生産性を高めましょう。XIX.AIで今すぐチェックしてください。
 10 ツール
 xix.ai
教育と学習
試験対策に最適なAIチューター:数学、理科、英語の練習
2026年最新の、試験対策で高評価を得ている最高のAIチューターがXIX.AIに登場!厳選されたこのリストには、無料版と有料版の比較、実戦的なテスト、毎週更新されるランキングなどを提供する、画期的なツールが勢ぞろいしています。これらは、ライティングの効率を高め、複雑なトピックの学習を簡素化し、あなたの学業的な可能性を引き出すのに役立ちます。 今すぐチェックして、あなたにぴったりの試験対策ツールを見つけ、今日から作成を始めて、AIの力を最大限に活用しましょう!
10 ツール
xix.ai
ファイナンス
個人のお金管理のためのAI予算計画ツール
2026年の最新・最高評価のAI予算管理ツールがXIX.AIで登場!この厳選コレクションは、現実的なテストを行い、支出習慣を理解し、生産性を高めるためのパーソナライズされた計画を作成するのに役立つ革新的なソリューションを提供しています。無料版と有料版の比較や詳細なランキングもご用意しています。お金の管理を簡素化し、AIの優位性を引き出すためにぜひ試してほしいツールです。今すぐチェックしましょう!
11 ツール
xix.ai
健康とウェルネス
AI睡眠追跡アシスタント:より良い就寝習慣で回復力を高める
2026年最新かつ最高評価を受けているAI睡眠追跡アシスタントを厳選し、最適な回復を実現できるようご紹介します。完全に更新されたこの週間ガイドには、実際のテスト結果や無料版と有料版の比較、詳細なランキングなど、睡眠の質を向上させてより良い就寝習慣をサポートする最適なソリューションを見つけるのに役立つ強力なツールが掲載されています。今すぐXIX.AIでご覧ください。
10 ツール
xix.ai
データ分析
製品および収益分析のためのAI SQLコパイロット
2026年版 製品・収益分析に最適な、高評価のAI SQLコパイロット最新ランキング! XIX.AIは、毎週更新されるランキングを通じて実環境でのテストを経た、強力で画期的な「ぜひ試すべきツール」を厳選しました。これらのツールは、データ分析を加速させ、複雑なクエリを効率化し、正確なインサイトを生成することで、ユーザーの生産性を大幅に向上させ、より賢明なビジネス意思決定を後押しします。今すぐチェックして、AIの真価を引き出すあなたにぴったりのツールを見つけましょう!
14 ツール
xix.ai
教育と学習
学びを促進する最高のAI宿題支援ツール:答えだけでなく、概念を学べる
2026年最新・最高評価のAI宿題サポートツール。単なる答えだけでなく、核心となる概念を教える、学生にとって強力なツール。ぜひ試してほしい厳選リスト。毎週更新。無料版と有料版の比較、実地テストによる正確なランキングで、あなたの学習能力を最大限に引き出します。今すぐチェックして、よりスマートな学習を実現するあなたにぴったりのツールを見つけましょう。
10 ツール
xix.ai

 コメント (0)
0/500
OpenAIはブログ記事の中で、業界をリードするベンチマークである「SWE-Bench Pro」に公然と異議を唱え、その731の公開テストタスクのうち約30%に評価上の欠陥があると主張した。 Scale AIによって開発されたSWE-Bench Proは、大規模言語モデルやAIエージェントのコーディング能力を評価するために設計されている。実世界の企業開発を忠実に再現し、厳格な不正防止策を講じていることから、AIソフトウェアエンジニアリング分野において広く信頼されているベンチマークとなっている。
OpenAIはブログ記事の中で、重要な兆候として、このベンチマークにおけるトップクラスのモデルの合格率が、わずか8ヶ月で23.3%から80.3%へと急上昇したことを指摘している。このような急速な進歩は不審であり、OpenAIは、このベンチマークではもはやモデルの実世界におけるソフトウェア開発スキルを正確に測定できないと主張している。 この問題は、モデルの能力における真の飛躍ではなく、評価方法そのものの欠陥に起因している可能性が高い。
相互検証された2つのレビュー経路により、タスクの30%近くが「不適格」と判定されたことが明らかになった。
これを検証するため、OpenAIは2つの並行したレビュープロセスを開始した。データポイント分析では、731件の公開タスクのうち200件(27.4%)が不合格と判明した。一方、手動によるアノテーションでは、249件(34.1%)のタスクが不合格と判定された。 両手法を照合した結果、OpenAIはSWE-Bench Proのタスクの約30%に欠陥が含まれていると推定しており、それらは「過度に厳格なテスト」「不適切なプロンプト」「テストカバレッジの狭さ」「誤解を招くプロンプト」という4つのカテゴリーに分類される。
OpenAIは典型的な例も紹介している。あるタスクでは、コンテンツをMarkdownに変換する際に行の先頭にスペースを1つ入れるよう求められていたが、隠れたテスト要件ではスペースを2つ入れることが想定されていた。 その結果、モデルが明示された要件に従ったとしても、不正解と判定されてしまう。このような明示的な指示と隠れた要件との不一致は、モデルの真の実力の評価を直接歪め、合格率の不合理な急上昇を説明している。
採用推奨の撤回とAI評価システムの再構築を求める声
この分析に基づき、OpenAIはSWE-Bench Proの使用を推奨していた以前の勧告を正式に撤回した。同社は、将来のベンチマークは、人間の開発者向けに設計されたテストロジックを流用するのではなく、経験豊富なソフトウェア開発者がAI評価専用に作成すべきであると考えている。 業界標準のベンチマークのタスクの30%近くが欠陥を抱えている場合、AI評価システム全体の信頼性が疑問視されることになる。スコア追求型のコンテストから、真のエンジニアリング能力の評価へと焦点を移すことが、AIソフトウェアエンジニアリング評価における次の重要な一歩となるかもしれない。








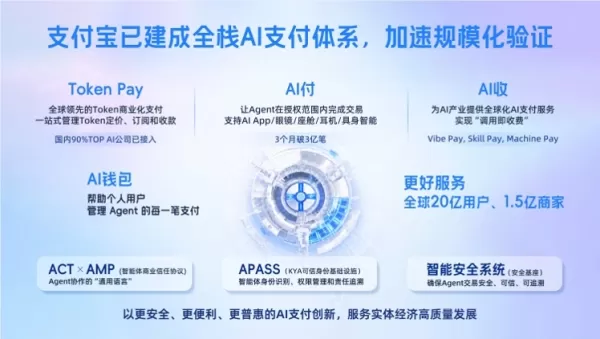 アリペイ、AIウォレットエージェントと3つの新回収機能を発表
バンド・カンファレンスにおいて、アリペイは、AI決済が「支払可能」から「信頼できる」ものへと移行しつつあると発表した。一方で、アリペイは、ユーザーがAI決済のあらゆる取引を管理できるよう支援するAIウォレットエージェントを立ち上げる。 他方、AI決済製品システムのアップグレードを継続し、「Vibe Pay」「Skill Pay」「Machine Pay」という3つの新たな「AI受取」機能を導入する
 Alibaba Cloud DAMO Academyの肝臓がんAIモデルが『Nature Medicine』に掲載
肝がん診断用AIモデル「DAMO LiON」は、アリババDAMOアカデミーが中国医科大学盛京病院などの機関と共同で開発したもので、最近、国際的な医学雑誌『Nature Medicine』のトップジャーナルに掲載されました。このモデルは、強化CT画像を通じて小さな肝臓病変を識別することができ、特に見落としやすい肝転移などの病変を特定します。2ヶ月間の現実的な前向き臨床試験において、DAMO LiONは1万人以上の患者の画像読影を支援し、以前見逃されていた15個の悪性腫瘍を特定しました。これらの病
 華為の「秦雲」がHarmonyOSと大規模言語モデルを統合した教育AIソリューションを発表
華為の「Harmony Education AI サミット」初回開催において、華為とそのエコシステムパートナーは、包括的な教育AI戦略と全シナリオ対応キャンパスソリューションを同時に発表しました。この取り組みは、分散型技術と大規模言語モデル(LLM)を基盤とした、教育のデジタルトランスフォーメーションにおける重要な段階を示すものです。中核技術:HarmonyOSの分散型能力とAIモデルの融合更新されたソリューションは、HarmonyOSの分散型アーキテクチャを活用し、デバイス間のハードウェア

2026年最新・高評価のAIイラストレーションツール:当サイトが厳選したこのリストには、見事な編集用シーンや人目を引く表紙アートを素早く作成できる、高性能なツールが掲載されています。各ツールは実環境での厳格なテストを経ており、無料版と有料版の比較も掲載されているため、ご自身のワークフローに最適なツールを見つけるのに役立ちます。 今すぐこれらの「必見」ソリューションを試して、AIの力を最大限に活用し、クリエイティブな生産性を高めましょう。XIX.AIで今すぐチェックしてください。
10 ツール
xix.ai

2026年最新の、試験対策で高評価を得ている最高のAIチューターがXIX.AIに登場!厳選されたこのリストには、無料版と有料版の比較、実戦的なテスト、毎週更新されるランキングなどを提供する、画期的なツールが勢ぞろいしています。これらは、ライティングの効率を高め、複雑なトピックの学習を簡素化し、あなたの学業的な可能性を引き出すのに役立ちます。 今すぐチェックして、あなたにぴったりの試験対策ツールを見つけ、今日から作成を始めて、AIの力を最大限に活用しましょう!
10 ツール
xix.ai

2026年の最新・最高評価のAI予算管理ツールがXIX.AIで登場!この厳選コレクションは、現実的なテストを行い、支出習慣を理解し、生産性を高めるためのパーソナライズされた計画を作成するのに役立つ革新的なソリューションを提供しています。無料版と有料版の比較や詳細なランキングもご用意しています。お金の管理を簡素化し、AIの優位性を引き出すためにぜひ試してほしいツールです。今すぐチェックしましょう!
11 ツール
xix.ai

2026年最新かつ最高評価を受けているAI睡眠追跡アシスタントを厳選し、最適な回復を実現できるようご紹介します。完全に更新されたこの週間ガイドには、実際のテスト結果や無料版と有料版の比較、詳細なランキングなど、睡眠の質を向上させてより良い就寝習慣をサポートする最適なソリューションを見つけるのに役立つ強力なツールが掲載されています。今すぐXIX.AIでご覧ください。
10 ツール
xix.ai

2026年版 製品・収益分析に最適な、高評価のAI SQLコパイロット最新ランキング! XIX.AIは、毎週更新されるランキングを通じて実環境でのテストを経た、強力で画期的な「ぜひ試すべきツール」を厳選しました。これらのツールは、データ分析を加速させ、複雑なクエリを効率化し、正確なインサイトを生成することで、ユーザーの生産性を大幅に向上させ、より賢明なビジネス意思決定を後押しします。今すぐチェックして、AIの真価を引き出すあなたにぴったりのツールを見つけましょう!
14 ツール
xix.ai

2026年最新・最高評価のAI宿題サポートツール。単なる答えだけでなく、核心となる概念を教える、学生にとって強力なツール。ぜひ試してほしい厳選リスト。毎週更新。無料版と有料版の比較、実地テストによる正確なランキングで、あなたの学習能力を最大限に引き出します。今すぐチェックして、よりスマートな学習を実現するあなたにぴったりのツールを見つけましょう。
10 ツール
xix.ai












