


 首页
OpenAI 成立数学与人工智能顾问小组;神秘模型在24天内解决100个世界级难题
9月22日,OpenAI 宣布成立“数学与人工智能咨询小组”。该独立机构总部位于普林斯顿高等研究院,由九位数学家组成,其运作独立于 OpenAI。
更为引人注目的是,OpenAI 透露,自 8 月 28 日起进行训练的一个神秘模型,已成功解决了涵盖多个数学领域的 100 多个长期未决的开放性问题,其中包括备受争议的纳维-斯托克斯千年大奖问题。
数学家们对这一快速进展表示震惊,引发了关于学术披露方式的内部辩论
OpenAI 指出,该模型在数学领域的进展令其内部团队感到惊讶,从而促使团队讨论向更广泛的学术界通报这一进展的最适当方式。
OpenAI 认识到数学是一门基础科学,并承认人工智能驱动的发现可能具有广泛的应用前景。因此,该公司在开发和部署这些能力时采取了谨慎的态度,目前正在探索更广泛的实施策略。
此前,特里·陶(Terence Tao)、邓宇(Yu Deng)、彼得·舒尔策(Peter Scholze)等著名数学家发表了一封公开信,对将解决开放数学问题作为新人工智能系统的基准表示担忧。OpenAI 表示,这些观点凸显了与数学界进行更充分互动的必要性。
咨询小组包括三位菲尔兹奖得主,且不接受 OpenAI 的薪酬
OpenAI 澄清称,该咨询小组独立运作,保留提供未经请求的建议、公开评论 OpenAI 对数学领域的影响以及独立调整其成员组成的权利。成员不领取薪酬,但该小组不影响 OpenAI 内部数学研究的进度。
创始成员包括:弗朗索瓦·查尔斯(École Normale Supérieure, ENS-PSL)、卡米洛·德·莱利斯(高等研究院、大萨索科学研究所)、蒂莫西·高尔斯(法兰西公学院、剑桥大学)、马丁·海雷尔(洛桑联邦理工学院、伦敦帝国理工学院)、尼基尔·斯里瓦斯塔瓦(伯克利大学、西蒙斯研究所)、乌尔里希·蒂尔曼(牛津大学、INI)、拉维·瓦克尔(斯坦福大学)、爱德华·威滕(高等研究院)和梅兰妮·马切特·伍德(哈佛大学)。其中,高尔斯、海雷尔和威滕是菲尔兹奖得主;卡米洛·德·莱利斯也是上述公开信的签署人之一。
该咨询小组将就新兴成果的审查与传播提供建议,协助 OpenAI 评估研究成果的重要性,并对数学研究的学术标准提供意见。此外,该小组还将推荐 OpenAI 的工具如何能更好地支持数学研究与教育。
相关文章
 Anthropic 确认 Claude 账户遭黑客攻击,用户失去访问权限
多位 Claude 用户近日在社交媒体上报告称,他们的账户配额在没有进行任何主动使用的情况下被迅速耗尽。Anthropic 的调查结果显示,黑客通过窃取登录会话的方式非法获取了用户账户的访问权限,随后利用受害者的宝贵调用配额进行恶意操作。此次漏洞首先由位于英国东萨塞克斯郡的独立 AI 顾问 Grant D'Arcy 于 8 月 4 日发现。尽管他并未进行活跃工作,但其 Claude Max 20x 账户的使用量仍在持续上升。第二天,他禁用了所有与 Claude 连接的工具,暂停了计划任务和云执
Senspeech X2.5 双星:首个在端侧实现百万级 Token 上下文,完全使用国产算力训练
9月1日,科大讯飞全资子公司思元星火正式推出并开源两款端侧通用大模型:星火X2.5-4B和星火X2.5-1.7B。这两款模型是业界首批原生支持高达100万Token上下文长度的模型,并完全开放模型权重、代码仓库及部署文档。百万级上下文支持,小模型也能“读完一本书”两款模型均采用混合注意力架构,针对智能体、代码、数学及指令遵循等核心能力进行了优化,在同类规模的行业级开源模型中展现出领先的综合性能。在上下文能力方面,星火X2.5-4B和星火X2.5-1.7B基于万亿级Token的高质量数据进行了训练
Meitun LongCat 推出 LoHoSearch,而 BrowseComp 的得分已跌至 30% 以下
过去一年中,搜索智能体(Search Agent)的能力在很大程度上由 BrowseComp 基准测试所定义。然而,该基准测试正逐渐失去其相关性——它在短短十个月内将模型性能从 30% 提升至 90%,但其价值正在迅速衰减。7 月 17 日,美团旗下 LongCat 推出了更为严格的评估标准 LoHoSearch,旨在重新激发搜索智能体开发领域的实质性进展。LoHoSearch 的挑战并非人工构建,而是从包含 762 万个实体的维基百科知识图谱中自动生成。由于这些任务是机器生成的,它们达到了人类
相关专题推荐
写作
 适用于商务写作的AI改写工具:让晦涩难懂的文案更清晰
2026年最新、最佳、评分最高的商务写作AI改写工具现已登陆XIX.AI!这份精心筛选的清单汇集了功能强大、具有颠覆性的工具,它们均经过实际测试,能够让晦涩难懂的文案更清晰易懂,并显著提升写作效率。 获取免费版与付费版的对比指南,了解哪种选项更适合您的需求。立即探索,发现最适合您的工具,并在商务沟通中释放AI带来的竞争优势。
 13 个工具
 xix.ai
音乐创作
用于生成歌词与旋律构思的 AI 歌曲创作工具
2026年最新、最优秀、评分最高的用于生成歌词与旋律灵感的AI作曲工具现已在XIX.AI上亮相!这份精心挑选的合集汇集了诸多功能强大且具有颠覆性意义的工具,它们均经过严格的实际应用测试,能够提供精准的歌词与旋律建议。您可以查看免费版本与付费版本的对比信息、详细的排名数据,还能发现那些能显著提升您创作效率的必备工具。立即探索,找到最适合您需求的方案吧!
8 个工具
xix.ai
健康养生
ChatGPT 膳食规划应用:用于营养素追踪、购物清单和每周备餐
2026年最新最佳ChatGPT膳食规划应用:经过精心筛选、广受好评、必试的强大工具,可帮助您追踪营养素摄入、管理购物清单并进行每周备餐,彻底改变您的饮食规划方式。XIX.AI基于实际测试结果提供每周更新的排行榜,其中包含免费版与付费版的详细对比信息。立即发现最适合您的工具,提升工作效率,释放AI带来的竞争优势。立即探索!
9 个工具
xix.ai
视频创作
适用于短视频内容的AI视频脚本工具
2026年最新、最佳、评分最高的短视频AI脚本工具!XIX.AI精心甄选了一系列功能强大、颠覆行业的必试工具,这些工具均经过严格的实际测试。 您将看到每周更新的详细排行榜、免费与付费版本的对比信息,以及有助于提升工作效率、在创作高质量短视频内容时发挥AI优势的深度解析。立即探索,找到最适合您的工具!
10 个工具
xix.ai
漫画创作
适用于分镜式叙事的AI漫画分镜工具
2026年最新最佳AI漫画分镜工具,专为分镜式叙事打造!这份精心精选的高评分合集汇集了功能强大、颠覆传统的解决方案,可帮助创作者提升写作效率并突破创作瓶颈。 您将在此找到详尽的免费版与付费版对比分析、实际测试结果以及官方排名,助您做出明智选择。XIX.AI 还提供了专家见解。立即探索,发现能将生动故事呈现得栩栩如生的完美工具!238 个字符
9 个工具
xix.ai
视频创作
最佳用于短视频内容的AI视频生成工具
2026 年最新、最佳、最受好评的 AI 短视频生成工具已上线,收录于 XIX.AI 精选合集。这些强大的变革性工具经过严格的真实世界测试,提供全面的免费与付费对比及详细排名,助您找到完美选项。无论您需要快速制作高质量短视频,还是提升各项任务的生产力,这些必试方案均能带来卓越成果。立即探索,发现您的理想工具,释放 AI 优势。
9 个工具
xix.ai

 评论 (0)
0/500
9月22日,OpenAI 宣布成立“数学与人工智能咨询小组”。该独立机构总部位于普林斯顿高等研究院,由九位数学家组成,其运作独立于 OpenAI。
更为引人注目的是,OpenAI 透露,自 8 月 28 日起进行训练的一个神秘模型,已成功解决了涵盖多个数学领域的 100 多个长期未决的开放性问题,其中包括备受争议的纳维-斯托克斯千年大奖问题。
数学家们对这一快速进展表示震惊,引发了关于学术披露方式的内部辩论
OpenAI 指出,该模型在数学领域的进展令其内部团队感到惊讶,从而促使团队讨论向更广泛的学术界通报这一进展的最适当方式。
OpenAI 认识到数学是一门基础科学,并承认人工智能驱动的发现可能具有广泛的应用前景。因此,该公司在开发和部署这些能力时采取了谨慎的态度,目前正在探索更广泛的实施策略。
此前,特里·陶(Terence Tao)、邓宇(Yu Deng)、彼得·舒尔策(Peter Scholze)等著名数学家发表了一封公开信,对将解决开放数学问题作为新人工智能系统的基准表示担忧。OpenAI 表示,这些观点凸显了与数学界进行更充分互动的必要性。
咨询小组包括三位菲尔兹奖得主,且不接受 OpenAI 的薪酬
OpenAI 澄清称,该咨询小组独立运作,保留提供未经请求的建议、公开评论 OpenAI 对数学领域的影响以及独立调整其成员组成的权利。成员不领取薪酬,但该小组不影响 OpenAI 内部数学研究的进度。
创始成员包括:弗朗索瓦·查尔斯(École Normale Supérieure, ENS-PSL)、卡米洛·德·莱利斯(高等研究院、大萨索科学研究所)、蒂莫西·高尔斯(法兰西公学院、剑桥大学)、马丁·海雷尔(洛桑联邦理工学院、伦敦帝国理工学院)、尼基尔·斯里瓦斯塔瓦(伯克利大学、西蒙斯研究所)、乌尔里希·蒂尔曼(牛津大学、INI)、拉维·瓦克尔(斯坦福大学)、爱德华·威滕(高等研究院)和梅兰妮·马切特·伍德(哈佛大学)。其中,高尔斯、海雷尔和威滕是菲尔兹奖得主;卡米洛·德·莱利斯也是上述公开信的签署人之一。
该咨询小组将就新兴成果的审查与传播提供建议,协助 OpenAI 评估研究成果的重要性,并对数学研究的学术标准提供意见。此外,该小组还将推荐 OpenAI 的工具如何能更好地支持数学研究与教育。








 Anthropic 确认 Claude 账户遭黑客攻击,用户失去访问权限
多位 Claude 用户近日在社交媒体上报告称,他们的账户配额在没有进行任何主动使用的情况下被迅速耗尽。Anthropic 的调查结果显示,黑客通过窃取登录会话的方式非法获取了用户账户的访问权限,随后利用受害者的宝贵调用配额进行恶意操作。此次漏洞首先由位于英国东萨塞克斯郡的独立 AI 顾问 Grant D'Arcy 于 8 月 4 日发现。尽管他并未进行活跃工作,但其 Claude Max 20x 账户的使用量仍在持续上升。第二天,他禁用了所有与 Claude 连接的工具,暂停了计划任务和云执
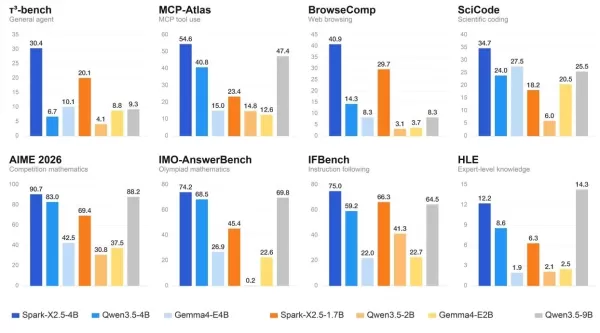 Senspeech X2.5 双星:首个在端侧实现百万级 Token 上下文,完全使用国产算力训练
9月1日,科大讯飞全资子公司思元星火正式推出并开源两款端侧通用大模型:星火X2.5-4B和星火X2.5-1.7B。这两款模型是业界首批原生支持高达100万Token上下文长度的模型,并完全开放模型权重、代码仓库及部署文档。百万级上下文支持,小模型也能“读完一本书”两款模型均采用混合注意力架构,针对智能体、代码、数学及指令遵循等核心能力进行了优化,在同类规模的行业级开源模型中展现出领先的综合性能。在上下文能力方面,星火X2.5-4B和星火X2.5-1.7B基于万亿级Token的高质量数据进行了训练
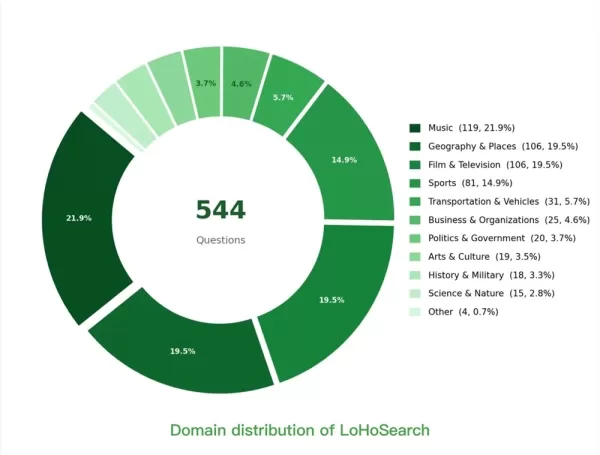 Meitun LongCat 推出 LoHoSearch,而 BrowseComp 的得分已跌至 30% 以下
过去一年中,搜索智能体(Search Agent)的能力在很大程度上由 BrowseComp 基准测试所定义。然而,该基准测试正逐渐失去其相关性——它在短短十个月内将模型性能从 30% 提升至 90%,但其价值正在迅速衰减。7 月 17 日,美团旗下 LongCat 推出了更为严格的评估标准 LoHoSearch,旨在重新激发搜索智能体开发领域的实质性进展。LoHoSearch 的挑战并非人工构建,而是从包含 762 万个实体的维基百科知识图谱中自动生成。由于这些任务是机器生成的,它们达到了人类
2026年最新、最佳、评分最高的商务写作AI改写工具现已登陆XIX.AI!这份精心筛选的清单汇集了功能强大、具有颠覆性的工具,它们均经过实际测试,能够让晦涩难懂的文案更清晰易懂,并显著提升写作效率。 获取免费版与付费版的对比指南,了解哪种选项更适合您的需求。立即探索,发现最适合您的工具,并在商务沟通中释放AI带来的竞争优势。
13 个工具
xix.ai
2026年最新、最优秀、评分最高的用于生成歌词与旋律灵感的AI作曲工具现已在XIX.AI上亮相!这份精心挑选的合集汇集了诸多功能强大且具有颠覆性意义的工具,它们均经过严格的实际应用测试,能够提供精准的歌词与旋律建议。您可以查看免费版本与付费版本的对比信息、详细的排名数据,还能发现那些能显著提升您创作效率的必备工具。立即探索,找到最适合您需求的方案吧!
8 个工具
xix.ai
2026年最新最佳ChatGPT膳食规划应用:经过精心筛选、广受好评、必试的强大工具,可帮助您追踪营养素摄入、管理购物清单并进行每周备餐,彻底改变您的饮食规划方式。XIX.AI基于实际测试结果提供每周更新的排行榜,其中包含免费版与付费版的详细对比信息。立即发现最适合您的工具,提升工作效率,释放AI带来的竞争优势。立即探索!
9 个工具
xix.ai
2026年最新、最佳、评分最高的短视频AI脚本工具!XIX.AI精心甄选了一系列功能强大、颠覆行业的必试工具,这些工具均经过严格的实际测试。 您将看到每周更新的详细排行榜、免费与付费版本的对比信息,以及有助于提升工作效率、在创作高质量短视频内容时发挥AI优势的深度解析。立即探索,找到最适合您的工具!
10 个工具
xix.ai
2026年最新最佳AI漫画分镜工具,专为分镜式叙事打造!这份精心精选的高评分合集汇集了功能强大、颠覆传统的解决方案,可帮助创作者提升写作效率并突破创作瓶颈。 您将在此找到详尽的免费版与付费版对比分析、实际测试结果以及官方排名,助您做出明智选择。XIX.AI 还提供了专家见解。立即探索,发现能将生动故事呈现得栩栩如生的完美工具!238 个字符
9 个工具
xix.ai
2026 年最新、最佳、最受好评的 AI 短视频生成工具已上线,收录于 XIX.AI 精选合集。这些强大的变革性工具经过严格的真实世界测试,提供全面的免费与付费对比及详细排名,助您找到完美选项。无论您需要快速制作高质量短视频,还是提升各项任务的生产力,这些必试方案均能带来卓越成果。立即探索,发现您的理想工具,释放 AI 优势。
9 个工具
xix.ai












