


 首页
MiniMax的M3旗舰机型及其指示器令人印象深刻,但也引发了褒贬不一的争议
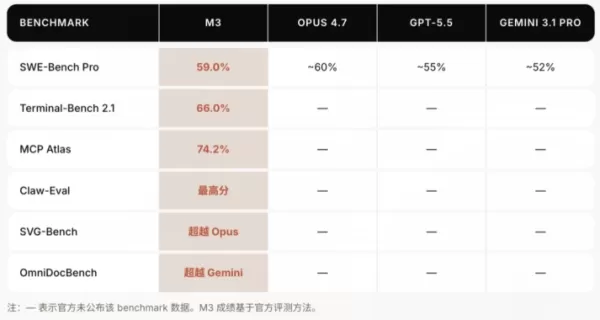
大型语言模型的竞争持续白热化,人工智能初创公司MiniMax近日发布了其新款旗舰模型M3。根据技术报告中的基准测试结果,该模型表现令人印象深刻:在模拟真实世界软件工程任务的测试中得分达到59%,超越了GPT-5.5,并接近Opus4.7的水平。 该模型还具备百万令牌级上下文处理能力和原生多模态能力。然而,尽管取得了这些显著的技术成就,此次发布仍引发了开发者社区的强烈反响,尤其在中国网络论坛上出现了尖锐的批评声浪。
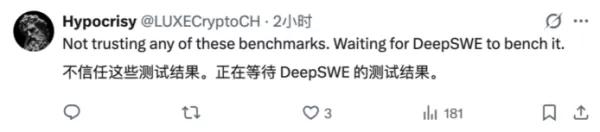
质疑的主要焦点集中在评估方法上。 技术细节显示,M3在编码能力测试中采用了竞争对手模型“Claude Code”作为评估框架。虽然使用现有工具链进行模型评估是常见做法,但批评者指出,MiniMax本质上是将自家模型与竞争对手的框架进行对比测试,并直接宣称取得了高分,还在公开宣传中将自身与该竞争对手进行比较。 许多开发者认为这种做法不诚实,因为这使得人们难以区分模型本身的原生能力与框架提供的增强效果。
另一个争议点在于其开源承诺的诚意。与其他发布包含完整权重的开源模型的供应商不同,MiniMax既未披露M3的规模,也未提供其权重。 该公司仅表示将在十天内将该模型开源,发布初期仅提供API访问权限。鉴于可重现性和可验证性是开源社区的核心价值,一边宣传开源一边隐瞒权重——尽管从商业角度来看可以理解——却疏远了那些期待透明度和实用性的开发者社区。
让重度用户最感到沮丧的是计费规则的突然变更。此前,MiniMax 以其宽松的使用限制而闻名,仅按请求次数限制,且没有每月代币上限。随着 M3 的发布,该公司引入了一种基于代币的新套餐,按总使用量收费。 尽管官方宣称 Plus 套餐提供了极高的令牌性价比,但重度用户——尤其是处理百万令牌级上下文的用户——发现每次调用都会消耗大量令牌,导致套餐配额迅速耗尽。这引发了老用户的广泛抱怨。
抛开运营层面的争议不谈,M3 在架构层面确实具备显著的创新。它引入了一种名为 MSA(MiniMax Sparse Attention)的自研稀疏注意力机制,通过对键值对应用高精度块划分和稀疏化处理,有效缓解了传统 Transformer 模型中计算量呈二次方级增长的问题。 在底层运算符层面,该模型采用了一种新型聚合计算方法,提升了内存访问的连续性,其速度比开源的 Flash-Sparse-Attention 快四倍。 因此,在百万令牌的上下文场景下,M3 将前向传播和解码速度分别提升了 9 倍和 15 倍,并将单令牌的计算量降至上一代模型的一半。
相关文章
 Meta 希望你的下一个智能设备搭载 Muse 功能
Meta 的 Muse 是一个处理旅行预订、表单提交和购物的 AI 助手,已获得广泛采用,但一项新举措可能特别吸引开发者和硬件爱好者。周五,Meta 推出了 Muse Gadgets,这是一个开源项目,使开发者能够创建与 Muse 集成的定制硬件。Meta 正在发布开源固件和 Linux 软件开发工具包(SDK),以及 starter 项目概念。这些概念包括为 Muse 添加彩色电子墨水显示屏,或将软件嵌入 HDMI 棒以实现电视连接。限制很少。用户可以部署低成本爱好者计算机,如 Rasp
Wan-Streamer v0.2 实现超低延迟 AI 聊天
随着现代技术的飞速发展,人机交互正变得愈发普遍。传统的视频通话常常面临卡顿、延迟以及音视频不同步等问题。通义实验室最新发布的 Wan-Streamer v0.2 彻底克服了这些挑战,实现了真正的“面对面”自然交流,响应延迟仅为 550 毫秒。Wan-Streamer v0.2 是一个全新的端到端多模态理解与生成模型。它在单个 Transformer 模型中集成了“听、看、说、演”功能,使 AI 能够像人类一样实时感知并回应对话。这意味着无论是语音、文本还是视频,AI 都能即时理解并生成恰当的回应
Meta 加入台积电和美光,为新型服务器配备旧款内存
随着人工智能在全球范围内的采用加速,下一代 DDR5 内存正经历严重的供应短缺。为了避免 AI 数据中心部署出现延误,Meta 与台积电(TSMC)和美光(Micron)等行业领导者合作,开发了一种突破性的过渡解决方案。这项创新使得原本专为 DDR5 设计的先进 AI 服务器能够与较旧的 DDR4 模块无缝协同工作。该系统被称为“弗兰肯斯坦”(Frankenstein)配置,在现实世界测试中表现出卓越的稳定性,为突破当前的供应链瓶颈提供了可行的出路。弥合硬件鸿沟DDR5 与 DDR4 之间的向后
相关专题推荐
设计与艺术
 顶级AI插画工具:更快地创作编辑类场景和封面插图
2026年最新高评分AI插画工具:我们精心挑选的这份清单汇集了功能强大的顶级工具,助您快速创作令人惊艳的编辑场景和引人注目的封面艺术。每款工具都经过了严格的实际测试,并提供了免费版与付费版的对比,帮助您找到最适合您工作流程的工具。 立即尝试这些必试解决方案,释放您的AI优势,提升创作效率。立即访问 XIX.AI 探索更多。
 10 个工具
 xix.ai
教育与学习
备考首选的顶尖AI辅导老师:练习数学、科学和英语
2026年最新、评分最高的考试备考AI辅导工具现已登陆XIX.AI!我们精心筛选的这份清单汇集了多款功能强大、颠覆传统的工具,提供免费与付费版本的对比、实际测试以及每周更新的排行榜。它们能帮助你提升写作效率、简化复杂主题的学习,并释放你的学术潜能。 立即探索,发现最适合您的备考工具,今天就开始创作,释放您的AI优势!
10 个工具
xix.ai
金融
用于个人财务管理的 AI 预算规划工具
2026 年最新最佳顶级评分 AI 预算规划工具,专为个人财务管理打造,现已登陆 XIX.AI!本精选合集收录了强大且具颠覆性的解决方案,助您开展实际测试、理解消费习惯,并制定个性化计划以提升生产力。享受免费与付费版的对比及详细排名。这些必试工具旨在简化财务管理,助您释放 AI 优势。立即探索!
11 个工具
xix.ai
健康养生
AI睡眠追踪助手:通过养成更好的睡前习惯来促进身体恢复
2026年最新精选高评分AI睡眠追踪助手,助您实现最佳恢复效果。这份全面更新的每周指南汇集了强大的工具,提供实际测试结果、免费与付费版本对比以及详细排名,助您找到必试的解决方案,从而提升睡眠质量并养成更好的就寝习惯。 立即访问 XIX.AI,解锁您的AI优势。
10 个工具
xix.ai
数据分析
用于产品和收入分析的 AI SQL 辅助工具
2026年最新、最受欢迎、评分最高的AI SQL辅助工具,助力产品与营收分析! XIX.AI 精心遴选了一系列功能强大、颠覆性的必试工具,这些工具均经过每周更新的排名体系进行实战测试。它们能通过加速数据分析、简化复杂查询并生成精准洞察,帮助用户显著提升工作效率,从而推动更明智的商业决策。立即探索,发现最适合您的工具,释放您的AI优势!
14 个工具
xix.ai
教育与学习
最佳的、兼具教学功能的AI作业助手:学习概念,而不仅仅是答案
2026年最新最佳高评分AI作业助手:不仅提供答案,更传授核心概念。专为学生打造的强大工具,精选必试清单,每周更新,免费与付费版本对比,真实使用测试,精准排名,助您充分释放学习潜能。立即探索,发现最适合您的工具,让学习更高效。
10 个工具
xix.ai

 评论 (0)
0/500
大型语言模型的竞争持续白热化,人工智能初创公司MiniMax近日发布了其新款旗舰模型M3。根据技术报告中的基准测试结果,该模型表现令人印象深刻:在模拟真实世界软件工程任务的测试中得分达到59%,超越了GPT-5.5,并接近Opus4.7的水平。 该模型还具备百万令牌级上下文处理能力和原生多模态能力。然而,尽管取得了这些显著的技术成就,此次发布仍引发了开发者社区的强烈反响,尤其在中国网络论坛上出现了尖锐的批评声浪。
质疑的主要焦点集中在评估方法上。 技术细节显示,M3在编码能力测试中采用了竞争对手模型“Claude Code”作为评估框架。虽然使用现有工具链进行模型评估是常见做法,但批评者指出,MiniMax本质上是将自家模型与竞争对手的框架进行对比测试,并直接宣称取得了高分,还在公开宣传中将自身与该竞争对手进行比较。 许多开发者认为这种做法不诚实,因为这使得人们难以区分模型本身的原生能力与框架提供的增强效果。
另一个争议点在于其开源承诺的诚意。与其他发布包含完整权重的开源模型的供应商不同,MiniMax既未披露M3的规模,也未提供其权重。 该公司仅表示将在十天内将该模型开源,发布初期仅提供API访问权限。鉴于可重现性和可验证性是开源社区的核心价值,一边宣传开源一边隐瞒权重——尽管从商业角度来看可以理解——却疏远了那些期待透明度和实用性的开发者社区。
让重度用户最感到沮丧的是计费规则的突然变更。此前,MiniMax 以其宽松的使用限制而闻名,仅按请求次数限制,且没有每月代币上限。随着 M3 的发布,该公司引入了一种基于代币的新套餐,按总使用量收费。 尽管官方宣称 Plus 套餐提供了极高的令牌性价比,但重度用户——尤其是处理百万令牌级上下文的用户——发现每次调用都会消耗大量令牌,导致套餐配额迅速耗尽。这引发了老用户的广泛抱怨。
抛开运营层面的争议不谈,M3 在架构层面确实具备显著的创新。它引入了一种名为 MSA(MiniMax Sparse Attention)的自研稀疏注意力机制,通过对键值对应用高精度块划分和稀疏化处理,有效缓解了传统 Transformer 模型中计算量呈二次方级增长的问题。 在底层运算符层面,该模型采用了一种新型聚合计算方法,提升了内存访问的连续性,其速度比开源的 Flash-Sparse-Attention 快四倍。 因此,在百万令牌的上下文场景下,M3 将前向传播和解码速度分别提升了 9 倍和 15 倍,并将单令牌的计算量降至上一代模型的一半。








 Meta 希望你的下一个智能设备搭载 Muse 功能
Meta 的 Muse 是一个处理旅行预订、表单提交和购物的 AI 助手,已获得广泛采用,但一项新举措可能特别吸引开发者和硬件爱好者。周五,Meta 推出了 Muse Gadgets,这是一个开源项目,使开发者能够创建与 Muse 集成的定制硬件。Meta 正在发布开源固件和 Linux 软件开发工具包(SDK),以及 starter 项目概念。这些概念包括为 Muse 添加彩色电子墨水显示屏,或将软件嵌入 HDMI 棒以实现电视连接。限制很少。用户可以部署低成本爱好者计算机,如 Rasp
 Wan-Streamer v0.2 实现超低延迟 AI 聊天
随着现代技术的飞速发展,人机交互正变得愈发普遍。传统的视频通话常常面临卡顿、延迟以及音视频不同步等问题。通义实验室最新发布的 Wan-Streamer v0.2 彻底克服了这些挑战,实现了真正的“面对面”自然交流,响应延迟仅为 550 毫秒。Wan-Streamer v0.2 是一个全新的端到端多模态理解与生成模型。它在单个 Transformer 模型中集成了“听、看、说、演”功能,使 AI 能够像人类一样实时感知并回应对话。这意味着无论是语音、文本还是视频,AI 都能即时理解并生成恰当的回应
 Meta 加入台积电和美光,为新型服务器配备旧款内存
随着人工智能在全球范围内的采用加速,下一代 DDR5 内存正经历严重的供应短缺。为了避免 AI 数据中心部署出现延误,Meta 与台积电(TSMC)和美光(Micron)等行业领导者合作,开发了一种突破性的过渡解决方案。这项创新使得原本专为 DDR5 设计的先进 AI 服务器能够与较旧的 DDR4 模块无缝协同工作。该系统被称为“弗兰肯斯坦”(Frankenstein)配置,在现实世界测试中表现出卓越的稳定性,为突破当前的供应链瓶颈提供了可行的出路。弥合硬件鸿沟DDR5 与 DDR4 之间的向后

2026年最新高评分AI插画工具:我们精心挑选的这份清单汇集了功能强大的顶级工具,助您快速创作令人惊艳的编辑场景和引人注目的封面艺术。每款工具都经过了严格的实际测试,并提供了免费版与付费版的对比,帮助您找到最适合您工作流程的工具。 立即尝试这些必试解决方案,释放您的AI优势,提升创作效率。立即访问 XIX.AI 探索更多。
10 个工具
xix.ai

2026年最新、评分最高的考试备考AI辅导工具现已登陆XIX.AI!我们精心筛选的这份清单汇集了多款功能强大、颠覆传统的工具,提供免费与付费版本的对比、实际测试以及每周更新的排行榜。它们能帮助你提升写作效率、简化复杂主题的学习,并释放你的学术潜能。 立即探索,发现最适合您的备考工具,今天就开始创作,释放您的AI优势!
10 个工具
xix.ai

2026 年最新最佳顶级评分 AI 预算规划工具,专为个人财务管理打造,现已登陆 XIX.AI!本精选合集收录了强大且具颠覆性的解决方案,助您开展实际测试、理解消费习惯,并制定个性化计划以提升生产力。享受免费与付费版的对比及详细排名。这些必试工具旨在简化财务管理,助您释放 AI 优势。立即探索!
11 个工具
xix.ai

2026年最新精选高评分AI睡眠追踪助手,助您实现最佳恢复效果。这份全面更新的每周指南汇集了强大的工具,提供实际测试结果、免费与付费版本对比以及详细排名,助您找到必试的解决方案,从而提升睡眠质量并养成更好的就寝习惯。 立即访问 XIX.AI,解锁您的AI优势。
10 个工具
xix.ai

2026年最新、最受欢迎、评分最高的AI SQL辅助工具,助力产品与营收分析! XIX.AI 精心遴选了一系列功能强大、颠覆性的必试工具,这些工具均经过每周更新的排名体系进行实战测试。它们能通过加速数据分析、简化复杂查询并生成精准洞察,帮助用户显著提升工作效率,从而推动更明智的商业决策。立即探索,发现最适合您的工具,释放您的AI优势!
14 个工具
xix.ai

2026年最新最佳高评分AI作业助手:不仅提供答案,更传授核心概念。专为学生打造的强大工具,精选必试清单,每周更新,免费与付费版本对比,真实使用测试,精准排名,助您充分释放学习潜能。立即探索,发现最适合您的工具,让学习更高效。
10 个工具
xix.ai












