


 Lar
O modelo M3, carro-chefe da MiniMax, e seu indicador impressionam, mas geram reações controversas
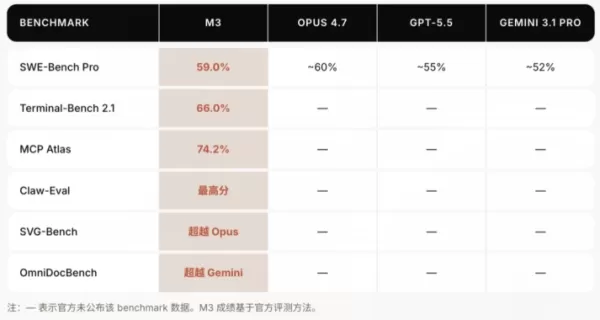
A corrida pelos grandes modelos de linguagem continua a se intensificar, com a startup de IA MiniMax lançando recentemente seu novo modelo principal, o M3. De acordo com os resultados dos testes de benchmark apresentados no relatório técnico, o modelo apresenta um desempenho impressionante: obteve 59% em testes que simulam tarefas reais de engenharia de software, superando o GPT-5.5 e se aproximando do Opus4.7. Ele também oferece processamento de contexto de milhões de tokens e recursos multimodais nativos. No entanto, apesar dessas conquistas técnicas significativas, o lançamento gerou uma reação negativa considerável da comunidade de desenvolvedores, com críticas particularmente severas surgindo em fóruns online chineses.
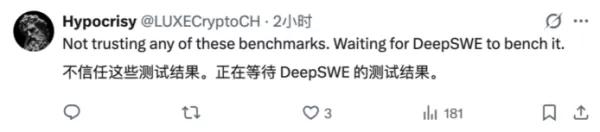
Uma das principais fontes de ceticismo gira em torno da metodologia de avaliação. Detalhes técnicos revelam que o M3 utilizou o Claude Code — um modelo concorrente — como estrutura de avaliação para seus testes de capacidade de codificação. Embora seja prática comum usar cadeias de ferramentas existentes para avaliações de agentes, os críticos afirmam que a MiniMax basicamente testou seu próprio modelo contra a estrutura de um concorrente e reivindicou diretamente pontuações altas, comparando-se ao mesmo concorrente em promoções públicas. Muitos desenvolvedores classificaram essa abordagem como desonesta, pois torna difícil distinguir as habilidades nativas do modelo das melhorias proporcionadas pela estrutura.
Outro ponto de controvérsia é a sinceridade do compromisso com o código aberto. Ao contrário de outros fornecedores que lançam modelos de código aberto com pesos completos, a MiniMax não divulgou o tamanho do M3 nem forneceu seus pesos. A empresa limitou-se a afirmar que tornaria o modelo de código aberto em até dez dias, oferecendo apenas acesso à API no lançamento. Como a reprodutibilidade e a verificabilidade são valores fundamentais da comunidade de código aberto, promover o código aberto enquanto se ocultam os pesos — embora compreensível do ponto de vista comercial — afastou uma comunidade de desenvolvedores que espera transparência e praticidade.
O que mais frustrou os usuários intensivos foi a mudança repentina nas regras de cobrança. Anteriormente, a MiniMax era conhecida por seus limites generosos de uso, restringindo pelo número de solicitações sem um limite mensal de tokens. Com o lançamento do M3, a empresa introduziu um novo plano baseado em tokens que cobra pelo volume total. Embora a versão oficial seja de que o plano Plus oferece um excelente custo-benefício em termos de tokens, os usuários intensivos — especialmente aqueles que trabalham com contextos de milhões de tokens — percebem que cada chamada consome uma grande quantidade, esgotando rapidamente as cotas do pacote. Isso levou a reclamações generalizadas por parte de usuários de longa data.
Deixando de lado as controvérsias operacionais, o M3 apresenta inovações notáveis no nível arquitetônico. Ele introduz um mecanismo de atenção esparsa desenvolvido internamente, chamado MSA (MiniMax Sparse Attention), que mitiga a explosão computacional quadrática dos Transformers tradicionais ao aplicar particionamento de blocos de alta precisão e esparsificação a pares chave-valor. No nível dos operadores de baixo nível, o modelo adota um método inovador de cálculo de agregação que melhora a continuidade do acesso à memória, alcançando velocidades quatro vezes mais rápidas do que o Flash-Sparse-Attention de código aberto. Como resultado, o M3 aumenta as velocidades de propagação para frente e de decodificação em 9x e 15x, respectivamente, em contextos de milhões de tokens, reduzindo o cálculo por token para metade do da geração anterior.
Artigo relacionado
 A Meta quer que seu próximo gadget seja alimentado por Muse
O Muse da Meta, um assistente de inteligência artificial que gerencia reservas de viagem, envio de formulários e compras, tem sido amplamente adotado, mas uma nova iniciativa pode atrair especialmente desenvolvedores e entusiastas de hardware.Na sex
Wan-Streamer v0.2 oferece chat de IA com latência ultrabaixa
À medida que a tecnologia moderna avança rapidamente, a interação entre humanos e inteligência artificial está se tornando mais comum. As chamadas de vídeo tradicionais frequentemente enfrentam problemas de atraso, latência e dessincronização áudio-v
A Meta se une à TSMC e Micron para equipar novos servidores com memória antiga
À medida que a adoção da inteligência artificial se acelera em todo o mundo, a memória DDR5 de próxima geração está enfrentando uma escassez crítica de suprimentos. Para evitar atrasos nos despliegues de data centers de IA, a Meta estabeleceu uma par
Recomendações de tópicos especiais relacionados
Design e Arte
 As melhores ferramentas de ilustração com IA: crie cenas editoriais e capas de forma mais rápida
As melhores ferramentas de ilustração com IA de 2026: nossa lista selecionada apresenta as melhores ferramentas, com design robusto, para criar rapidamente cenas editoriais impressionantes e capas atraentes. Cada opção passou por rigorosos testes práticos, oferecendo uma comparação entre versões gratuitas e pagas para ajudar você a encontrar a opção perfeita para o seu fluxo de trabalho. Experimente hoje mesmo essas soluções imperdíveis para aproveitar ao máximo as vantagens da IA e impulsionar sua produtividade criativa. Explore agora no XIX.AI.
 10 ferramentas
 xix.ai
Educação e Aprendizagem
Os melhores professores particulares especializados em IA para preparação para exames: pratique matemática, ciências e inglês
Os melhores tutores de IA para preparação para exames de 2026, com as melhores avaliações, estão aqui no XIX.AI! Nossa lista cuidadosamente selecionada apresenta ferramentas poderosas e revolucionárias que oferecem comparação entre versões gratuitas e pagas, testes práticos e rankings atualizados semanalmente. Elas ajudam a aumentar sua eficiência na redação, simplificar o aprendizado de tópicos complexos e liberar seu potencial acadêmico. Explore agora para descobrir sua ferramenta perfeita de preparação para exames e comece a criar hoje mesmo para aproveitar toda a vantagem da IA!
10 ferramentas
xix.ai
Financiar
Ferramentas de planejamento orçamentário com IA para gestão financeira pessoal
As melhores e mais bem avaliadas ferramentas de planejamento orçamentário com IA para gestão financeira pessoal de 2026 estão aqui no XIX.AI! Esta seleção especial apresenta soluções poderosas e revolucionárias que ajudam você a realizar testes na prática, entender hábitos de consumo e criar planos personalizados para aumentar a produtividade. Confira uma comparação entre versões gratuitas e pagas, além de rankings detalhados. Ferramentas imperdíveis, projetadas para simplificar a gestão financeira e explorar o potencial da IA. Explore agora!
11 ferramentas
xix.ai
Saúde e Bem-Estar
Assistentes de rastreamento do sono com IA: melhore sua recuperação adotando hábitos mais adequados antes de dormir
2026 – Os melhores assistentes de rastreamento do sono com inteligência artificial mais bem avaliados, selecionados para proporcionar uma recuperação máxima. Este guia semanal completamente atualizado apresenta ferramentas poderosas que incluem testes reais, comparações entre versões gratuitas e pagas, além de classificações detalhadas, visando ajudá-lo a encontrar a solução ideal para melhorar a qualidade do sono e fomentar hábitos noturnos mais saudáveis. Explore agora em XIX.AI e aproveite todas as vantagens oferecidas pela inteligência artificial.
10 ferramentas
xix.ai
Análise de dados
Copilotos de IA em SQL para análise de produtos e receitas
2026: Os melhores e mais bem avaliados copilotos de IA para SQL em análise de produtos e receitas! A XIX.AI selecionou um conjunto poderoso e revolucionário de ferramentas imperdíveis, que passam por testes práticos por meio de rankings atualizados semanalmente. Essas ferramentas ajudam os usuários a aumentar significativamente a produtividade, acelerando a análise de dados, simplificando consultas complexas e gerando insights precisos para impulsionar decisões de negócios mais inteligentes. Explore agora e descubra a ferramenta perfeita para aproveitar ao máximo o potencial da IA!
14 ferramentas
xix.ai
Educação e Aprendizagem
Os melhores auxiliares de tarefas escolares com IA que ensinam: aprenda conceitos, não apenas respostas
2026: Os melhores e mais bem avaliados auxiliares de tarefas com IA que ensinam conceitos fundamentais, não apenas respostas. Ferramentas poderosas para estudantes. Lista selecionada que você não pode deixar de conferir. Atualizada semanalmente. Comparação entre versões gratuitas e pagas. Testes em situações reais. Rankings precisos para ajudar você a atingir todo o seu potencial de aprendizado. Explore agora e descubra a ferramenta perfeita para estudar de forma mais inteligente.
10 ferramentas
xix.ai

 Comentários (0)
A corrida pelos grandes modelos de linguagem continua a se intensificar, com a startup de IA MiniMax lançando recentemente seu novo modelo principal, o M3. De acordo com os resultados dos testes de benchmark apresentados no relatório técnico, o modelo apresenta um desempenho impressionante: obteve 59% em testes que simulam tarefas reais de engenharia de software, superando o GPT-5.5 e se aproximando do Opus4.7. Ele também oferece processamento de contexto de milhões de tokens e recursos multimodais nativos. No entanto, apesar dessas conquistas técnicas significativas, o lançamento gerou uma reação negativa considerável da comunidade de desenvolvedores, com críticas particularmente severas surgindo em fóruns online chineses.
Uma das principais fontes de ceticismo gira em torno da metodologia de avaliação. Detalhes técnicos revelam que o M3 utilizou o Claude Code — um modelo concorrente — como estrutura de avaliação para seus testes de capacidade de codificação. Embora seja prática comum usar cadeias de ferramentas existentes para avaliações de agentes, os críticos afirmam que a MiniMax basicamente testou seu próprio modelo contra a estrutura de um concorrente e reivindicou diretamente pontuações altas, comparando-se ao mesmo concorrente em promoções públicas. Muitos desenvolvedores classificaram essa abordagem como desonesta, pois torna difícil distinguir as habilidades nativas do modelo das melhorias proporcionadas pela estrutura.
Outro ponto de controvérsia é a sinceridade do compromisso com o código aberto. Ao contrário de outros fornecedores que lançam modelos de código aberto com pesos completos, a MiniMax não divulgou o tamanho do M3 nem forneceu seus pesos. A empresa limitou-se a afirmar que tornaria o modelo de código aberto em até dez dias, oferecendo apenas acesso à API no lançamento. Como a reprodutibilidade e a verificabilidade são valores fundamentais da comunidade de código aberto, promover o código aberto enquanto se ocultam os pesos — embora compreensível do ponto de vista comercial — afastou uma comunidade de desenvolvedores que espera transparência e praticidade.
O que mais frustrou os usuários intensivos foi a mudança repentina nas regras de cobrança. Anteriormente, a MiniMax era conhecida por seus limites generosos de uso, restringindo pelo número de solicitações sem um limite mensal de tokens. Com o lançamento do M3, a empresa introduziu um novo plano baseado em tokens que cobra pelo volume total. Embora a versão oficial seja de que o plano Plus oferece um excelente custo-benefício em termos de tokens, os usuários intensivos — especialmente aqueles que trabalham com contextos de milhões de tokens — percebem que cada chamada consome uma grande quantidade, esgotando rapidamente as cotas do pacote. Isso levou a reclamações generalizadas por parte de usuários de longa data.
Deixando de lado as controvérsias operacionais, o M3 apresenta inovações notáveis no nível arquitetônico. Ele introduz um mecanismo de atenção esparsa desenvolvido internamente, chamado MSA (MiniMax Sparse Attention), que mitiga a explosão computacional quadrática dos Transformers tradicionais ao aplicar particionamento de blocos de alta precisão e esparsificação a pares chave-valor. No nível dos operadores de baixo nível, o modelo adota um método inovador de cálculo de agregação que melhora a continuidade do acesso à memória, alcançando velocidades quatro vezes mais rápidas do que o Flash-Sparse-Attention de código aberto. Como resultado, o M3 aumenta as velocidades de propagação para frente e de decodificação em 9x e 15x, respectivamente, em contextos de milhões de tokens, reduzindo o cálculo por token para metade do da geração anterior.








 A Meta quer que seu próximo gadget seja alimentado por Muse
O Muse da Meta, um assistente de inteligência artificial que gerencia reservas de viagem, envio de formulários e compras, tem sido amplamente adotado, mas uma nova iniciativa pode atrair especialmente desenvolvedores e entusiastas de hardware.Na sex
 Wan-Streamer v0.2 oferece chat de IA com latência ultrabaixa
À medida que a tecnologia moderna avança rapidamente, a interação entre humanos e inteligência artificial está se tornando mais comum. As chamadas de vídeo tradicionais frequentemente enfrentam problemas de atraso, latência e dessincronização áudio-v
 A Meta se une à TSMC e Micron para equipar novos servidores com memória antiga
À medida que a adoção da inteligência artificial se acelera em todo o mundo, a memória DDR5 de próxima geração está enfrentando uma escassez crítica de suprimentos. Para evitar atrasos nos despliegues de data centers de IA, a Meta estabeleceu uma par

As melhores ferramentas de ilustração com IA de 2026: nossa lista selecionada apresenta as melhores ferramentas, com design robusto, para criar rapidamente cenas editoriais impressionantes e capas atraentes. Cada opção passou por rigorosos testes práticos, oferecendo uma comparação entre versões gratuitas e pagas para ajudar você a encontrar a opção perfeita para o seu fluxo de trabalho. Experimente hoje mesmo essas soluções imperdíveis para aproveitar ao máximo as vantagens da IA e impulsionar sua produtividade criativa. Explore agora no XIX.AI.
10 ferramentas
xix.ai

Os melhores tutores de IA para preparação para exames de 2026, com as melhores avaliações, estão aqui no XIX.AI! Nossa lista cuidadosamente selecionada apresenta ferramentas poderosas e revolucionárias que oferecem comparação entre versões gratuitas e pagas, testes práticos e rankings atualizados semanalmente. Elas ajudam a aumentar sua eficiência na redação, simplificar o aprendizado de tópicos complexos e liberar seu potencial acadêmico. Explore agora para descobrir sua ferramenta perfeita de preparação para exames e comece a criar hoje mesmo para aproveitar toda a vantagem da IA!
10 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de planejamento orçamentário com IA para gestão financeira pessoal de 2026 estão aqui no XIX.AI! Esta seleção especial apresenta soluções poderosas e revolucionárias que ajudam você a realizar testes na prática, entender hábitos de consumo e criar planos personalizados para aumentar a produtividade. Confira uma comparação entre versões gratuitas e pagas, além de rankings detalhados. Ferramentas imperdíveis, projetadas para simplificar a gestão financeira e explorar o potencial da IA. Explore agora!
11 ferramentas
xix.ai

2026 – Os melhores assistentes de rastreamento do sono com inteligência artificial mais bem avaliados, selecionados para proporcionar uma recuperação máxima. Este guia semanal completamente atualizado apresenta ferramentas poderosas que incluem testes reais, comparações entre versões gratuitas e pagas, além de classificações detalhadas, visando ajudá-lo a encontrar a solução ideal para melhorar a qualidade do sono e fomentar hábitos noturnos mais saudáveis. Explore agora em XIX.AI e aproveite todas as vantagens oferecidas pela inteligência artificial.
10 ferramentas
xix.ai

2026: Os melhores e mais bem avaliados copilotos de IA para SQL em análise de produtos e receitas! A XIX.AI selecionou um conjunto poderoso e revolucionário de ferramentas imperdíveis, que passam por testes práticos por meio de rankings atualizados semanalmente. Essas ferramentas ajudam os usuários a aumentar significativamente a produtividade, acelerando a análise de dados, simplificando consultas complexas e gerando insights precisos para impulsionar decisões de negócios mais inteligentes. Explore agora e descubra a ferramenta perfeita para aproveitar ao máximo o potencial da IA!
14 ferramentas
xix.ai

2026: Os melhores e mais bem avaliados auxiliares de tarefas com IA que ensinam conceitos fundamentais, não apenas respostas. Ferramentas poderosas para estudantes. Lista selecionada que você não pode deixar de conferir. Atualizada semanalmente. Comparação entre versões gratuitas e pagas. Testes em situações reais. Rankings precisos para ajudar você a atingir todo o seu potencial de aprendizado. Explore agora e descubra a ferramenta perfeita para estudar de forma mais inteligente.
10 ferramentas
xix.ai












