


 Hogar
El modelo insignia M3 de MiniMax y su indicador causan sensación, pero también suscitan reacciones encontradas
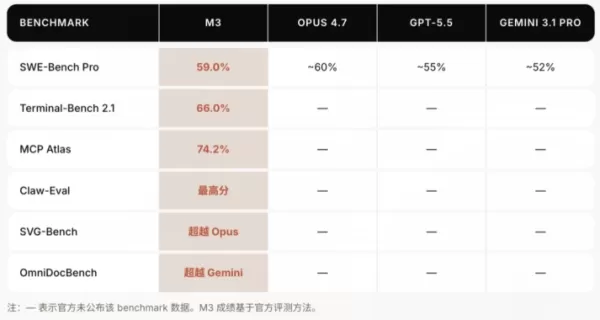
La carrera por los modelos de lenguaje a gran escala sigue intensificándose, y la startup de IA MiniMax ha presentado recientemente su nuevo modelo insignia, el M3. Según los resultados de las pruebas comparativas recogidos en el informe técnico, el modelo ofrece un rendimiento impresionante: ha obtenido una puntuación del 59 % en pruebas que simulan tareas reales de ingeniería de software, superando al GPT-5.5 y acercándose al Opus4.7. Además, ofrece procesamiento de contexto de un millón de tokens y capacidades multimodales nativas. Sin embargo, a pesar de estos notables logros técnicos, el lanzamiento ha desencadenado una importante reacción negativa por parte de la comunidad de desarrolladores, con críticas especialmente duras en los foros online chinos.
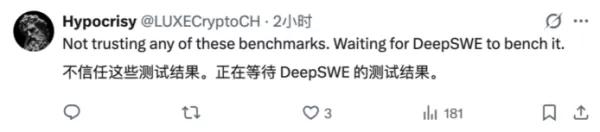
Una de las principales fuentes de escepticismo gira en torno a la metodología de evaluación. Los detalles técnicos revelan que M3 utilizó Claude Code —un modelo competidor— como marco de evaluación para sus pruebas de capacidad de programación. Aunque es una práctica habitual utilizar cadenas de herramientas existentes para las evaluaciones de agentes, los críticos afirman que MiniMax, en esencia, probó su propio modelo frente al marco de un competidor y reivindicó directamente puntuaciones elevadas, comparándose con ese mismo competidor en promociones públicas. Muchos desarrolladores han calificado este enfoque de poco sincero, ya que dificulta distinguir las capacidades propias del modelo de las mejoras aportadas por el marco.
Otro punto de controversia es la sinceridad del compromiso con el código abierto. A diferencia de otros proveedores que publican modelos de código abierto con los pesos completos, MiniMax no reveló el tamaño de M3 ni facilitó sus pesos. La empresa solo declaró que haría el modelo de código abierto en un plazo de diez días, ofreciendo únicamente acceso a la API en el momento del lanzamiento. Dado que la reproducibilidad y la verificabilidad son valores fundamentales de la comunidad de código abierto, promover el código abierto al tiempo que se ocultan los pesos —aunque comprensible desde un punto de vista comercial— ha alejado a una comunidad de desarrolladores que espera transparencia y practicidad.
Lo que más ha frustrado a los usuarios intensivos es el cambio repentino en las normas de facturación. Anteriormente, MiniMax era conocida por sus generosos límites de uso, que se restringían por número de solicitudes sin un límite mensual de tokens. Con el lanzamiento de M3, la empresa introdujo un nuevo plan basado en tokens que cobra por volumen total. Aunque la versión oficial es que el plan Plus ofrece una excelente relación calidad-token, los usuarios intensivos —especialmente aquellos que trabajan con contextos de millones de tokens— consideran que cada llamada consume una gran cantidad, lo que agota rápidamente las cuotas del paquete. Esto ha dado lugar a quejas generalizadas por parte de los usuarios de larga duración.
Dejando a un lado las controversias operativas, M3 presenta innovaciones notables a nivel arquitectónico. Introduce un mecanismo de atención dispersa de desarrollo propio denominado MSA (MiniMax Sparse Attention), que mitiga la explosión computacional cuadrática de los Transformers tradicionales mediante la aplicación de una partición en bloques de alta precisión y la dispersificación de los pares clave-valor. A nivel de operadores de bajo nivel, el modelo adopta un novedoso método de cálculo de agregación que mejora la continuidad del acceso a la memoria, alcanzando velocidades cuatro veces superiores a las del Flash-Sparse-Attention de código abierto. Como resultado, M3 multiplica por 9 y por 15 las velocidades de propagación hacia adelante y de decodificación, respectivamente, en contextos de un millón de tokens, reduciendo el cálculo por token a la mitad con respecto a la generación anterior.
Artículo relacionado
 La carrera por la IA no va a esperar, y tampoco lo hará este descuento del 25 % de TechCrunch Disrupt
Todos los fundadores que están desarrollando proyectos de IA en estos momentos se plantean la misma pregunta: ¿Estamos avanzando lo suficientemente rápido y de forma lo suficientemente eficaz? TechCru
Qianwen AI Free frente a las instituciones: desenmascarando la estafa de la redacción a precios elevados
El 25 de junio, la CCTV emitió un reportaje de investigación sobre el caótico mercado de la inscripción de voluntarios para los exámenes de acceso a la universidad, lo que desencadenó un amplio debate
OiiOii, la herramienta profesional para agentes de animación, se estrena como el «Pixar» de la era de la IA
El 2 de abril, OiiOii, el primer agente de creación de animación de nivel profesional del mundo, concluyó su fase beta y anunció su lanzamiento mundial. Este producto «revelación», que atrajo a 100 00
Recomendaciones de temas especiales relacionados
Diseño y Arte
 Las mejores herramientas de ilustración con IA: crea escenas editoriales y portadas más rápido
Las mejores herramientas de ilustración con IA de 2026: nuestra lista seleccionada incluye las mejores herramientas, diseñadas con gran potencia, para crear rápidamente impresionantes escenas editoriales y llamativas portadas. Cada opción ha sido sometida a rigurosas pruebas en condiciones reales y ofrece una comparación entre las versiones gratuitas y de pago para ayudarte a encontrar la que mejor se adapte a tu flujo de trabajo. Prueba hoy mismo estas soluciones imprescindibles para sacar el máximo partido a la IA y potenciar tu productividad creativa. Descúbrelas ahora en XIX.AI.
 10 herramientas
 xix.ai
Educación y aprendizaje
Los mejores profesores particulares de IA para la preparación de exámenes: practica matemáticas, ciencias e inglés
¡Ya están aquí, en XIX.AI, los mejores tutores de IA para la preparación de exámenes de 2026, con las mejores valoraciones! Nuestra lista seleccionada incluye potentes herramientas revolucionarias que ofrecen comparativas entre versiones gratuitas y de pago, pruebas reales y clasificaciones actualizadas semanalmente. Te ayudan a mejorar tu eficiencia a la hora de escribir, a simplificar el aprendizaje de temas complejos y a desarrollar todo tu potencial académico. ¡Explora ahora mismo para descubrir tu herramienta perfecta de preparación de exámenes y empieza a crear hoy mismo para sacar partido a tu ventaja con la IA!
10 herramientas
xix.ai
Finanzas
Herramientas de planificación presupuestaria con IA para la gestión personal del dinero
2026 Últimas Mejores Herramientas de Planificación Presupuestaria con IA Mejor Valoradas para la Gestión Personal del Dinero están aquí en XIX.AI. Esta colección seleccionada presenta soluciones poderosas y transformadoras que te ayudan a realizar pruebas en el mundo real, comprender tus hábitos de gasto y crear planes personalizados para aumentar la productividad. Disfruta de una comparación entre versiones gratuitas y de pago junto con clasificaciones detalladas. Herramientas imprescindibles diseñadas para simplificar la gestión del dinero y desbloquear tu ventaja con IA. ¡Explóralas ahora!
11 herramientas
xix.ai
Salud y bienestar
Asistentes de seguimiento del sueño basados en IA: mejora tu recuperación con mejores hábitos a la hora de acostarte
Los mejores asistentes de seguimiento del sueño con IA de 2026, seleccionados para una recuperación óptima. Esta guía semanal totalmente actualizada incluye potentes herramientas que ofrecen pruebas en condiciones reales, comparativas entre opciones gratuitas y de pago, y clasificaciones detalladas para ayudarte a encontrar la solución imprescindible que mejora la calidad del sueño y fomenta mejores hábitos a la hora de acostarse. Descúbrelo ahora en XIX.AI y aprovecha todas las ventajas de la IA.
10 herramientas
xix.ai
Análisis de datos
Copilotos de IA y SQL para el análisis de productos e ingresos
¡Los mejores copilotos de IA para SQL mejor valorados de 2026 para el análisis de productos e ingresos! XIX.AI ha seleccionado una potente colección de herramientas revolucionarias que no te puedes perder y que se someten a pruebas en el mundo real a través de clasificaciones que se actualizan semanalmente. Estas herramientas ayudan a los usuarios a aumentar significativamente su productividad al acelerar el análisis de datos, simplificar consultas complejas y generar información precisa para tomar decisiones empresariales más inteligentes. ¡Explora ahora mismo y descubre la herramienta perfecta para sacar el máximo partido a tu ventaja en IA!
14 herramientas
xix.ai
Educación y aprendizaje
Las mejores herramientas de IA para los deberes que realmente enseñan: aprende conceptos, no solo respuestas
2026: los mejores y más valorados asistentes de deberes con IA que enseñan conceptos básicos, no solo respuestas. Potentes herramientas para estudiantes. Una selección imprescindible que debes probar. Actualización semanal. Comparativa entre opciones gratuitas y de pago. Pruebas en el mundo real. Clasificaciones precisas para ayudarte a desarrollar todo tu potencial de aprendizaje. Explora ahora y descubre la herramienta perfecta para estudiar de forma más inteligente.
10 herramientas
xix.ai

 comentario (0)
0/500
La carrera por los modelos de lenguaje a gran escala sigue intensificándose, y la startup de IA MiniMax ha presentado recientemente su nuevo modelo insignia, el M3. Según los resultados de las pruebas comparativas recogidos en el informe técnico, el modelo ofrece un rendimiento impresionante: ha obtenido una puntuación del 59 % en pruebas que simulan tareas reales de ingeniería de software, superando al GPT-5.5 y acercándose al Opus4.7. Además, ofrece procesamiento de contexto de un millón de tokens y capacidades multimodales nativas. Sin embargo, a pesar de estos notables logros técnicos, el lanzamiento ha desencadenado una importante reacción negativa por parte de la comunidad de desarrolladores, con críticas especialmente duras en los foros online chinos.
Una de las principales fuentes de escepticismo gira en torno a la metodología de evaluación. Los detalles técnicos revelan que M3 utilizó Claude Code —un modelo competidor— como marco de evaluación para sus pruebas de capacidad de programación. Aunque es una práctica habitual utilizar cadenas de herramientas existentes para las evaluaciones de agentes, los críticos afirman que MiniMax, en esencia, probó su propio modelo frente al marco de un competidor y reivindicó directamente puntuaciones elevadas, comparándose con ese mismo competidor en promociones públicas. Muchos desarrolladores han calificado este enfoque de poco sincero, ya que dificulta distinguir las capacidades propias del modelo de las mejoras aportadas por el marco.
Otro punto de controversia es la sinceridad del compromiso con el código abierto. A diferencia de otros proveedores que publican modelos de código abierto con los pesos completos, MiniMax no reveló el tamaño de M3 ni facilitó sus pesos. La empresa solo declaró que haría el modelo de código abierto en un plazo de diez días, ofreciendo únicamente acceso a la API en el momento del lanzamiento. Dado que la reproducibilidad y la verificabilidad son valores fundamentales de la comunidad de código abierto, promover el código abierto al tiempo que se ocultan los pesos —aunque comprensible desde un punto de vista comercial— ha alejado a una comunidad de desarrolladores que espera transparencia y practicidad.
Lo que más ha frustrado a los usuarios intensivos es el cambio repentino en las normas de facturación. Anteriormente, MiniMax era conocida por sus generosos límites de uso, que se restringían por número de solicitudes sin un límite mensual de tokens. Con el lanzamiento de M3, la empresa introdujo un nuevo plan basado en tokens que cobra por volumen total. Aunque la versión oficial es que el plan Plus ofrece una excelente relación calidad-token, los usuarios intensivos —especialmente aquellos que trabajan con contextos de millones de tokens— consideran que cada llamada consume una gran cantidad, lo que agota rápidamente las cuotas del paquete. Esto ha dado lugar a quejas generalizadas por parte de los usuarios de larga duración.
Dejando a un lado las controversias operativas, M3 presenta innovaciones notables a nivel arquitectónico. Introduce un mecanismo de atención dispersa de desarrollo propio denominado MSA (MiniMax Sparse Attention), que mitiga la explosión computacional cuadrática de los Transformers tradicionales mediante la aplicación de una partición en bloques de alta precisión y la dispersificación de los pares clave-valor. A nivel de operadores de bajo nivel, el modelo adopta un novedoso método de cálculo de agregación que mejora la continuidad del acceso a la memoria, alcanzando velocidades cuatro veces superiores a las del Flash-Sparse-Attention de código abierto. Como resultado, M3 multiplica por 9 y por 15 las velocidades de propagación hacia adelante y de decodificación, respectivamente, en contextos de un millón de tokens, reduciendo el cálculo por token a la mitad con respecto a la generación anterior.








 La carrera por la IA no va a esperar, y tampoco lo hará este descuento del 25 % de TechCrunch Disrupt
Todos los fundadores que están desarrollando proyectos de IA en estos momentos se plantean la misma pregunta: ¿Estamos avanzando lo suficientemente rápido y de forma lo suficientemente eficaz? TechCru
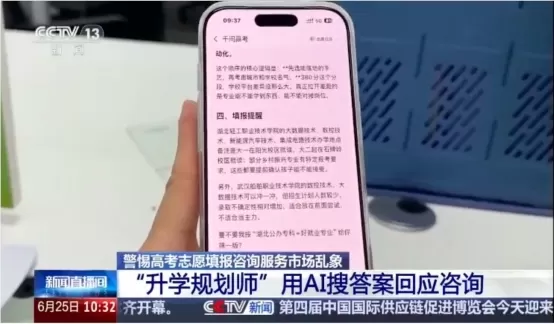 Qianwen AI Free frente a las instituciones: desenmascarando la estafa de la redacción a precios elevados
El 25 de junio, la CCTV emitió un reportaje de investigación sobre el caótico mercado de la inscripción de voluntarios para los exámenes de acceso a la universidad, lo que desencadenó un amplio debate
 OiiOii, la herramienta profesional para agentes de animación, se estrena como el «Pixar» de la era de la IA
El 2 de abril, OiiOii, el primer agente de creación de animación de nivel profesional del mundo, concluyó su fase beta y anunció su lanzamiento mundial. Este producto «revelación», que atrajo a 100 00

Las mejores herramientas de ilustración con IA de 2026: nuestra lista seleccionada incluye las mejores herramientas, diseñadas con gran potencia, para crear rápidamente impresionantes escenas editoriales y llamativas portadas. Cada opción ha sido sometida a rigurosas pruebas en condiciones reales y ofrece una comparación entre las versiones gratuitas y de pago para ayudarte a encontrar la que mejor se adapte a tu flujo de trabajo. Prueba hoy mismo estas soluciones imprescindibles para sacar el máximo partido a la IA y potenciar tu productividad creativa. Descúbrelas ahora en XIX.AI.
10 herramientas
xix.ai

¡Ya están aquí, en XIX.AI, los mejores tutores de IA para la preparación de exámenes de 2026, con las mejores valoraciones! Nuestra lista seleccionada incluye potentes herramientas revolucionarias que ofrecen comparativas entre versiones gratuitas y de pago, pruebas reales y clasificaciones actualizadas semanalmente. Te ayudan a mejorar tu eficiencia a la hora de escribir, a simplificar el aprendizaje de temas complejos y a desarrollar todo tu potencial académico. ¡Explora ahora mismo para descubrir tu herramienta perfecta de preparación de exámenes y empieza a crear hoy mismo para sacar partido a tu ventaja con la IA!
10 herramientas
xix.ai

2026 Últimas Mejores Herramientas de Planificación Presupuestaria con IA Mejor Valoradas para la Gestión Personal del Dinero están aquí en XIX.AI. Esta colección seleccionada presenta soluciones poderosas y transformadoras que te ayudan a realizar pruebas en el mundo real, comprender tus hábitos de gasto y crear planes personalizados para aumentar la productividad. Disfruta de una comparación entre versiones gratuitas y de pago junto con clasificaciones detalladas. Herramientas imprescindibles diseñadas para simplificar la gestión del dinero y desbloquear tu ventaja con IA. ¡Explóralas ahora!
11 herramientas
xix.ai

Los mejores asistentes de seguimiento del sueño con IA de 2026, seleccionados para una recuperación óptima. Esta guía semanal totalmente actualizada incluye potentes herramientas que ofrecen pruebas en condiciones reales, comparativas entre opciones gratuitas y de pago, y clasificaciones detalladas para ayudarte a encontrar la solución imprescindible que mejora la calidad del sueño y fomenta mejores hábitos a la hora de acostarse. Descúbrelo ahora en XIX.AI y aprovecha todas las ventajas de la IA.
10 herramientas
xix.ai

¡Los mejores copilotos de IA para SQL mejor valorados de 2026 para el análisis de productos e ingresos! XIX.AI ha seleccionado una potente colección de herramientas revolucionarias que no te puedes perder y que se someten a pruebas en el mundo real a través de clasificaciones que se actualizan semanalmente. Estas herramientas ayudan a los usuarios a aumentar significativamente su productividad al acelerar el análisis de datos, simplificar consultas complejas y generar información precisa para tomar decisiones empresariales más inteligentes. ¡Explora ahora mismo y descubre la herramienta perfecta para sacar el máximo partido a tu ventaja en IA!
14 herramientas
xix.ai

2026: los mejores y más valorados asistentes de deberes con IA que enseñan conceptos básicos, no solo respuestas. Potentes herramientas para estudiantes. Una selección imprescindible que debes probar. Actualización semanal. Comparativa entre opciones gratuitas y de pago. Pruebas en el mundo real. Clasificaciones precisas para ayudarte a desarrollar todo tu potencial de aprendizaje. Explora ahora y descubre la herramienta perfecta para estudiar de forma más inteligente.
10 herramientas
xix.ai












