


 Heim
Das M3-Flaggschiffmodell von MiniMax und sein Indikator beeindrucken, lösen jedoch kontroverse Reaktionen aus
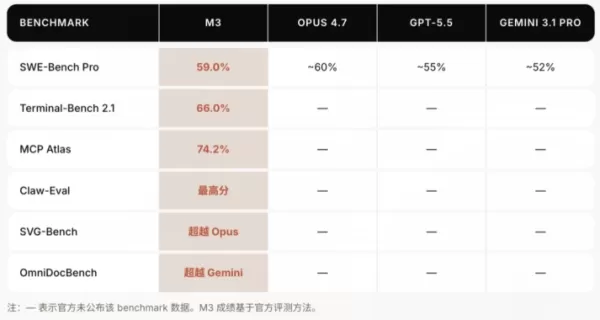
Der Wettlauf um große Sprachmodelle spitzt sich weiter zu: Das KI-Startup MiniMax hat kürzlich sein neues Flaggschiff-Modell M3 vorgestellt. Den Benchmark-Ergebnissen aus dem technischen Bericht zufolge liefert das Modell eine beeindruckende Leistung: Bei Tests, die reale Aufgaben aus der Softwareentwicklung simulieren, erzielte es 59 % und übertraf damit GPT-5.5 und näherte sich Opus4.7 an. Zudem bietet es die Verarbeitung von Kontexten mit einer Million Token sowie native multimodale Fähigkeiten. Trotz dieser starken technischen Erfolge hat die Markteinführung jedoch erhebliche Kritik seitens der Entwickler-Community ausgelöst, wobei besonders harte Kritik in chinesischen Online-Foren laut wurde.
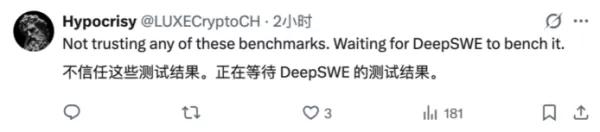
Ein Hauptgrund für die Skepsis ist die Bewertungsmethodik. Technische Details zeigen, dass M3 „Claude Code“ – ein Konkurrenzmodell – als Bewertungsframework für seine Tests der Programmierfähigkeiten verwendet hat. Zwar ist es gängige Praxis, bestehende Toolchains für die Bewertung von Agenten zu nutzen, doch Kritiker bemängeln, dass MiniMax sein eigenes Modell im Wesentlichen anhand des Frameworks eines Konkurrenten getestet und direkt hohe Punktzahlen für sich beansprucht habe, wobei es sich in öffentlichen Werbeaktionen mit eben diesem Konkurrenten verglichen habe. Viele Entwickler bezeichnen diesen Ansatz als unaufrichtig, da er es erschwert, die nativen Fähigkeiten des Modells von den durch das Framework bereitgestellten Verbesserungen zu unterscheiden.
Ein weiterer Streitpunkt ist die Aufrichtigkeit des Open-Source-Engagements. Im Gegensatz zu anderen Anbietern, die Open-Source-Modelle mit vollständigen Gewichten veröffentlichen, hat MiniMax weder die Größe von M3 offengelegt noch dessen Gewichte bereitgestellt. Das Unternehmen erklärte lediglich, es werde das Modell innerhalb von zehn Tagen als Open Source veröffentlichen, und bot zum Start lediglich API-Zugriff an. Da Reproduzierbarkeit und Überprüfbarkeit Kernwerte der Open-Source-Community sind, hat die Werbung für Open Source bei gleichzeitiger Zurückhaltung der Gewichte – wenn auch aus kommerzieller Sicht verständlich – eine Entwickler-Community verprellt, die Transparenz und Praxistauglichkeit erwartet.
Was Vielnutzer am meisten frustriert hat, ist die plötzliche Änderung der Abrechnungsregeln. Zuvor war MiniMax für seine großzügigen Nutzungslimits bekannt, bei denen die Beschränkung nach der Anzahl der Anfragen erfolgte, ohne monatliche Token-Obergrenze. Mit der Veröffentlichung von M3 führte das Unternehmen einen neuen tokenbasierten Tarif ein, bei dem nach Gesamtvolumen abgerechnet wird. Während offiziell behauptet wird, dass der Plus-Tarif ein gutes Preis-Leistungs-Verhältnis bei den Token biete, stellen Vielnutzer – insbesondere diejenigen, die mit Kontexten im Millionenbereich arbeiten – fest, dass jeder Aufruf eine große Menge verbraucht und die Paketkontingente schnell erschöpft sind. Dies hat zu weit verbreiteten Beschwerden seitens langjähriger Nutzer geführt.
Abgesehen von den operativen Kontroversen weist M3 auf architektonischer Ebene durchaus bemerkenswerte Innovationen auf. Es führt einen selbst entwickelten „Sparse-Attention“-Mechanismus namens MSA (MiniMax Sparse Attention) ein, der die quadratische Rechenexplosion traditioneller Transformers abmildert, indem er hochpräzise Blockpartitionierung und Sparsifizierung auf Schlüssel-Wert-Paare anwendet. Auf der Ebene der Low-Level-Operatoren nutzt das Modell eine neuartige Aggregationsberechnungsmethode, die die Kontinuität des Speicherzugriffs verbessert und Geschwindigkeiten erreicht, die viermal schneller sind als die des Open-Source-Modells „Flash-Sparse-Attention“. Dadurch steigert M3 die Geschwindigkeiten bei der Vorwärtsausbreitung und der Dekodierung in Kontexten mit einer Million Token um das 9-fache bzw. das 15-fache und reduziert den Rechenaufwand pro Token auf die Hälfte des Wertes der Vorgängergeneration.
Verwandter Artikel
 Meta möchte, dass Ihr nächstes Gadget mit Muse-Technologie ausgestattet ist
Metas Muse, ein KI-Assistent, der Buchungen für Reisen, Formularübermittlungen und Einkäufe übernimmt, hat eine weit verbreitete Akzeptanz gefunden, doch eine neue Initiative könnte insbesondere Entwickler und Hardware-Enthusiasten interessieren.Am
Wan-Streamer v0.2 bietet ultra-niedrige Latenz für KI-Chats
Da sich die moderne Technologie rasch weiterentwickelt, wird die Interaktion zwischen Mensch und KI immer häufiger. Traditionelle Videoanrufe kämpfen oft mit Verzögerungen, Latenzzeiten und einer Synchronisationslücke zwischen Audio und Video. Wan-St
Meta schließt sich TSMC und Micron an, um neue Server mit alter Speicherhardware auszustatten
Während die Einführung künstlicher Intelligenz weltweit voranschreitet, herrscht bei dem nächsten Generation DDR5-Speicher eine kritische Knappheit. Um Verzögerungen beim Aufbau von KI-Rechenzentren zu vermeiden, hat Meta mit Branchenführern wie TSMC
Empfehlungen zu verwandten Spezialthemen
Design & Kunst
 Die besten KI-Illustrationstools: Redaktionelle Szenen und Cover-Grafiken schneller erstellen
Die besten und am besten bewerteten KI-Illustrationstools 2026: Unsere sorgfältig zusammengestellte Liste enthält die leistungsstärksten Tools, mit denen Sie im Handumdrehen atemberaubende redaktionelle Szenen und auffällige Cover-Grafiken erstellen können. Jede Option wurde strengen Praxistests unterzogen und wird im Vergleich zwischen kostenlosen und kostenpflichtigen Versionen vorgestellt, damit Sie die perfekte Lösung für Ihren Arbeitsablauf finden können. Probieren Sie diese unverzichtbaren Lösungen noch heute aus, um Ihren KI-Vorteil zu nutzen und Ihre kreative Produktivität zu steigern. Entdecken Sie sie jetzt auf XIX.AI.
 10 Tools
 xix.ai
Bildung und Lernen
Die besten KI-Nachhilfelehrer für die Prüfungsvorbereitung: Üben Sie Mathematik, Naturwissenschaften und Englisch
Die besten und am besten bewerteten KI-Nachhilfetools für die Prüfungsvorbereitung des Jahres 2026 finden Sie hier auf XIX.AI! Unsere sorgfältig zusammengestellte Liste enthält leistungsstarke, bahnbrechende Tools, die einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, Tests aus der Praxis sowie wöchentlich aktualisierte Rankings bieten. Sie helfen Ihnen dabei, Ihre Schreibeffizienz zu steigern, das Erlernen komplexer Themen zu vereinfachen und Ihr akademisches Potenzial voll auszuschöpfen. Entdecken Sie jetzt Ihr perfektes Tool zur Prüfungsvorbereitung und legen Sie noch heute los, um Ihren KI-Vorteil zu nutzen!
10 Tools
xix.ai
Finanzen
KI-Budgetplanungstools für das persönliche Geldmanagement
2026 Neueste Besten Top-Bewertete KI-Budgetplanungs-Tools für persönliches Geldmanagement sind hier auf XIX.AI! Diese kuratierte Sammlung bietet leistungsstarke, revolutionäre Lösungen, die Ihnen helfen, reale Tests durchzuführen, Ausgaben Gewohnheiten zu verstehen und personalisierte Pläne zu erstellen, um die Produktivität zu steigern. Genießen Sie einen kostenlosen vs. bezahlten Vergleich sowie detaillierte Rankings. Unbedingt auszuprobierende Tools, die darauf ausgelegt sind, das Geldmanagement zu vereinfachen und Ihre KI-Vorteile freizuschalten. Entdecken Sie jetzt!
11 Tools
xix.ai
Gesundheit Wellness
KI-gestützte Schlafüberwachungsassistenten: Verbessern Sie Ihre Erholung durch bessere Gewohnheiten vor dem Schlafengehen
2026 – Die neuesten, besten und am höchsten bewerteten AI-Geräte zur Schlafüberwachung, sorgfältig ausgewählt für eine optimale Erholung. Dieser vollständig aktualisierte wöchentliche Leitfaden präsentiert leistungsstarke Tools mit praktischen Tests, einem Vergleich von kostenlosen und kostenpflichtigen Optionen sowie detaillierten Ranglisten, um Ihnen die beste Lösung zu zeigen, die die Schlafqualität verbessert und bessere Gewohnheiten zum Zubettgehen fördert. Entdecken Sie ihn jetzt auf XIX.AI, um Ihren Vorteil durch KI zu nutzen.
10 Tools
xix.ai
Datenanalyse
KI-gestützte SQL-Copilots für Produkt- und Umsatzanalysen
Die besten und am besten bewerteten KI-SQL-Copilots für Produkt- und Umsatzanalysen im Jahr 2026! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die anhand wöchentlich aktualisierter Rankings in der Praxis getestet werden. Diese Tools helfen Anwendern dabei, ihre Produktivität erheblich zu steigern, indem sie die Datenanalyse beschleunigen, komplexe Abfragen optimieren und präzise Erkenntnisse liefern, um intelligentere Geschäftsentscheidungen zu ermöglichen. Entdecken Sie jetzt das perfekte Tool, um Ihren KI-Vorteil voll auszuschöpfen!
14 Tools
xix.ai
Bildung und Lernen
Die besten KI-Hausaufgabenhelfer, die wirklich etwas vermitteln: Lerne Konzepte, nicht nur Antworten
2026: Die aktuell besten und am besten bewerteten KI-Hausaufgabenhelfer, die nicht nur Antworten liefern, sondern auch Kernkonzepte vermitteln – leistungsstarke Tools für Schüler und Studenten. Eine kuratierte Liste, die Sie unbedingt ausprobieren sollten. Wöchentlich aktualisiert. Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten. Praxistests. Genaue Rankings, die Ihnen helfen, Ihr volles Lernpotenzial auszuschöpfen. Entdecken Sie jetzt das perfekte Tool für intelligenteres Lernen.
10 Tools
xix.ai

 Kommentare (0)
Der Wettlauf um große Sprachmodelle spitzt sich weiter zu: Das KI-Startup MiniMax hat kürzlich sein neues Flaggschiff-Modell M3 vorgestellt. Den Benchmark-Ergebnissen aus dem technischen Bericht zufolge liefert das Modell eine beeindruckende Leistung: Bei Tests, die reale Aufgaben aus der Softwareentwicklung simulieren, erzielte es 59 % und übertraf damit GPT-5.5 und näherte sich Opus4.7 an. Zudem bietet es die Verarbeitung von Kontexten mit einer Million Token sowie native multimodale Fähigkeiten. Trotz dieser starken technischen Erfolge hat die Markteinführung jedoch erhebliche Kritik seitens der Entwickler-Community ausgelöst, wobei besonders harte Kritik in chinesischen Online-Foren laut wurde.
Ein Hauptgrund für die Skepsis ist die Bewertungsmethodik. Technische Details zeigen, dass M3 „Claude Code“ – ein Konkurrenzmodell – als Bewertungsframework für seine Tests der Programmierfähigkeiten verwendet hat. Zwar ist es gängige Praxis, bestehende Toolchains für die Bewertung von Agenten zu nutzen, doch Kritiker bemängeln, dass MiniMax sein eigenes Modell im Wesentlichen anhand des Frameworks eines Konkurrenten getestet und direkt hohe Punktzahlen für sich beansprucht habe, wobei es sich in öffentlichen Werbeaktionen mit eben diesem Konkurrenten verglichen habe. Viele Entwickler bezeichnen diesen Ansatz als unaufrichtig, da er es erschwert, die nativen Fähigkeiten des Modells von den durch das Framework bereitgestellten Verbesserungen zu unterscheiden.
Ein weiterer Streitpunkt ist die Aufrichtigkeit des Open-Source-Engagements. Im Gegensatz zu anderen Anbietern, die Open-Source-Modelle mit vollständigen Gewichten veröffentlichen, hat MiniMax weder die Größe von M3 offengelegt noch dessen Gewichte bereitgestellt. Das Unternehmen erklärte lediglich, es werde das Modell innerhalb von zehn Tagen als Open Source veröffentlichen, und bot zum Start lediglich API-Zugriff an. Da Reproduzierbarkeit und Überprüfbarkeit Kernwerte der Open-Source-Community sind, hat die Werbung für Open Source bei gleichzeitiger Zurückhaltung der Gewichte – wenn auch aus kommerzieller Sicht verständlich – eine Entwickler-Community verprellt, die Transparenz und Praxistauglichkeit erwartet.
Was Vielnutzer am meisten frustriert hat, ist die plötzliche Änderung der Abrechnungsregeln. Zuvor war MiniMax für seine großzügigen Nutzungslimits bekannt, bei denen die Beschränkung nach der Anzahl der Anfragen erfolgte, ohne monatliche Token-Obergrenze. Mit der Veröffentlichung von M3 führte das Unternehmen einen neuen tokenbasierten Tarif ein, bei dem nach Gesamtvolumen abgerechnet wird. Während offiziell behauptet wird, dass der Plus-Tarif ein gutes Preis-Leistungs-Verhältnis bei den Token biete, stellen Vielnutzer – insbesondere diejenigen, die mit Kontexten im Millionenbereich arbeiten – fest, dass jeder Aufruf eine große Menge verbraucht und die Paketkontingente schnell erschöpft sind. Dies hat zu weit verbreiteten Beschwerden seitens langjähriger Nutzer geführt.
Abgesehen von den operativen Kontroversen weist M3 auf architektonischer Ebene durchaus bemerkenswerte Innovationen auf. Es führt einen selbst entwickelten „Sparse-Attention“-Mechanismus namens MSA (MiniMax Sparse Attention) ein, der die quadratische Rechenexplosion traditioneller Transformers abmildert, indem er hochpräzise Blockpartitionierung und Sparsifizierung auf Schlüssel-Wert-Paare anwendet. Auf der Ebene der Low-Level-Operatoren nutzt das Modell eine neuartige Aggregationsberechnungsmethode, die die Kontinuität des Speicherzugriffs verbessert und Geschwindigkeiten erreicht, die viermal schneller sind als die des Open-Source-Modells „Flash-Sparse-Attention“. Dadurch steigert M3 die Geschwindigkeiten bei der Vorwärtsausbreitung und der Dekodierung in Kontexten mit einer Million Token um das 9-fache bzw. das 15-fache und reduziert den Rechenaufwand pro Token auf die Hälfte des Wertes der Vorgängergeneration.








 Meta möchte, dass Ihr nächstes Gadget mit Muse-Technologie ausgestattet ist
Metas Muse, ein KI-Assistent, der Buchungen für Reisen, Formularübermittlungen und Einkäufe übernimmt, hat eine weit verbreitete Akzeptanz gefunden, doch eine neue Initiative könnte insbesondere Entwickler und Hardware-Enthusiasten interessieren.Am
 Wan-Streamer v0.2 bietet ultra-niedrige Latenz für KI-Chats
Da sich die moderne Technologie rasch weiterentwickelt, wird die Interaktion zwischen Mensch und KI immer häufiger. Traditionelle Videoanrufe kämpfen oft mit Verzögerungen, Latenzzeiten und einer Synchronisationslücke zwischen Audio und Video. Wan-St
 Meta schließt sich TSMC und Micron an, um neue Server mit alter Speicherhardware auszustatten
Während die Einführung künstlicher Intelligenz weltweit voranschreitet, herrscht bei dem nächsten Generation DDR5-Speicher eine kritische Knappheit. Um Verzögerungen beim Aufbau von KI-Rechenzentren zu vermeiden, hat Meta mit Branchenführern wie TSMC

Die besten und am besten bewerteten KI-Illustrationstools 2026: Unsere sorgfältig zusammengestellte Liste enthält die leistungsstärksten Tools, mit denen Sie im Handumdrehen atemberaubende redaktionelle Szenen und auffällige Cover-Grafiken erstellen können. Jede Option wurde strengen Praxistests unterzogen und wird im Vergleich zwischen kostenlosen und kostenpflichtigen Versionen vorgestellt, damit Sie die perfekte Lösung für Ihren Arbeitsablauf finden können. Probieren Sie diese unverzichtbaren Lösungen noch heute aus, um Ihren KI-Vorteil zu nutzen und Ihre kreative Produktivität zu steigern. Entdecken Sie sie jetzt auf XIX.AI.
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Nachhilfetools für die Prüfungsvorbereitung des Jahres 2026 finden Sie hier auf XIX.AI! Unsere sorgfältig zusammengestellte Liste enthält leistungsstarke, bahnbrechende Tools, die einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, Tests aus der Praxis sowie wöchentlich aktualisierte Rankings bieten. Sie helfen Ihnen dabei, Ihre Schreibeffizienz zu steigern, das Erlernen komplexer Themen zu vereinfachen und Ihr akademisches Potenzial voll auszuschöpfen. Entdecken Sie jetzt Ihr perfektes Tool zur Prüfungsvorbereitung und legen Sie noch heute los, um Ihren KI-Vorteil zu nutzen!
10 Tools
xix.ai

2026 Neueste Besten Top-Bewertete KI-Budgetplanungs-Tools für persönliches Geldmanagement sind hier auf XIX.AI! Diese kuratierte Sammlung bietet leistungsstarke, revolutionäre Lösungen, die Ihnen helfen, reale Tests durchzuführen, Ausgaben Gewohnheiten zu verstehen und personalisierte Pläne zu erstellen, um die Produktivität zu steigern. Genießen Sie einen kostenlosen vs. bezahlten Vergleich sowie detaillierte Rankings. Unbedingt auszuprobierende Tools, die darauf ausgelegt sind, das Geldmanagement zu vereinfachen und Ihre KI-Vorteile freizuschalten. Entdecken Sie jetzt!
11 Tools
xix.ai

2026 – Die neuesten, besten und am höchsten bewerteten AI-Geräte zur Schlafüberwachung, sorgfältig ausgewählt für eine optimale Erholung. Dieser vollständig aktualisierte wöchentliche Leitfaden präsentiert leistungsstarke Tools mit praktischen Tests, einem Vergleich von kostenlosen und kostenpflichtigen Optionen sowie detaillierten Ranglisten, um Ihnen die beste Lösung zu zeigen, die die Schlafqualität verbessert und bessere Gewohnheiten zum Zubettgehen fördert. Entdecken Sie ihn jetzt auf XIX.AI, um Ihren Vorteil durch KI zu nutzen.
10 Tools
xix.ai

Die besten und am besten bewerteten KI-SQL-Copilots für Produkt- und Umsatzanalysen im Jahr 2026! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die anhand wöchentlich aktualisierter Rankings in der Praxis getestet werden. Diese Tools helfen Anwendern dabei, ihre Produktivität erheblich zu steigern, indem sie die Datenanalyse beschleunigen, komplexe Abfragen optimieren und präzise Erkenntnisse liefern, um intelligentere Geschäftsentscheidungen zu ermöglichen. Entdecken Sie jetzt das perfekte Tool, um Ihren KI-Vorteil voll auszuschöpfen!
14 Tools
xix.ai

2026: Die aktuell besten und am besten bewerteten KI-Hausaufgabenhelfer, die nicht nur Antworten liefern, sondern auch Kernkonzepte vermitteln – leistungsstarke Tools für Schüler und Studenten. Eine kuratierte Liste, die Sie unbedingt ausprobieren sollten. Wöchentlich aktualisiert. Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten. Praxistests. Genaue Rankings, die Ihnen helfen, Ihr volles Lernpotenzial auszuschöpfen. Entdecken Sie jetzt das perfekte Tool für intelligenteres Lernen.
10 Tools
xix.ai












