


 首页
京东云发布 MiniMax M3 大模型,标志着推理效率的重大飞跃
京东云的 JoyBuilder 平台已集成新发布的 MiniMax M3 模型,使其在发布后即可供用户使用。
此次更新重点提升了推理性能。平台利用其专有的推理框架,结合了 PD 分离、KV Cache 和推测性采样等高级优化技术。
这些底层技术协同作用,提升了推理吞吐量和响应效率,为开发者提供更流畅的体验,并加速大模型在真实业务场景中的落地应用。
相关文章
 600B 稀疏 MoE 激活 27B,提升开源旗舰产品的性价比
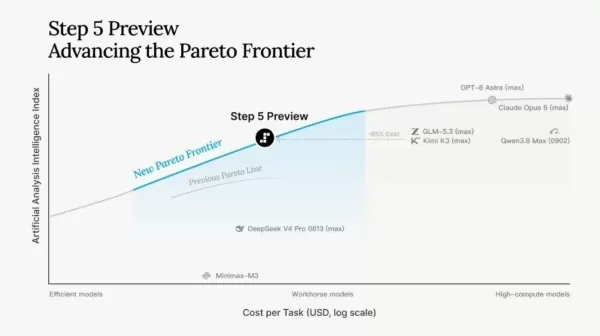
Step 5 Preview,最新的旗舰基础模型,现已正式可用。其目标明确:一个专为现实世界智能体(Agentic)任务设计的主模型。它解决了人工智能领域长期存在的“帕累托问题”,即能力、效率和成本往往相互冲突。历史上,某一领域的进步通常需要牺牲其他领域。然而,推进帕累托前沿并非消除权衡,而是通过创新设计扩展整个边界。此次迭代采用了稀疏混合专家(MoE)架构。Step 5 Preview 包含 6000 亿参数,每次推理仅激活 270 亿参数。它原生支持高达一百万 token 的上下文窗口,并能
英伟达的Vera芯片:黄仁勋希望你注意的2000亿美元赌注
Nvidia Vera 芯片在财报超出预期时很少占据头条,但它理应获得关注。第一季度营收达到 816.2 亿美元——超过分析师预估的 788.6 亿美元,第二季度指引为 910 亿美元,远高于华尔街预估的 868.4 亿美元,这些数字正如 Nvidia 的数据一贯所做的那样:引人注目。然而,在首席执行官黄仁勋的分析师电话会议中,有一个比又一个季度业绩超预期更具战略意义的披露。黄仁勋透露,Nvidia 的新款 Vera 中央处理器将开启一个 2000 亿美元的市场,这与 2025 年至 2027
明堂智能发布面向边缘设备的 MiniCPM-V 4.7,在 3GB 内存下实现每秒 13+ 个 token 的处理速度
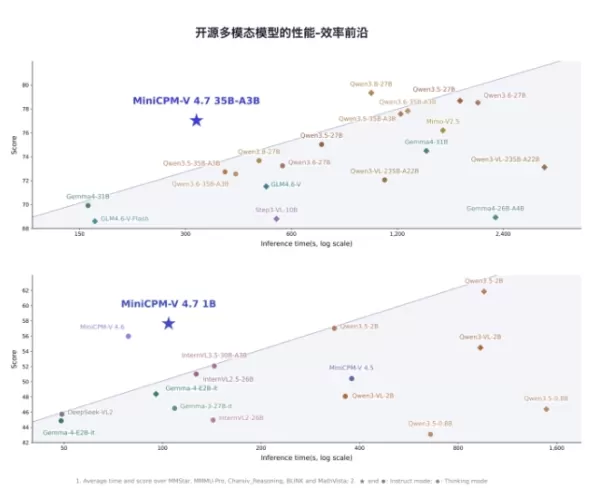
明势智能发布了其最新的端侧多模态大模型 MiniCPM-V 4.7,提供两种配置:35B-A3B 和 1B。其中,35B-A3B 变体是 MiniCPM-V 系列中的首个混合专家(MoE)模型,利用专有的“前瞻性专家调度”技术,在端侧设备上实现无损且流畅的推理,成为首个无需依赖云端即可高效运行的开源 MoE 模型。其最引人注目的指标是性能表现:在 iPhone 17 Pro Max 上,该模型仅消耗 3GB 内存,同时解码速度超过每秒 13 个词元。这种高效性使得在高端智能手机上进行本地多模态推
相关专题推荐
设计与艺术
 顶级AI插画工具:更快地创作编辑类场景和封面插图
2026年最新高评分AI插画工具:我们精心挑选的这份清单汇集了功能强大的顶级工具,助您快速创作令人惊艳的编辑场景和引人注目的封面艺术。每款工具都经过了严格的实际测试,并提供了免费版与付费版的对比,帮助您找到最适合您工作流程的工具。 立即尝试这些必试解决方案,释放您的AI优势,提升创作效率。立即访问 XIX.AI 探索更多。
 10 个工具
 xix.ai
教育与学习
备考首选的顶尖AI辅导老师:练习数学、科学和英语
2026年最新、评分最高的考试备考AI辅导工具现已登陆XIX.AI!我们精心筛选的这份清单汇集了多款功能强大、颠覆传统的工具,提供免费与付费版本的对比、实际测试以及每周更新的排行榜。它们能帮助你提升写作效率、简化复杂主题的学习,并释放你的学术潜能。 立即探索,发现最适合您的备考工具,今天就开始创作,释放您的AI优势!
10 个工具
xix.ai
金融
用于个人财务管理的 AI 预算规划工具
2026 年最新最佳顶级评分 AI 预算规划工具,专为个人财务管理打造,现已登陆 XIX.AI!本精选合集收录了强大且具颠覆性的解决方案,助您开展实际测试、理解消费习惯,并制定个性化计划以提升生产力。享受免费与付费版的对比及详细排名。这些必试工具旨在简化财务管理,助您释放 AI 优势。立即探索!
11 个工具
xix.ai
健康养生
AI睡眠追踪助手:通过养成更好的睡前习惯来促进身体恢复
2026年最新精选高评分AI睡眠追踪助手,助您实现最佳恢复效果。这份全面更新的每周指南汇集了强大的工具,提供实际测试结果、免费与付费版本对比以及详细排名,助您找到必试的解决方案,从而提升睡眠质量并养成更好的就寝习惯。 立即访问 XIX.AI,解锁您的AI优势。
10 个工具
xix.ai
数据分析
用于产品和收入分析的 AI SQL 辅助工具
2026年最新、最受欢迎、评分最高的AI SQL辅助工具,助力产品与营收分析! XIX.AI 精心遴选了一系列功能强大、颠覆性的必试工具,这些工具均经过每周更新的排名体系进行实战测试。它们能通过加速数据分析、简化复杂查询并生成精准洞察,帮助用户显著提升工作效率,从而推动更明智的商业决策。立即探索,发现最适合您的工具,释放您的AI优势!
14 个工具
xix.ai
教育与学习
最佳的、兼具教学功能的AI作业助手:学习概念,而不仅仅是答案
2026年最新最佳高评分AI作业助手:不仅提供答案,更传授核心概念。专为学生打造的强大工具,精选必试清单,每周更新,免费与付费版本对比,真实使用测试,精准排名,助您充分释放学习潜能。立即探索,发现最适合您的工具,让学习更高效。
10 个工具
xix.ai

 评论 (0)
0/500
京东云的 JoyBuilder 平台已集成新发布的 MiniMax M3 模型,使其在发布后即可供用户使用。
此次更新重点提升了推理性能。平台利用其专有的推理框架,结合了 PD 分离、KV Cache 和推测性采样等高级优化技术。
这些底层技术协同作用,提升了推理吞吐量和响应效率,为开发者提供更流畅的体验,并加速大模型在真实业务场景中的落地应用。








 600B 稀疏 MoE 激活 27B,提升开源旗舰产品的性价比
Step 5 Preview,最新的旗舰基础模型,现已正式可用。其目标明确:一个专为现实世界智能体(Agentic)任务设计的主模型。它解决了人工智能领域长期存在的“帕累托问题”,即能力、效率和成本往往相互冲突。历史上,某一领域的进步通常需要牺牲其他领域。然而,推进帕累托前沿并非消除权衡,而是通过创新设计扩展整个边界。此次迭代采用了稀疏混合专家(MoE)架构。Step 5 Preview 包含 6000 亿参数,每次推理仅激活 270 亿参数。它原生支持高达一百万 token 的上下文窗口,并能
 英伟达的Vera芯片:黄仁勋希望你注意的2000亿美元赌注
Nvidia Vera 芯片在财报超出预期时很少占据头条,但它理应获得关注。第一季度营收达到 816.2 亿美元——超过分析师预估的 788.6 亿美元,第二季度指引为 910 亿美元,远高于华尔街预估的 868.4 亿美元,这些数字正如 Nvidia 的数据一贯所做的那样:引人注目。然而,在首席执行官黄仁勋的分析师电话会议中,有一个比又一个季度业绩超预期更具战略意义的披露。黄仁勋透露,Nvidia 的新款 Vera 中央处理器将开启一个 2000 亿美元的市场,这与 2025 年至 2027
 明堂智能发布面向边缘设备的 MiniCPM-V 4.7,在 3GB 内存下实现每秒 13+ 个 token 的处理速度
明势智能发布了其最新的端侧多模态大模型 MiniCPM-V 4.7,提供两种配置:35B-A3B 和 1B。其中,35B-A3B 变体是 MiniCPM-V 系列中的首个混合专家(MoE)模型,利用专有的“前瞻性专家调度”技术,在端侧设备上实现无损且流畅的推理,成为首个无需依赖云端即可高效运行的开源 MoE 模型。其最引人注目的指标是性能表现:在 iPhone 17 Pro Max 上,该模型仅消耗 3GB 内存,同时解码速度超过每秒 13 个词元。这种高效性使得在高端智能手机上进行本地多模态推
2026年最新高评分AI插画工具:我们精心挑选的这份清单汇集了功能强大的顶级工具,助您快速创作令人惊艳的编辑场景和引人注目的封面艺术。每款工具都经过了严格的实际测试,并提供了免费版与付费版的对比,帮助您找到最适合您工作流程的工具。 立即尝试这些必试解决方案,释放您的AI优势,提升创作效率。立即访问 XIX.AI 探索更多。
10 个工具
xix.ai
2026年最新、评分最高的考试备考AI辅导工具现已登陆XIX.AI!我们精心筛选的这份清单汇集了多款功能强大、颠覆传统的工具,提供免费与付费版本的对比、实际测试以及每周更新的排行榜。它们能帮助你提升写作效率、简化复杂主题的学习,并释放你的学术潜能。 立即探索,发现最适合您的备考工具,今天就开始创作,释放您的AI优势!
10 个工具
xix.ai
2026 年最新最佳顶级评分 AI 预算规划工具,专为个人财务管理打造,现已登陆 XIX.AI!本精选合集收录了强大且具颠覆性的解决方案,助您开展实际测试、理解消费习惯,并制定个性化计划以提升生产力。享受免费与付费版的对比及详细排名。这些必试工具旨在简化财务管理,助您释放 AI 优势。立即探索!
11 个工具
xix.ai
2026年最新精选高评分AI睡眠追踪助手,助您实现最佳恢复效果。这份全面更新的每周指南汇集了强大的工具,提供实际测试结果、免费与付费版本对比以及详细排名,助您找到必试的解决方案,从而提升睡眠质量并养成更好的就寝习惯。 立即访问 XIX.AI,解锁您的AI优势。
10 个工具
xix.ai
2026年最新、最受欢迎、评分最高的AI SQL辅助工具,助力产品与营收分析! XIX.AI 精心遴选了一系列功能强大、颠覆性的必试工具,这些工具均经过每周更新的排名体系进行实战测试。它们能通过加速数据分析、简化复杂查询并生成精准洞察,帮助用户显著提升工作效率,从而推动更明智的商业决策。立即探索,发现最适合您的工具,释放您的AI优势!
14 个工具
xix.ai
2026年最新最佳高评分AI作业助手:不仅提供答案,更传授核心概念。专为学生打造的强大工具,精选必试清单,每周更新,免费与付费版本对比,真实使用测试,精准排名,助您充分释放学习潜能。立即探索,发现最适合您的工具,让学习更高效。
10 个工具
xix.ai












