


 Maison
JD Cloud dévoile le grand modèle MiniMax M3, marquant une avancée en matière d’efficacité de l’inférence
La plateforme JoyBuilder de JD Cloud a intégré le nouveau modèle MiniMax M3, le rendant immédiatement disponible pour les utilisateurs dès sa sortie.
Cette mise à jour met l’accent sur des performances d’inférence améliorées. La plateforme s’appuie sur son framework d’inférence propriétaire, en intégrant des techniques d’optimisation avancées telles que la séparation PD, le cache KV et l’échantillonnage spéculatif.
Ces technologies sous-jacentes agissent conjointement pour augmenter le débit d’inférence et l’efficacité des réponses, offrant aux développeurs une expérience plus fluide et accélérant l’adoption des grands modèles dans des applications commerciales concrètes.
Article connexe
 600B MoE Sparse active 27B, améliorant l'efficacité coût-performance du modèle phare open-source
Étape 5 Preview, le dernier modèle de fondation phare, est désormais officiellement disponible. Son objectif est clair : un modèle principal conçu pour les tâches Agentic du monde réel. Il répond au « problème de Pareto » de longue date en IA, où les
La puce Vera de Nvidia : le pari de 200 milliards de dollars que Jensen Huang veut que vous remarquiez
La puce Nvidia Vera attire rarement les gros titres lorsque les résultats dépassent les attentes, pourtant elle mérite d’être sous les projecteurs. Avec un chiffre d’affaires du premier trimestre atteignant 81,62 milliards de dollars américains – dép
MingTang Intelligent dévoile MiniCPM-V 4.7 pour les appareils edge, offrant plus de 13 tokens/s sur 3 Go de mémoire
Mingshi Intelligence a dévoilé son dernier modèle de langage multimodal de pointe côté edge, MiniCPM-V 4.7, disponible en deux configurations : 35B-A3B et 1B. La variante 35B-A3B marque le premier modèle Mixture of Experts (MoE) de la série MiniCPM-V
Recommandations de sujets spéciaux liés
Conception et art
 Les meilleurs outils d'illustration basés sur l'IA : créez plus rapidement des scènes éditoriales et des illustrations de couverture
Les meilleurs outils d'illustration IA de 2026 : notre sélection regroupe les outils les plus performants pour créer rapidement de superbes scènes éditoriales et des couvertures accrocheuses. Chaque option a été soumise à des tests rigoureux en conditions réelles ; nous vous proposons une comparaison entre les versions gratuites et payantes afin de vous aider à trouver celle qui correspond le mieux à votre flux de travail. Essayez dès aujourd’hui ces solutions incontournables pour exploiter pleinement le potentiel de l’IA et booster votre productivité créative. Découvrez-les dès maintenant sur XIX.AI.
 10 outils
 xix.ai
Éducation et apprentissage
Les meilleurs professeurs particuliers spécialisés en IA pour la préparation aux examens : entraînez-vous en maths, en sciences et en anglais
Les meilleurs tuteurs IA 2026 les mieux notés pour la préparation aux examens sont disponibles ici, sur XIX.AI ! Notre sélection comprend des outils puissants et révolutionnaires qui proposent une comparaison entre les versions gratuites et payantes, des tests concrets et des classements mis à jour chaque semaine. Ils vous aident à améliorer votre efficacité à l'écrit, à simplifier l'apprentissage de sujets complexes et à libérer votre potentiel académique. Découvrez dès maintenant l'outil de préparation aux examens qui vous convient le mieux et commencez à créer dès aujourd'hui pour exploiter pleinement les avantages de l'IA !
10 outils
xix.ai
Finance
Outils de planification budgétaire par IA pour la gestion personnelle des finances
2026 Derniers Meilleurs Outils de Planification Budgétaire par IA les mieux notés pour la gestion personnelle des finances sont ici sur XIX.AI ! Cette collection soigneusement sélectionnée propose des solutions puissantes et révolutionnaires qui vous aident à réaliser des tests concrets, à comprendre vos habitudes de dépenses et à créer des plans personnalisés pour améliorer votre productivité. Profitez d’une comparaison entre versions gratuites et payantes ainsi que de classements détaillés. Des outils incontournables conçus pour simplifier la gestion financière et exploiter pleinement votre avantage grâce à l’IA. Explorez dès maintenant !
11 outils
xix.ai
Santé et bien-être
Assistants de suivi du sommeil par l’IA : améliorez votre récupération grâce à de meilleures habitudes avant le coucher
2026 : Découvrez les meilleurs assistants de suivi du sommeil basés sur l’IA, hautement notés et récemment mis à jour, conçus pour une récupération optimale. Ce guide hebdomadaire entièrement actualisé présente des outils puissants qui offrent des tests en conditions réelles, des comparaisons entre versions gratuites et payantes, ainsi que des classements détaillés afin de vous aider à trouver la solution idéale pour améliorer la qualité du sommeil et favoriser de meilleures habitudes avant le coucher. Explorez-le dès maintenant sur XIX.AI pour tirer parti des avantages offerts par l’IA.
10 outils
xix.ai
Analyse des données
Copilotes SQL basés sur l'IA pour l'analyse des produits et du chiffre d'affaires
2026 : les meilleurs copilotes SQL IA les mieux notés pour l'analyse des produits et du chiffre d'affaires ! XIX.AI a sélectionné une gamme d’outils puissants et révolutionnaires à essayer absolument, qui sont soumis à des tests en conditions réelles via des classements mis à jour chaque semaine. Ces outils aident les utilisateurs à booster considérablement leur productivité en accélérant l’analyse des données, en simplifiant les requêtes complexes et en générant des informations précises permettant de prendre des décisions commerciales plus éclairées. Explorez-les dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer pleinement parti de l’IA !
14 outils
xix.ai
Éducation et apprentissage
Les meilleurs outils d'aide aux devoirs basés sur l'IA qui enseignent : apprenez les concepts, pas seulement les réponses
2026 : les meilleurs outils d'aide aux devoirs basés sur l'IA, les mieux notés, qui enseignent les concepts fondamentaux et ne se contentent pas de fournir des réponses. Des outils puissants pour les élèves. Une sélection incontournable à ne pas manquer. Mise à jour hebdomadaire. Comparaison entre les versions gratuites et payantes. Tests en conditions réelles. Classements précis pour vous aider à exploiter pleinement votre potentiel d'apprentissage. Explorez dès maintenant pour découvrir l'outil idéal qui vous permettra d'étudier plus efficacement.
10 outils
xix.ai

 commentaires (0)
La plateforme JoyBuilder de JD Cloud a intégré le nouveau modèle MiniMax M3, le rendant immédiatement disponible pour les utilisateurs dès sa sortie.
Cette mise à jour met l’accent sur des performances d’inférence améliorées. La plateforme s’appuie sur son framework d’inférence propriétaire, en intégrant des techniques d’optimisation avancées telles que la séparation PD, le cache KV et l’échantillonnage spéculatif.
Ces technologies sous-jacentes agissent conjointement pour augmenter le débit d’inférence et l’efficacité des réponses, offrant aux développeurs une expérience plus fluide et accélérant l’adoption des grands modèles dans des applications commerciales concrètes.








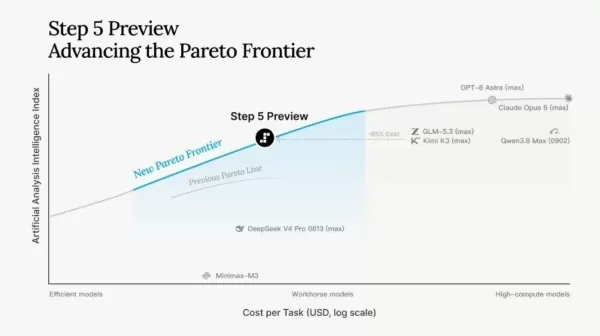 600B MoE Sparse active 27B, améliorant l'efficacité coût-performance du modèle phare open-source
Étape 5 Preview, le dernier modèle de fondation phare, est désormais officiellement disponible. Son objectif est clair : un modèle principal conçu pour les tâches Agentic du monde réel. Il répond au « problème de Pareto » de longue date en IA, où les
 La puce Vera de Nvidia : le pari de 200 milliards de dollars que Jensen Huang veut que vous remarquiez
La puce Nvidia Vera attire rarement les gros titres lorsque les résultats dépassent les attentes, pourtant elle mérite d’être sous les projecteurs. Avec un chiffre d’affaires du premier trimestre atteignant 81,62 milliards de dollars américains – dép
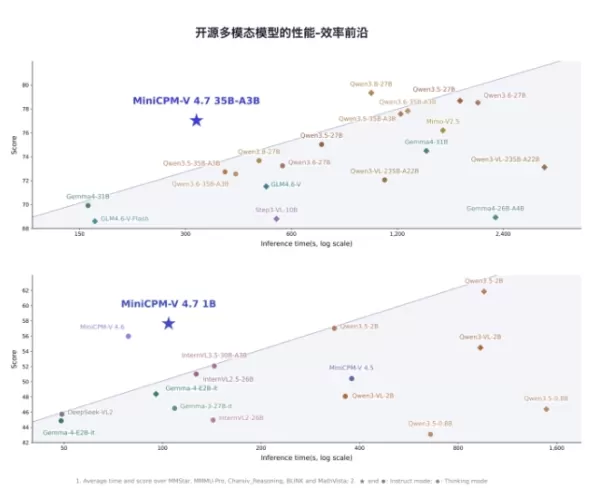 MingTang Intelligent dévoile MiniCPM-V 4.7 pour les appareils edge, offrant plus de 13 tokens/s sur 3 Go de mémoire
Mingshi Intelligence a dévoilé son dernier modèle de langage multimodal de pointe côté edge, MiniCPM-V 4.7, disponible en deux configurations : 35B-A3B et 1B. La variante 35B-A3B marque le premier modèle Mixture of Experts (MoE) de la série MiniCPM-V

Les meilleurs outils d'illustration IA de 2026 : notre sélection regroupe les outils les plus performants pour créer rapidement de superbes scènes éditoriales et des couvertures accrocheuses. Chaque option a été soumise à des tests rigoureux en conditions réelles ; nous vous proposons une comparaison entre les versions gratuites et payantes afin de vous aider à trouver celle qui correspond le mieux à votre flux de travail. Essayez dès aujourd’hui ces solutions incontournables pour exploiter pleinement le potentiel de l’IA et booster votre productivité créative. Découvrez-les dès maintenant sur XIX.AI.
10 outils
xix.ai

Les meilleurs tuteurs IA 2026 les mieux notés pour la préparation aux examens sont disponibles ici, sur XIX.AI ! Notre sélection comprend des outils puissants et révolutionnaires qui proposent une comparaison entre les versions gratuites et payantes, des tests concrets et des classements mis à jour chaque semaine. Ils vous aident à améliorer votre efficacité à l'écrit, à simplifier l'apprentissage de sujets complexes et à libérer votre potentiel académique. Découvrez dès maintenant l'outil de préparation aux examens qui vous convient le mieux et commencez à créer dès aujourd'hui pour exploiter pleinement les avantages de l'IA !
10 outils
xix.ai

2026 Derniers Meilleurs Outils de Planification Budgétaire par IA les mieux notés pour la gestion personnelle des finances sont ici sur XIX.AI ! Cette collection soigneusement sélectionnée propose des solutions puissantes et révolutionnaires qui vous aident à réaliser des tests concrets, à comprendre vos habitudes de dépenses et à créer des plans personnalisés pour améliorer votre productivité. Profitez d’une comparaison entre versions gratuites et payantes ainsi que de classements détaillés. Des outils incontournables conçus pour simplifier la gestion financière et exploiter pleinement votre avantage grâce à l’IA. Explorez dès maintenant !
11 outils
xix.ai

2026 : Découvrez les meilleurs assistants de suivi du sommeil basés sur l’IA, hautement notés et récemment mis à jour, conçus pour une récupération optimale. Ce guide hebdomadaire entièrement actualisé présente des outils puissants qui offrent des tests en conditions réelles, des comparaisons entre versions gratuites et payantes, ainsi que des classements détaillés afin de vous aider à trouver la solution idéale pour améliorer la qualité du sommeil et favoriser de meilleures habitudes avant le coucher. Explorez-le dès maintenant sur XIX.AI pour tirer parti des avantages offerts par l’IA.
10 outils
xix.ai

2026 : les meilleurs copilotes SQL IA les mieux notés pour l'analyse des produits et du chiffre d'affaires ! XIX.AI a sélectionné une gamme d’outils puissants et révolutionnaires à essayer absolument, qui sont soumis à des tests en conditions réelles via des classements mis à jour chaque semaine. Ces outils aident les utilisateurs à booster considérablement leur productivité en accélérant l’analyse des données, en simplifiant les requêtes complexes et en générant des informations précises permettant de prendre des décisions commerciales plus éclairées. Explorez-les dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer pleinement parti de l’IA !
14 outils
xix.ai

2026 : les meilleurs outils d'aide aux devoirs basés sur l'IA, les mieux notés, qui enseignent les concepts fondamentaux et ne se contentent pas de fournir des réponses. Des outils puissants pour les élèves. Une sélection incontournable à ne pas manquer. Mise à jour hebdomadaire. Comparaison entre les versions gratuites et payantes. Tests en conditions réelles. Classements précis pour vous aider à exploiter pleinement votre potentiel d'apprentissage. Explorez dès maintenant pour découvrir l'outil idéal qui vous permettra d'étudier plus efficacement.
10 outils
xix.ai












