


 Hogar
JD Cloud presenta el gran modelo MiniMax M3, marcando un salto en la eficiencia de inferencia
La plataforma JoyBuilder de JD Cloud ha integrado el recién lanzado modelo MiniMax M3, poniéndolo a disposición de los usuarios inmediatamente después de su lanzamiento.
Esta actualización se centra en mejorar el rendimiento de inferencia. La plataforma aprovecha su marco de inferencia propietario, incorporando técnicas avanzadas de optimización como la separación PD, KV Cache y muestreo especulativo.
Estas tecnologías subyacentes trabajan conjuntamente para aumentar el rendimiento de inferencia y la eficiencia de respuesta, ofreciendo a los desarrolladores una experiencia más fluida y acelerando la adopción de modelos grandes en aplicaciones empresariales reales.
Artículo relacionado
 Un ex ejecutivo de Spotify lanza una startup de bares de vinilo en Shibuya para redefinir las aplicaciones de música
A medida que la inteligencia artificial generativa sigue transformando el panorama creativo, una nueva oleada de startups está empoderando a los usuarios para producir música mediante indicaciones de IA, imitando el estilo de cualquier artista. A Vin
600B MoE disperso activa 27B, mejorando la rentabilidad del buque insignia de código abierto
El Paso 5 Preview, el último modelo de base insignia, ya está disponible oficialmente. Su propósito es claro: un modelo principal diseñado para tareas Agentic del mundo real. Aborda el largo tiempo "problema de Pareto" en la IA, donde la capacidad, l
El chip Vera de Nvidia: La apuesta de 200.000 millones de dólares que Jensen Huang quiere que notes
El chip Vera de Nvidia rara vez aparece en las portadas cuando los beneficios superan las expectativas, pero merece estar bajo los reflectores. Con unos ingresos del primer trimestre que alcanzaron los 81.620 millones de dólares, superando las estima
Recomendaciones de temas especiales relacionados
Diseño y Arte
 Las mejores herramientas de ilustración con IA: crea escenas editoriales y portadas más rápido
Las mejores herramientas de ilustración con IA de 2026: nuestra lista seleccionada incluye las mejores herramientas, diseñadas con gran potencia, para crear rápidamente impresionantes escenas editoriales y llamativas portadas. Cada opción ha sido sometida a rigurosas pruebas en condiciones reales y ofrece una comparación entre las versiones gratuitas y de pago para ayudarte a encontrar la que mejor se adapte a tu flujo de trabajo. Prueba hoy mismo estas soluciones imprescindibles para sacar el máximo partido a la IA y potenciar tu productividad creativa. Descúbrelas ahora en XIX.AI.
 10 herramientas
 xix.ai
Educación y aprendizaje
Los mejores profesores particulares de IA para la preparación de exámenes: practica matemáticas, ciencias e inglés
¡Ya están aquí, en XIX.AI, los mejores tutores de IA para la preparación de exámenes de 2026, con las mejores valoraciones! Nuestra lista seleccionada incluye potentes herramientas revolucionarias que ofrecen comparativas entre versiones gratuitas y de pago, pruebas reales y clasificaciones actualizadas semanalmente. Te ayudan a mejorar tu eficiencia a la hora de escribir, a simplificar el aprendizaje de temas complejos y a desarrollar todo tu potencial académico. ¡Explora ahora mismo para descubrir tu herramienta perfecta de preparación de exámenes y empieza a crear hoy mismo para sacar partido a tu ventaja con la IA!
10 herramientas
xix.ai
Finanzas
Herramientas de planificación presupuestaria con IA para la gestión personal del dinero
2026 Últimas Mejores Herramientas de Planificación Presupuestaria con IA Mejor Valoradas para la Gestión Personal del Dinero están aquí en XIX.AI. Esta colección seleccionada presenta soluciones poderosas y transformadoras que te ayudan a realizar pruebas en el mundo real, comprender tus hábitos de gasto y crear planes personalizados para aumentar la productividad. Disfruta de una comparación entre versiones gratuitas y de pago junto con clasificaciones detalladas. Herramientas imprescindibles diseñadas para simplificar la gestión del dinero y desbloquear tu ventaja con IA. ¡Explóralas ahora!
11 herramientas
xix.ai
Salud y bienestar
Asistentes de seguimiento del sueño basados en IA: mejora tu recuperación con mejores hábitos a la hora de acostarte
Los mejores asistentes de seguimiento del sueño con IA de 2026, seleccionados para una recuperación óptima. Esta guía semanal totalmente actualizada incluye potentes herramientas que ofrecen pruebas en condiciones reales, comparativas entre opciones gratuitas y de pago, y clasificaciones detalladas para ayudarte a encontrar la solución imprescindible que mejora la calidad del sueño y fomenta mejores hábitos a la hora de acostarse. Descúbrelo ahora en XIX.AI y aprovecha todas las ventajas de la IA.
10 herramientas
xix.ai
Análisis de datos
Copilotos de IA y SQL para el análisis de productos e ingresos
¡Los mejores copilotos de IA para SQL mejor valorados de 2026 para el análisis de productos e ingresos! XIX.AI ha seleccionado una potente colección de herramientas revolucionarias que no te puedes perder y que se someten a pruebas en el mundo real a través de clasificaciones que se actualizan semanalmente. Estas herramientas ayudan a los usuarios a aumentar significativamente su productividad al acelerar el análisis de datos, simplificar consultas complejas y generar información precisa para tomar decisiones empresariales más inteligentes. ¡Explora ahora mismo y descubre la herramienta perfecta para sacar el máximo partido a tu ventaja en IA!
14 herramientas
xix.ai
Educación y aprendizaje
Las mejores herramientas de IA para los deberes que realmente enseñan: aprende conceptos, no solo respuestas
2026: los mejores y más valorados asistentes de deberes con IA que enseñan conceptos básicos, no solo respuestas. Potentes herramientas para estudiantes. Una selección imprescindible que debes probar. Actualización semanal. Comparativa entre opciones gratuitas y de pago. Pruebas en el mundo real. Clasificaciones precisas para ayudarte a desarrollar todo tu potencial de aprendizaje. Explora ahora y descubre la herramienta perfecta para estudiar de forma más inteligente.
10 herramientas
xix.ai

 comentario (0)
0/500
La plataforma JoyBuilder de JD Cloud ha integrado el recién lanzado modelo MiniMax M3, poniéndolo a disposición de los usuarios inmediatamente después de su lanzamiento.
Esta actualización se centra en mejorar el rendimiento de inferencia. La plataforma aprovecha su marco de inferencia propietario, incorporando técnicas avanzadas de optimización como la separación PD, KV Cache y muestreo especulativo.
Estas tecnologías subyacentes trabajan conjuntamente para aumentar el rendimiento de inferencia y la eficiencia de respuesta, ofreciendo a los desarrolladores una experiencia más fluida y acelerando la adopción de modelos grandes en aplicaciones empresariales reales.








 Un ex ejecutivo de Spotify lanza una startup de bares de vinilo en Shibuya para redefinir las aplicaciones de música
A medida que la inteligencia artificial generativa sigue transformando el panorama creativo, una nueva oleada de startups está empoderando a los usuarios para producir música mediante indicaciones de IA, imitando el estilo de cualquier artista. A Vin
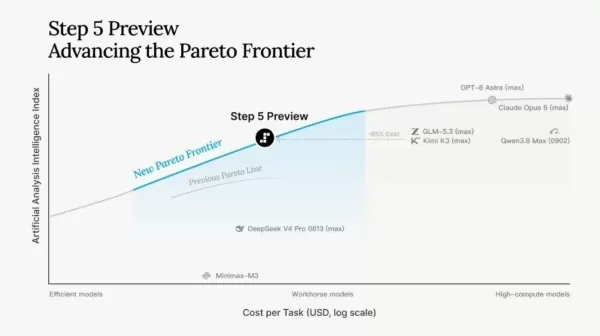 600B MoE disperso activa 27B, mejorando la rentabilidad del buque insignia de código abierto
El Paso 5 Preview, el último modelo de base insignia, ya está disponible oficialmente. Su propósito es claro: un modelo principal diseñado para tareas Agentic del mundo real. Aborda el largo tiempo "problema de Pareto" en la IA, donde la capacidad, l
 El chip Vera de Nvidia: La apuesta de 200.000 millones de dólares que Jensen Huang quiere que notes
El chip Vera de Nvidia rara vez aparece en las portadas cuando los beneficios superan las expectativas, pero merece estar bajo los reflectores. Con unos ingresos del primer trimestre que alcanzaron los 81.620 millones de dólares, superando las estima

Las mejores herramientas de ilustración con IA de 2026: nuestra lista seleccionada incluye las mejores herramientas, diseñadas con gran potencia, para crear rápidamente impresionantes escenas editoriales y llamativas portadas. Cada opción ha sido sometida a rigurosas pruebas en condiciones reales y ofrece una comparación entre las versiones gratuitas y de pago para ayudarte a encontrar la que mejor se adapte a tu flujo de trabajo. Prueba hoy mismo estas soluciones imprescindibles para sacar el máximo partido a la IA y potenciar tu productividad creativa. Descúbrelas ahora en XIX.AI.
10 herramientas
xix.ai

¡Ya están aquí, en XIX.AI, los mejores tutores de IA para la preparación de exámenes de 2026, con las mejores valoraciones! Nuestra lista seleccionada incluye potentes herramientas revolucionarias que ofrecen comparativas entre versiones gratuitas y de pago, pruebas reales y clasificaciones actualizadas semanalmente. Te ayudan a mejorar tu eficiencia a la hora de escribir, a simplificar el aprendizaje de temas complejos y a desarrollar todo tu potencial académico. ¡Explora ahora mismo para descubrir tu herramienta perfecta de preparación de exámenes y empieza a crear hoy mismo para sacar partido a tu ventaja con la IA!
10 herramientas
xix.ai

2026 Últimas Mejores Herramientas de Planificación Presupuestaria con IA Mejor Valoradas para la Gestión Personal del Dinero están aquí en XIX.AI. Esta colección seleccionada presenta soluciones poderosas y transformadoras que te ayudan a realizar pruebas en el mundo real, comprender tus hábitos de gasto y crear planes personalizados para aumentar la productividad. Disfruta de una comparación entre versiones gratuitas y de pago junto con clasificaciones detalladas. Herramientas imprescindibles diseñadas para simplificar la gestión del dinero y desbloquear tu ventaja con IA. ¡Explóralas ahora!
11 herramientas
xix.ai

Los mejores asistentes de seguimiento del sueño con IA de 2026, seleccionados para una recuperación óptima. Esta guía semanal totalmente actualizada incluye potentes herramientas que ofrecen pruebas en condiciones reales, comparativas entre opciones gratuitas y de pago, y clasificaciones detalladas para ayudarte a encontrar la solución imprescindible que mejora la calidad del sueño y fomenta mejores hábitos a la hora de acostarse. Descúbrelo ahora en XIX.AI y aprovecha todas las ventajas de la IA.
10 herramientas
xix.ai

¡Los mejores copilotos de IA para SQL mejor valorados de 2026 para el análisis de productos e ingresos! XIX.AI ha seleccionado una potente colección de herramientas revolucionarias que no te puedes perder y que se someten a pruebas en el mundo real a través de clasificaciones que se actualizan semanalmente. Estas herramientas ayudan a los usuarios a aumentar significativamente su productividad al acelerar el análisis de datos, simplificar consultas complejas y generar información precisa para tomar decisiones empresariales más inteligentes. ¡Explora ahora mismo y descubre la herramienta perfecta para sacar el máximo partido a tu ventaja en IA!
14 herramientas
xix.ai

2026: los mejores y más valorados asistentes de deberes con IA que enseñan conceptos básicos, no solo respuestas. Potentes herramientas para estudiantes. Una selección imprescindible que debes probar. Actualización semanal. Comparativa entre opciones gratuitas y de pago. Pruebas en el mundo real. Clasificaciones precisas para ayudarte a desarrollar todo tu potencial de aprendizaje. Explora ahora y descubre la herramienta perfecta para estudiar de forma más inteligente.
10 herramientas
xix.ai












