


 首页
27B数学SOTA与3秒情感克隆:有道开源“紫月4”多模态及TTS引擎
网易有道近日宣布,其“孔子4”大模型已全面升级至4.0版本。如今,“孔子4”已实现全模态支持,可支持文本、图像和音频的集成交互。 有道还将其核心的多模态和文本转语音(TTS)模型开源,同时对翻译模型进行了深度技术改造,在质量和效率方面均有所提升。
该多模态模型在视觉和数学领域均达到了最先进水平(SOTA),在纯文本数学题上表现尤为出色
据公告称,这款拥有270亿参数的开源“孔子4号”多模态模型,已将基于视觉输入的数学处理能力提升至教育场景中的行业领先水平(SOTA)。 在同等规模的模型中,Confucius4 尤其擅长处理包含图表的高级视觉数学和物理问题。它在中文纯文本数学题上也取得了显著进步,准确率达到 81.4%,处于行业领先水平。
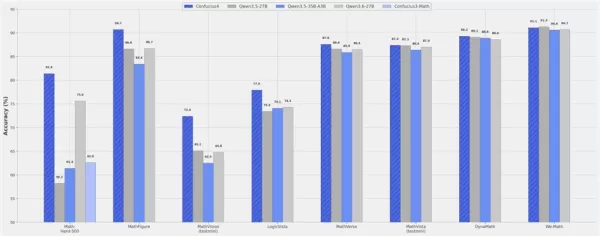
▲ 在同等规模的模型中,Confucius4 在多个视觉数学基准测试中均取得业界最佳成绩
图片来源:https://huggingface.co/netease-youdao/Confucius4
更具决定性的突破在于实际成本效益。据相关负责人介绍,该新模型采用了精炼的推理链重构方案。通过聚合海量高质量、简洁的推理样本进行深度优化,将推理链的输出长度压缩了43.2%。
这意味着它能够以更少的令牌和更短的推理路径更快地给出答案,从而显著降低企业及开发者在实际商业场景中的推理成本。
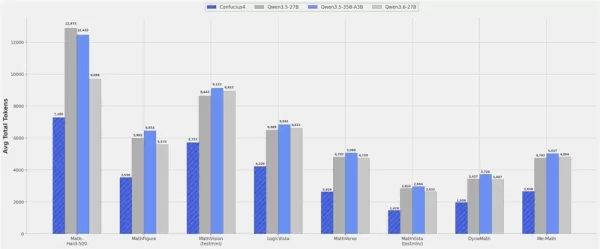
▲ Confucius4 在多个视觉数学基准测试中显著减少了输出令牌数量
图片来源:https://huggingface.co/netease-youdao/Confucius4
此外,Confucius4研究团队针对中国学生面临的实际作业、考试和解题场景对模型进行了深度优化。这使其能够应对真实的学习挑战,成为更具同理心的数字助手。
开源语音合成(TTS):支持14种语言,3秒内即可克隆原声,跨语言无口音问题
除多模态模型外,语音合成(TTS)引擎也已开源。该引擎基于前沿的“语音编码器 + 大型语言模型(LLM)”架构构建,为开发者和内容创作者提供了零样本、低门槛的语音克隆和情感合成能力。
目前,该引擎全面支持14种语言:中文、英语、日语、韩语、德语、法语、西班牙语、印尼语、意大利语、泰语、葡萄牙语、俄语、马来语和越南语。 该系统无需额外训练即可自然地在不同语言间转换说话者的声音,在保持声音一致性的同时,确保合成结果听起来像母语者一样流利自然,且在跨语言克隆过程中不会出现口音泄漏。
在语音克隆方面,Confucius4实现了完全的“上传即克隆”功能。用户只需提供任意音频素材,系统便能在三秒内复刻原始声音。 据公告称,该引擎在克隆任务上的准确率超过97%,克隆声音与原始声音的相似度超过85%。它在保留说话者独特嗓音特征的同时,还能准确再现其情感语调,其综合能力位居该领域前列。
此外,该开源模型在真实的多语言场景中展现出极强的鲁棒性,能够满足日常对话、新闻播报、企业宣传以及复杂情感表达等多种合成需求。
翻译模型质量全面升级,推理速度提升80%
作为有道根基最深厚的技术资产之一,翻译模型在本次更新中也获得了显著的技术升级,进一步提升了其在翻译任务中的表现。
在数据方面,孔子团队收集并清洗了数十亿条多语言数据条目,并聘请持有TEM-8认证的专业人员进行多维度人工评估,确保从源头起就拥有高质量的语料库。
在算法方面,该模型采用了创新的“多专家 OPD”模式,通过更智能的“柔性策略”充分发挥各专家的优势。同时,通过强化学习引入了格式奖励和语言检测机制,有效解决了机器翻译中常见的脱离语境翻译和混语输出等问题。
为满足高频、高并发工业应用的需求,更新后的翻译模型配备了高效的加速机制,可直接将整体推理速度提升80%。 结合定制化的自动化大模型评估与随机人工采样方案,新一代翻译模型在文本、图像和文档翻译等多场景中均展现出极高的速度与质量水准。
回顾有道在AI领域的历程,从最初推出首个教育领域大模型“孔子”,到推出颠覆传统口语练习方式的“虚拟口语教练Hi Echo”,再到将“孔子2.0”和“孔子3.0”全面融入软硬件生态系统, 有道始终引领着AI在真实场景中的赋能应用。2026年,有道通过LobsterAI、有道宝、有道会议助手和Thinkflow等一系列AI智能助手产品,加速了AI应用进程,构建了前瞻性的全场景AI智能助手矩阵。
“孔子4.0”的升级及核心模型的全面开源,不仅显著降低了多模态和语音合成领域开发者的门槛,更展现出一种生态闭环——底层核心技术滋养着上层智能代理矩阵。 有道希望,在全球开发者和开源社区的共同贡献下,这一全模态大模型生态系统能够为各行各业带来真正生产力的变革。
附录:开源地址:
“Confucius4”多模态模型:https://huggingface.co/netease-youdao/Confucius4
“Confucius4”语音合成(TTS)模型:https://github.com/netease-youdao/Confucius4-TTS
相关文章
 网络安全专家批评Anthropic的Fable中的护栏措施
Anthropic 于周二推出了其最新模型 Fable,将其定位为备受期待的网络安全专用模型 Mythos 的公开受限版本。然而,这些限制引发了部分网络安全研究人员和从业者的不满,他们已在网上表达了担忧。“[Fable] 会阻止任何可能与网络安全相关的请求,包括阅读博客文章等无害任务,”IBM X-Force 的高级安全研究员 Valentina “Chompie” Palmiotti 表示。当用户提示触发这些安全过滤器时,Fable 会中断对话,并显示一条消息,称其“安全协议因网络安全或
Vbot VITA Power 完成近 5 亿元 Pre-A 轮融资,首批具身智能产品开启大规模交付
Vbot微塔动力作为具身智能领域的先行者,已完成近5亿元人民币的Pre-A轮融资。东方嘉富、华泰紫金和复星锐正领投,上汽资本(上汽集团)及现有股东跟投。此次投资标志着全球消费级具身智能领域单笔最大融资事件。5月8日,Vbot推出首款产品“超级狗”并启动量产交付。首批500台已发货,标志着具身机器人从实验室走向日常环境。Vbot的机器狗于2025年12月发布,是全球首款无需遥控的智能四足机器人。其核心功能——全场景陪伴、自主搬运和AI拍摄——推动了强劲的预售需求。在有限的预售窗口期内,该产品获得了
百度文音发布PaddleOCR-VL-1.6,准确率达96.33%,在文档解析领域创下新的SOTA纪录
百度正式发布了PaddleOCR-VL-1.6,这是ERNIE大模型的一个专用变体。 在权威的OmnicDocBench v1.6基准测试中,该模型以96.33%的准确率,超越了Gemini-3-Pro、GPT-5.2和GLM-OCR等领先模型。 这一成就创下了行业新的最先进水平(SOTA),并在综合性能方面位居全球第一,标志着多模态大模型在理解复杂文档和分析现实世界情境方面取得了重大飞跃。作为
相关专题推荐
自动化
 顶尖 AI 智能代理构建工具:设计多步骤业务自动化流程
2026年最新高评分最佳AI代理构建工具,助您创建多步骤业务自动化流程。这份精心筛选的清单收录了经过严格实际测试、功能强大且具有颠覆性的工具。 您将在此找到详细的免费版与付费版对比分析、全面的排名榜单以及每周更新的行业洞察,助您选择能显著提升工作效率的完美解决方案。立即访问 XIX.AI,释放您的 AI 优势!
 11 个工具
 xix.ai
生产率
面向忙碌专业人士的AI任务规划工具
2026年最新最佳、评分最高的AI任务规划工具,专为忙碌的专业人士打造!XIX.AI精心精选了一系列功能强大、具有颠覆性的高效工具,帮助用户优化工作流程、提升工作效率,并克服日常日程安排的挑战。每款工具都经过严格的实际测试,以确保其可靠性。 获取免费版与付费版的对比指南,发现能助您发挥 AI 优势的完美工具。立即探索!
15 个工具
xix.ai
聊天机器人
顶级 AI 客户聊天机器人:全天候解答常见问题并筛选潜在客户
2026 年最新顶级 AI 客户聊天机器人精选列表中的佼佼者,是即时回答客户常见问题并全天候筛选潜在客户的最优解决方案。XIX.AI 进行了严格的真实世界测试,提供详细的免费与付费版对比以及最新排名,帮助您找到能够显著提升生产力的强大变革性工具。立即探索,发现您完美的 AI 聊天机器人解决方案!
9 个工具
xix.ai
设计与艺术
面向广告创意团队的AI分镜生成器
2026年广告创意团队必备的最新最佳AI分镜生成器!XIX.AI 通过实际测试和每周更新的严格排名,精心甄选出一份备受好评的强大且具有颠覆性的工具清单,帮助团队更快地创作令人惊艳的视觉内容。 通过免费版与付费版的对比,找到最适合您工作流程的工具。立即探索,在广告创作中释放您的AI优势!
8 个工具
xix.ai
聊天机器人
用于内部文档的AI知识聊天机器人工具
2026年最新、最受欢迎且评价最高的内部文档AI知识聊天机器人工具已登陆XIX.AI!这份精心筛选的清单汇集了功能强大且具有革命性意义的解决方案,它们能帮助团队快速生成高质量内容、简化文档创建流程并克服常见的写作难题,从而显著提升工作效率。 我们进行了严格的实际测试,并提供每周更新的免费版与付费版对比分析以及详细排名,助您找到最符合需求的必试之选。立即探索,发现最适合您的工具!
12 个工具
xix.ai
文字转语音
最佳 AI 文字转语音工具:为视频制作自然配音
2026 年最新最佳顶级评分 AI 文本转语音工具,专为制作视频中的自然配音而精心策划。XIX.AI 提供强大且改变游戏规则的方案,提升写作效率,助你突破创作瓶颈。我们进行真实世界测试,提供免费与付费版对比,并每周更新排名。经过严格评估后重点推荐必试选项。立即探索,发现提升视频质量的完美工具。
9 个工具
xix.ai

 评论 (1)
0/500
![WillGarcía]()
有道のZi Yue 4って、27Bパラメータで数学SOTA達成しつつ3秒で感情クローン?技術の進歩が速すぎて追いつけない。特にTTSエンジンのオープンソース化は開発者には朗報だけど、倫理面の規制が追いついてないのが心配だ。ただ、リアルタイムの音声合成精度が上がれば、アクセシビリティの向上に大きく貢献するはず。今後のアップデートに期待しつつも、深偽技術の悪用防止策がどうなるか注視したい。🤖✨
网易有道近日宣布,其“孔子4”大模型已全面升级至4.0版本。如今,“孔子4”已实现全模态支持,可支持文本、图像和音频的集成交互。 有道还将其核心的多模态和文本转语音(TTS)模型开源,同时对翻译模型进行了深度技术改造,在质量和效率方面均有所提升。
该多模态模型在视觉和数学领域均达到了最先进水平(SOTA),在纯文本数学题上表现尤为出色
据公告称,这款拥有270亿参数的开源“孔子4号”多模态模型,已将基于视觉输入的数学处理能力提升至教育场景中的行业领先水平(SOTA)。 在同等规模的模型中,Confucius4 尤其擅长处理包含图表的高级视觉数学和物理问题。它在中文纯文本数学题上也取得了显著进步,准确率达到 81.4%,处于行业领先水平。
▲ 在同等规模的模型中,Confucius4 在多个视觉数学基准测试中均取得业界最佳成绩
图片来源:https://huggingface.co/netease-youdao/Confucius4
更具决定性的突破在于实际成本效益。据相关负责人介绍,该新模型采用了精炼的推理链重构方案。通过聚合海量高质量、简洁的推理样本进行深度优化,将推理链的输出长度压缩了43.2%。
这意味着它能够以更少的令牌和更短的推理路径更快地给出答案,从而显著降低企业及开发者在实际商业场景中的推理成本。
▲ Confucius4 在多个视觉数学基准测试中显著减少了输出令牌数量
图片来源:https://huggingface.co/netease-youdao/Confucius4
此外,Confucius4研究团队针对中国学生面临的实际作业、考试和解题场景对模型进行了深度优化。这使其能够应对真实的学习挑战,成为更具同理心的数字助手。
开源语音合成(TTS):支持14种语言,3秒内即可克隆原声,跨语言无口音问题
除多模态模型外,语音合成(TTS)引擎也已开源。该引擎基于前沿的“语音编码器 + 大型语言模型(LLM)”架构构建,为开发者和内容创作者提供了零样本、低门槛的语音克隆和情感合成能力。
目前,该引擎全面支持14种语言:中文、英语、日语、韩语、德语、法语、西班牙语、印尼语、意大利语、泰语、葡萄牙语、俄语、马来语和越南语。 该系统无需额外训练即可自然地在不同语言间转换说话者的声音,在保持声音一致性的同时,确保合成结果听起来像母语者一样流利自然,且在跨语言克隆过程中不会出现口音泄漏。
在语音克隆方面,Confucius4实现了完全的“上传即克隆”功能。用户只需提供任意音频素材,系统便能在三秒内复刻原始声音。 据公告称,该引擎在克隆任务上的准确率超过97%,克隆声音与原始声音的相似度超过85%。它在保留说话者独特嗓音特征的同时,还能准确再现其情感语调,其综合能力位居该领域前列。
此外,该开源模型在真实的多语言场景中展现出极强的鲁棒性,能够满足日常对话、新闻播报、企业宣传以及复杂情感表达等多种合成需求。
翻译模型质量全面升级,推理速度提升80%
作为有道根基最深厚的技术资产之一,翻译模型在本次更新中也获得了显著的技术升级,进一步提升了其在翻译任务中的表现。
在数据方面,孔子团队收集并清洗了数十亿条多语言数据条目,并聘请持有TEM-8认证的专业人员进行多维度人工评估,确保从源头起就拥有高质量的语料库。
在算法方面,该模型采用了创新的“多专家 OPD”模式,通过更智能的“柔性策略”充分发挥各专家的优势。同时,通过强化学习引入了格式奖励和语言检测机制,有效解决了机器翻译中常见的脱离语境翻译和混语输出等问题。
为满足高频、高并发工业应用的需求,更新后的翻译模型配备了高效的加速机制,可直接将整体推理速度提升80%。 结合定制化的自动化大模型评估与随机人工采样方案,新一代翻译模型在文本、图像和文档翻译等多场景中均展现出极高的速度与质量水准。
回顾有道在AI领域的历程,从最初推出首个教育领域大模型“孔子”,到推出颠覆传统口语练习方式的“虚拟口语教练Hi Echo”,再到将“孔子2.0”和“孔子3.0”全面融入软硬件生态系统, 有道始终引领着AI在真实场景中的赋能应用。2026年,有道通过LobsterAI、有道宝、有道会议助手和Thinkflow等一系列AI智能助手产品,加速了AI应用进程,构建了前瞻性的全场景AI智能助手矩阵。
“孔子4.0”的升级及核心模型的全面开源,不仅显著降低了多模态和语音合成领域开发者的门槛,更展现出一种生态闭环——底层核心技术滋养着上层智能代理矩阵。 有道希望,在全球开发者和开源社区的共同贡献下,这一全模态大模型生态系统能够为各行各业带来真正生产力的变革。
附录:开源地址:
“Confucius4”多模态模型:https://huggingface.co/netease-youdao/Confucius4
“Confucius4”语音合成(TTS)模型:https://github.com/netease-youdao/Confucius4-TTS








 网络安全专家批评Anthropic的Fable中的护栏措施
Anthropic 于周二推出了其最新模型 Fable,将其定位为备受期待的网络安全专用模型 Mythos 的公开受限版本。然而,这些限制引发了部分网络安全研究人员和从业者的不满,他们已在网上表达了担忧。“[Fable] 会阻止任何可能与网络安全相关的请求,包括阅读博客文章等无害任务,”IBM X-Force 的高级安全研究员 Valentina “Chompie” Palmiotti 表示。当用户提示触发这些安全过滤器时,Fable 会中断对话,并显示一条消息,称其“安全协议因网络安全或
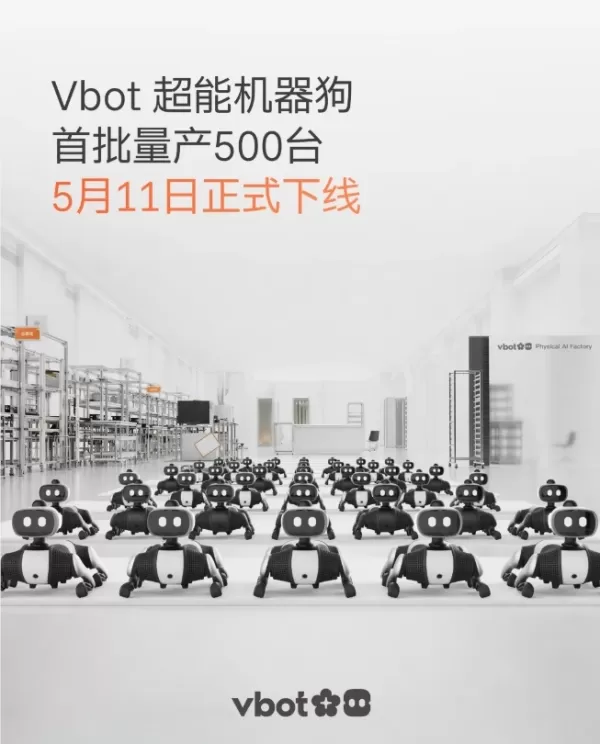 Vbot VITA Power 完成近 5 亿元 Pre-A 轮融资,首批具身智能产品开启大规模交付
Vbot微塔动力作为具身智能领域的先行者,已完成近5亿元人民币的Pre-A轮融资。东方嘉富、华泰紫金和复星锐正领投,上汽资本(上汽集团)及现有股东跟投。此次投资标志着全球消费级具身智能领域单笔最大融资事件。5月8日,Vbot推出首款产品“超级狗”并启动量产交付。首批500台已发货,标志着具身机器人从实验室走向日常环境。Vbot的机器狗于2025年12月发布,是全球首款无需遥控的智能四足机器人。其核心功能——全场景陪伴、自主搬运和AI拍摄——推动了强劲的预售需求。在有限的预售窗口期内,该产品获得了
 百度文音发布PaddleOCR-VL-1.6,准确率达96.33%,在文档解析领域创下新的SOTA纪录
百度正式发布了PaddleOCR-VL-1.6,这是ERNIE大模型的一个专用变体。 在权威的OmnicDocBench v1.6基准测试中,该模型以96.33%的准确率,超越了Gemini-3-Pro、GPT-5.2和GLM-OCR等领先模型。 这一成就创下了行业新的最先进水平(SOTA),并在综合性能方面位居全球第一,标志着多模态大模型在理解复杂文档和分析现实世界情境方面取得了重大飞跃。作为
2026年最新高评分最佳AI代理构建工具,助您创建多步骤业务自动化流程。这份精心筛选的清单收录了经过严格实际测试、功能强大且具有颠覆性的工具。 您将在此找到详细的免费版与付费版对比分析、全面的排名榜单以及每周更新的行业洞察,助您选择能显著提升工作效率的完美解决方案。立即访问 XIX.AI,释放您的 AI 优势!
11 个工具
xix.ai
2026年最新最佳、评分最高的AI任务规划工具,专为忙碌的专业人士打造!XIX.AI精心精选了一系列功能强大、具有颠覆性的高效工具,帮助用户优化工作流程、提升工作效率,并克服日常日程安排的挑战。每款工具都经过严格的实际测试,以确保其可靠性。 获取免费版与付费版的对比指南,发现能助您发挥 AI 优势的完美工具。立即探索!
15 个工具
xix.ai
2026 年最新顶级 AI 客户聊天机器人精选列表中的佼佼者,是即时回答客户常见问题并全天候筛选潜在客户的最优解决方案。XIX.AI 进行了严格的真实世界测试,提供详细的免费与付费版对比以及最新排名,帮助您找到能够显著提升生产力的强大变革性工具。立即探索,发现您完美的 AI 聊天机器人解决方案!
9 个工具
xix.ai
2026年广告创意团队必备的最新最佳AI分镜生成器!XIX.AI 通过实际测试和每周更新的严格排名,精心甄选出一份备受好评的强大且具有颠覆性的工具清单,帮助团队更快地创作令人惊艳的视觉内容。 通过免费版与付费版的对比,找到最适合您工作流程的工具。立即探索,在广告创作中释放您的AI优势!
8 个工具
xix.ai
2026年最新、最受欢迎且评价最高的内部文档AI知识聊天机器人工具已登陆XIX.AI!这份精心筛选的清单汇集了功能强大且具有革命性意义的解决方案,它们能帮助团队快速生成高质量内容、简化文档创建流程并克服常见的写作难题,从而显著提升工作效率。 我们进行了严格的实际测试,并提供每周更新的免费版与付费版对比分析以及详细排名,助您找到最符合需求的必试之选。立即探索,发现最适合您的工具!
12 个工具
xix.ai
2026 年最新最佳顶级评分 AI 文本转语音工具,专为制作视频中的自然配音而精心策划。XIX.AI 提供强大且改变游戏规则的方案,提升写作效率,助你突破创作瓶颈。我们进行真实世界测试,提供免费与付费版对比,并每周更新排名。经过严格评估后重点推荐必试选项。立即探索,发现提升视频质量的完美工具。
9 个工具
xix.ai

有道のZi Yue 4って、27Bパラメータで数学SOTA達成しつつ3秒で感情クローン?技術の進歩が速すぎて追いつけない。特にTTSエンジンのオープンソース化は開発者には朗報だけど、倫理面の規制が追いついてないのが心配だ。ただ、リアルタイムの音声合成精度が上がれば、アクセシビリティの向上に大きく貢献するはず。今後のアップデートに期待しつつも、深偽技術の悪用防止策がどうなるか注視したい。🤖✨












