


 Maison
Math SOTA 27B et clonage émotionnel en 3 secondes : Youdao open-source le moteur multimodal et de synthèse vocale Zi Yue 4
NetEase Youdao a récemment annoncé une mise à jour complète de son grand modèle « Confucius4 », qui passe à la version 4.0. Désormais entièrement multimodal, Confucius4 prend en charge les interactions intégrées entre texte, image et audio. Youdao a également mis en open source ses modèles multimodaux et de synthèse vocale (TTS) de base, tandis que le modèle de traduction a fait l’objet d’une refonte technique en profondeur, apportant des améliorations tant en termes de qualité que d’efficacité.
Le modèle multimodal atteint le niveau SOTA (State of the Art) en vision et en mathématiques, avec des performances supérieures sur les problèmes mathématiques en texte brut
Selon l’annonce, le modèle multimodal open source Confucius4, doté de 27 milliards de paramètres, a porté les capacités mathématiques basées sur des entrées visuelles à un niveau de pointe (SOTA) dans les contextes éducatifs. Parmi les modèles d’une échelle similaire, Confucius4 excelle dans le traitement de problèmes mathématiques et physiques visuels avancés intégrant des graphiques. Il affiche également une amélioration significative sur les problèmes mathématiques en texte pur en chinois, atteignant une précision de 81,4 %, ce qui est à la pointe du secteur.
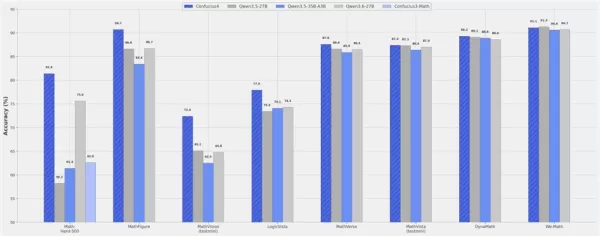
▲ Confucius4 obtient les meilleurs résultats de sa catégorie sur plusieurs benchmarks de mathématiques visuelles parmi les modèles de même envergure
Source de l’image : https://huggingface.co/netease-youdao/Confucius4
Une avancée encore plus décisive réside dans sa rentabilité pratique. Selon les responsables concernés, ce nouveau modèle utilise un schéma perfectionné de reconstruction de la chaîne de raisonnement. En regroupant un volume important d’exemples de raisonnement concis et de haute qualité pour une optimisation en profondeur, il réduit la longueur de la chaîne de raisonnement de 43,2 %.
Cela signifie qu’il peut fournir des réponses plus rapidement, avec moins de tokens et des chemins de raisonnement plus courts, ce qui réduit considérablement les coûts d’inférence dans les scénarios métier réels pour les entreprises et les développeurs.
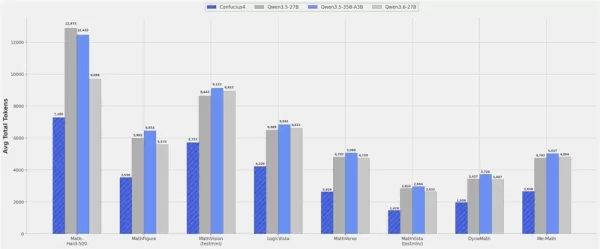
▲ Confucius4 réduit considérablement le nombre de tokens de sortie sur plusieurs benchmarks mathématiques visuels
Source de l’image : https://huggingface.co/netease-youdao/Confucius4
De plus, l’équipe de recherche de Confucius4 a profondément optimisé le modèle pour les scénarios concrets de devoirs, d’examens et de résolution de problèmes auxquels sont confrontés les élèves chinois. Cela lui permet de relever des défis d’apprentissage authentiques, ce qui en fait un assistant numérique plus empathique.
Synthèse vocale open source : prend en charge 14 langues, reproduit la voix d’origine en 3 secondes sans problème d’accent, quelle que soit la langue
Parallèlement au modèle multimodal, le moteur de synthèse vocale (TTS) a également été mis en open source. Reposant sur une architecture de pointe « encodeur vocal + LLM », il offre aux développeurs et aux créateurs de contenu des capacités de clonage vocal et de synthèse émotionnelle « zero-shot » et faciles d’accès.
Actuellement, il prend entièrement en charge 14 langues : le chinois, l’anglais, le japonais, le coréen, l’allemand, le français, l’espagnol, l’indonésien, l’italien, le thaï, le portugais, le russe, le malais et le vietnamien. Le système est capable de transposer naturellement la voix d’un locuteur d’une langue à l’autre sans apprentissage supplémentaire, en préservant la cohérence vocale tout en garantissant que les résultats synthétisés sonnent de manière naturelle et fluide, sans aucune trace d’accent lors du clonage interlinguistique.
En matière de clonage vocal, Confucius4 offre une prise en charge complète du principe « télécharger et cloner ». Il suffit aux utilisateurs de fournir un enregistrement audio quelconque pour que le système reproduise la voix d’origine en moins de trois secondes. Selon l’annonce, la précision du moteur pour les tâches de clonage dépasse 97 %, et la similitude entre la voix clonée et la voix d’origine est supérieure à 85 %. Il préserve les caractéristiques vocales uniques du locuteur tout en reproduisant fidèlement sa tonalité émotionnelle, avec des capacités complètes qui le classent parmi les meilleurs du secteur.
De plus, ce modèle open source fait preuve d’une grande robustesse dans des scénarios multilingues réels. Il peut répondre à divers besoins de synthèse, notamment les conversations quotidiennes, les bulletins d’information, les promotions d’entreprise et les expressions émotionnelles complexes.
Qualité du modèle de traduction améliorée de manière globale, avec une vitesse d’inférence 80 % plus rapide
En tant que l’un des atouts technologiques les plus ancrés de Youdao, le modèle de traduction a également bénéficié d’améliorations techniques significatives dans cette mise à jour, renforçant encore ses performances dans les tâches de traduction.
En ce qui concerne les données, l’équipe Confucius a collecté et nettoyé des milliards d’éléments multilingues et a fait appel à des professionnels certifiés TEM-8 pour une évaluation manuelle multidimensionnelle, garantissant ainsi des corpus de haute qualité dès le départ.
Du point de vue algorithmique, le modèle utilise un mode innovant « OPD multi-experts », adoptant une « approche souple » plus intelligente pour tirer parti des atouts de divers experts. Il introduit également des mécanismes de récompense de format et de détection de langue via l’apprentissage par renforcement, résolvant ainsi efficacement les problèmes courants tels que les traductions hors contexte et les résultats en langues mélangées dans la traduction automatique.
Pour répondre aux exigences des applications industrielles à haute fréquence et à forte concurrence, le modèle de traduction mis à jour est doté d’un mécanisme d’accélération efficace qui augmente directement la vitesse globale d’inférence de 80 %. Associé à une solution sur mesure combinant l’évaluation automatisée de grands modèles et l’échantillonnage manuel aléatoire, ce modèle de traduction de nouvelle génération atteint des niveaux extrêmement élevés de rapidité et de qualité dans de multiples scénarios, notamment la traduction de textes, d’images et de documents.
En retraçant le parcours de Youdao dans le domaine de l’IA, depuis le lancement initial de Confucius, premier grand modèle axé sur l’éducation, en passant par l’introduction du « coach vocal virtuel Hi Echo » qui a bouleversé les méthodes traditionnelles d’entraînement à l’expression orale, jusqu’à l’intégration complète de Confucius 2.0 et 3.0 dans des écosystèmes logiciels et matériels, Youdao a toujours été à la pointe de l’application de l’IA dans des scénarios concrets. En 2026, Youdao a accéléré l’application de l’IA grâce à une série de produits d’agents IA tels que LobsterAI, Youdao Treasure, Youdao Conference Agent et Thinkflow, mettant ainsi en place une matrice d’agents IA avant-gardiste couvrant tous les scénarios.
La mise à niveau de Confucius 4 et l’ouverture totale du code source des modèles de base réduisent non seulement considérablement les obstacles pour les développeurs dans les domaines multimodaux et de la synthèse vocale, mais illustrent également un cycle écologique fermé dans lequel les technologies de base sous-jacentes alimentent les matrices d’agents des couches supérieures. Youdao espère que, grâce aux contributions conjointes des développeurs du monde entier et de la communauté open source, cet écosystème de grands modèles multimodaux déclenchera une véritable transformation de la productivité dans un large éventail de secteurs.
Annexe : adresses open source :
Modèle multimodal « Confucius4 » : https://huggingface.co/netease-youdao/Confucius4
Modèle TTS « Confucius4 » : https://github.com/netease-youdao/Confucius4-TTS
Article connexe
 Les experts en cybersécurité critiquent les garde-fous de l’article d’Anthropic
Anthropic a lancé son nouveau modèle, Fable, mardi, le présentant comme une version publique et restreinte de son modèle axé sur la cybersécurité, Mythos, très attendu.Cependant, ces limitations ont suscité l’insatisfaction de plusieurs chercheurs e
Vbot VITA Power lève près de 500 millions de yuans en financement pré-A et lance les livraisons en masse de son premier produit d’intelligence incarnée
Vbot Weita Power, pionnier de l’intelligence incarnée, a levé près de 500 millions de yuans lors d’une levée de fonds pré-A. Dongfang Jiafu, Huatai Zijin et Fosun Ruizheng ont mené ce tour de table, avec le soutien complémentaire de Shangqi Capital (
Baidu Wenyin dévoile PaddleOCR-VL-1.6, qui atteint une précision de 96,33 % et établit un nouveau record mondial (SOTA) en matière d'analyse de documents
Baidu a officiellement lancé PaddleOCR-VL-1.6, une variante spécialisée du modèle ERNIE Large. Lors du test de référence OmnicDocBench v1.6, qui fait autorité dans le domaine, il a atteint un taux de
Recommandations de sujets spéciaux liés
automation
 Les meilleurs outils de création d'agents IA : concevez des automatisations métier en plusieurs étapes
2026 : les meilleurs outils de création d'agents IA les mieux notés pour mettre en place des automatisations professionnelles en plusieurs étapes. Cette sélection regroupe des outils puissants et révolutionnaires qui ont fait l'objet de tests rigoureux en conditions réelles. Vous y trouverez des comparatifs détaillés entre les versions gratuites et payantes, des classements complets et des analyses mises à jour chaque semaine pour vous aider à choisir la solution idéale qui boostera considérablement votre productivité. Découvrez-les dès maintenant sur XIX.AI pour exploiter pleinement le potentiel de l’IA !
 11 outils
 xix.ai
Productivité
Outils de planification des tâches basés sur l'IA pour les professionnels très occupés
Les meilleurs outils de planification des tâches basés sur l'IA de 2026, les mieux notés, pour les professionnels très occupés ! XIX.AI a sélectionné une gamme d'outils puissants et révolutionnaires, d'une grande efficacité, qui aident les utilisateurs à rationaliser leurs flux de travail, à booster leur productivité et à surmonter les défis quotidiens liés à la planification. Chaque option est soumise à des tests rigoureux en conditions réelles afin de garantir sa fiabilité. Consultez notre comparatif entre les versions gratuites et payantes et découvrez l'outil idéal pour tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
15 outils
xix.ai
chatbot
Top des chatbots clients IA : Répondez aux FAQ et qualifiez les prospects 24h/24 et 7j/7
Les chatbots clients IA les mieux notés de 2026, présentés dans cette liste sélectionnée, sont les meilleures solutions pour répondre instantanément aux questions fréquentes des clients et qualifier les prospects 24h/24 et 7j/7. XIX.AI a réalisé des tests rigoureux en conditions réelles pour fournir une comparaison détaillée entre les versions gratuite et payante, ainsi que des classements à jour, vous aidant ainsi à trouver un outil puissant et transformateur qui améliore considérablement la productivité. Explorez dès maintenant pour découvrir votre solution de chatbot IA idéale !
9 outils
xix.ai
Conception et art
Générateurs de storyboards basés sur l'IA destinés aux équipes créatives publicitaires
Les meilleurs générateurs de storyboards basés sur l'IA de 2026 pour les équipes créatives publicitaires ! XIX.AI a sélectionné une liste des outils les mieux notés, à la fois puissants et révolutionnaires, qui aident les équipes à créer plus rapidement des contenus visuels époustouflants, grâce à des tests en conditions réelles et à un classement rigoureux mis à jour chaque semaine. Profitez d'une comparaison entre les versions gratuites et payantes pour trouver celle qui correspond le mieux à votre flux de travail. Découvrez-les dès maintenant pour exploiter pleinement le potentiel de l'IA dans la création publicitaire !
8 outils
xix.ai
chatbot
Outils de chatbot de connaissances IA pour la documentation interne
2026 Dernières Meilleures Outils de Chatbot IA les mieux notés pour la Documentation Interne sont ici sur XIX.AI ! Cette liste soigneusement sélectionnée propose des solutions puissantes et révolutionnaires qui augmentent considérablement la productivité en aidant les équipes à générer rapidement du contenu de haute qualité, rationaliser la création de documentation et surmonner les défis courants d’écriture. Nous effectuons des tests rigoureux en conditions réelles et fournissons une comparaison hebdomadaire gratuite vs payante ainsi que des classements détaillés pour vous aider à trouver l’option incontournable qui correspond le mieux à vos besoins. Explorez dès maintenant pour découvrir votre outil parfait !
12 outils
xix.ai
Synthèse vocale
Meilleurs outils d’IA de synthèse vocale : créez des voix off naturelles pour vos vidéos
2026 Derniers Meilleurs Outils de Synthèse Vocale par IA les mieux notés, sélectionnés pour créer des voix off naturelles dans les vidéos. XIX.AI propose des solutions puissantes et révolutionnaires qui améliorent l'efficacité de l'écriture et vous aident à surmonner les blocages créatifs. Nous réalisons des tests en conditions réelles, proposons des comparaisons entre versions gratuites et payantes, et mettons à jour nos classements chaque semaine. Les options incontournables sont mises en avant sur la base d'évaluations rigoureuses. Explorez dès maintenant pour découvrir l'outil parfait afin d'améliorer la qualité de vos vidéos.
9 outils
xix.ai

 commentaires (1)
![WillGarcía]()
有道のZi Yue 4って、27Bパラメータで数学SOTA達成しつつ3秒で感情クローン?技術の進歩が速すぎて追いつけない。特にTTSエンジンのオープンソース化は開発者には朗報だけど、倫理面の規制が追いついてないのが心配だ。ただ、リアルタイムの音声合成精度が上がれば、アクセシビリティの向上に大きく貢献するはず。今後のアップデートに期待しつつも、深偽技術の悪用防止策がどうなるか注視したい。🤖✨
NetEase Youdao a récemment annoncé une mise à jour complète de son grand modèle « Confucius4 », qui passe à la version 4.0. Désormais entièrement multimodal, Confucius4 prend en charge les interactions intégrées entre texte, image et audio. Youdao a également mis en open source ses modèles multimodaux et de synthèse vocale (TTS) de base, tandis que le modèle de traduction a fait l’objet d’une refonte technique en profondeur, apportant des améliorations tant en termes de qualité que d’efficacité.
Le modèle multimodal atteint le niveau SOTA (State of the Art) en vision et en mathématiques, avec des performances supérieures sur les problèmes mathématiques en texte brut
Selon l’annonce, le modèle multimodal open source Confucius4, doté de 27 milliards de paramètres, a porté les capacités mathématiques basées sur des entrées visuelles à un niveau de pointe (SOTA) dans les contextes éducatifs. Parmi les modèles d’une échelle similaire, Confucius4 excelle dans le traitement de problèmes mathématiques et physiques visuels avancés intégrant des graphiques. Il affiche également une amélioration significative sur les problèmes mathématiques en texte pur en chinois, atteignant une précision de 81,4 %, ce qui est à la pointe du secteur.
▲ Confucius4 obtient les meilleurs résultats de sa catégorie sur plusieurs benchmarks de mathématiques visuelles parmi les modèles de même envergure
Source de l’image : https://huggingface.co/netease-youdao/Confucius4
Une avancée encore plus décisive réside dans sa rentabilité pratique. Selon les responsables concernés, ce nouveau modèle utilise un schéma perfectionné de reconstruction de la chaîne de raisonnement. En regroupant un volume important d’exemples de raisonnement concis et de haute qualité pour une optimisation en profondeur, il réduit la longueur de la chaîne de raisonnement de 43,2 %.
Cela signifie qu’il peut fournir des réponses plus rapidement, avec moins de tokens et des chemins de raisonnement plus courts, ce qui réduit considérablement les coûts d’inférence dans les scénarios métier réels pour les entreprises et les développeurs.
▲ Confucius4 réduit considérablement le nombre de tokens de sortie sur plusieurs benchmarks mathématiques visuels
Source de l’image : https://huggingface.co/netease-youdao/Confucius4
De plus, l’équipe de recherche de Confucius4 a profondément optimisé le modèle pour les scénarios concrets de devoirs, d’examens et de résolution de problèmes auxquels sont confrontés les élèves chinois. Cela lui permet de relever des défis d’apprentissage authentiques, ce qui en fait un assistant numérique plus empathique.
Synthèse vocale open source : prend en charge 14 langues, reproduit la voix d’origine en 3 secondes sans problème d’accent, quelle que soit la langue
Parallèlement au modèle multimodal, le moteur de synthèse vocale (TTS) a également été mis en open source. Reposant sur une architecture de pointe « encodeur vocal + LLM », il offre aux développeurs et aux créateurs de contenu des capacités de clonage vocal et de synthèse émotionnelle « zero-shot » et faciles d’accès.
Actuellement, il prend entièrement en charge 14 langues : le chinois, l’anglais, le japonais, le coréen, l’allemand, le français, l’espagnol, l’indonésien, l’italien, le thaï, le portugais, le russe, le malais et le vietnamien. Le système est capable de transposer naturellement la voix d’un locuteur d’une langue à l’autre sans apprentissage supplémentaire, en préservant la cohérence vocale tout en garantissant que les résultats synthétisés sonnent de manière naturelle et fluide, sans aucune trace d’accent lors du clonage interlinguistique.
En matière de clonage vocal, Confucius4 offre une prise en charge complète du principe « télécharger et cloner ». Il suffit aux utilisateurs de fournir un enregistrement audio quelconque pour que le système reproduise la voix d’origine en moins de trois secondes. Selon l’annonce, la précision du moteur pour les tâches de clonage dépasse 97 %, et la similitude entre la voix clonée et la voix d’origine est supérieure à 85 %. Il préserve les caractéristiques vocales uniques du locuteur tout en reproduisant fidèlement sa tonalité émotionnelle, avec des capacités complètes qui le classent parmi les meilleurs du secteur.
De plus, ce modèle open source fait preuve d’une grande robustesse dans des scénarios multilingues réels. Il peut répondre à divers besoins de synthèse, notamment les conversations quotidiennes, les bulletins d’information, les promotions d’entreprise et les expressions émotionnelles complexes.
Qualité du modèle de traduction améliorée de manière globale, avec une vitesse d’inférence 80 % plus rapide
En tant que l’un des atouts technologiques les plus ancrés de Youdao, le modèle de traduction a également bénéficié d’améliorations techniques significatives dans cette mise à jour, renforçant encore ses performances dans les tâches de traduction.
En ce qui concerne les données, l’équipe Confucius a collecté et nettoyé des milliards d’éléments multilingues et a fait appel à des professionnels certifiés TEM-8 pour une évaluation manuelle multidimensionnelle, garantissant ainsi des corpus de haute qualité dès le départ.
Du point de vue algorithmique, le modèle utilise un mode innovant « OPD multi-experts », adoptant une « approche souple » plus intelligente pour tirer parti des atouts de divers experts. Il introduit également des mécanismes de récompense de format et de détection de langue via l’apprentissage par renforcement, résolvant ainsi efficacement les problèmes courants tels que les traductions hors contexte et les résultats en langues mélangées dans la traduction automatique.
Pour répondre aux exigences des applications industrielles à haute fréquence et à forte concurrence, le modèle de traduction mis à jour est doté d’un mécanisme d’accélération efficace qui augmente directement la vitesse globale d’inférence de 80 %. Associé à une solution sur mesure combinant l’évaluation automatisée de grands modèles et l’échantillonnage manuel aléatoire, ce modèle de traduction de nouvelle génération atteint des niveaux extrêmement élevés de rapidité et de qualité dans de multiples scénarios, notamment la traduction de textes, d’images et de documents.
En retraçant le parcours de Youdao dans le domaine de l’IA, depuis le lancement initial de Confucius, premier grand modèle axé sur l’éducation, en passant par l’introduction du « coach vocal virtuel Hi Echo » qui a bouleversé les méthodes traditionnelles d’entraînement à l’expression orale, jusqu’à l’intégration complète de Confucius 2.0 et 3.0 dans des écosystèmes logiciels et matériels, Youdao a toujours été à la pointe de l’application de l’IA dans des scénarios concrets. En 2026, Youdao a accéléré l’application de l’IA grâce à une série de produits d’agents IA tels que LobsterAI, Youdao Treasure, Youdao Conference Agent et Thinkflow, mettant ainsi en place une matrice d’agents IA avant-gardiste couvrant tous les scénarios.
La mise à niveau de Confucius 4 et l’ouverture totale du code source des modèles de base réduisent non seulement considérablement les obstacles pour les développeurs dans les domaines multimodaux et de la synthèse vocale, mais illustrent également un cycle écologique fermé dans lequel les technologies de base sous-jacentes alimentent les matrices d’agents des couches supérieures. Youdao espère que, grâce aux contributions conjointes des développeurs du monde entier et de la communauté open source, cet écosystème de grands modèles multimodaux déclenchera une véritable transformation de la productivité dans un large éventail de secteurs.
Annexe : adresses open source :
Modèle multimodal « Confucius4 » : https://huggingface.co/netease-youdao/Confucius4
Modèle TTS « Confucius4 » : https://github.com/netease-youdao/Confucius4-TTS








 Les experts en cybersécurité critiquent les garde-fous de l’article d’Anthropic
Anthropic a lancé son nouveau modèle, Fable, mardi, le présentant comme une version publique et restreinte de son modèle axé sur la cybersécurité, Mythos, très attendu.Cependant, ces limitations ont suscité l’insatisfaction de plusieurs chercheurs e
 Vbot VITA Power lève près de 500 millions de yuans en financement pré-A et lance les livraisons en masse de son premier produit d’intelligence incarnée
Vbot Weita Power, pionnier de l’intelligence incarnée, a levé près de 500 millions de yuans lors d’une levée de fonds pré-A. Dongfang Jiafu, Huatai Zijin et Fosun Ruizheng ont mené ce tour de table, avec le soutien complémentaire de Shangqi Capital (
 Baidu Wenyin dévoile PaddleOCR-VL-1.6, qui atteint une précision de 96,33 % et établit un nouveau record mondial (SOTA) en matière d'analyse de documents
Baidu a officiellement lancé PaddleOCR-VL-1.6, une variante spécialisée du modèle ERNIE Large. Lors du test de référence OmnicDocBench v1.6, qui fait autorité dans le domaine, il a atteint un taux de
2026 : les meilleurs outils de création d'agents IA les mieux notés pour mettre en place des automatisations professionnelles en plusieurs étapes. Cette sélection regroupe des outils puissants et révolutionnaires qui ont fait l'objet de tests rigoureux en conditions réelles. Vous y trouverez des comparatifs détaillés entre les versions gratuites et payantes, des classements complets et des analyses mises à jour chaque semaine pour vous aider à choisir la solution idéale qui boostera considérablement votre productivité. Découvrez-les dès maintenant sur XIX.AI pour exploiter pleinement le potentiel de l’IA !
11 outils
xix.ai
Les meilleurs outils de planification des tâches basés sur l'IA de 2026, les mieux notés, pour les professionnels très occupés ! XIX.AI a sélectionné une gamme d'outils puissants et révolutionnaires, d'une grande efficacité, qui aident les utilisateurs à rationaliser leurs flux de travail, à booster leur productivité et à surmonter les défis quotidiens liés à la planification. Chaque option est soumise à des tests rigoureux en conditions réelles afin de garantir sa fiabilité. Consultez notre comparatif entre les versions gratuites et payantes et découvrez l'outil idéal pour tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
15 outils
xix.ai
Les chatbots clients IA les mieux notés de 2026, présentés dans cette liste sélectionnée, sont les meilleures solutions pour répondre instantanément aux questions fréquentes des clients et qualifier les prospects 24h/24 et 7j/7. XIX.AI a réalisé des tests rigoureux en conditions réelles pour fournir une comparaison détaillée entre les versions gratuite et payante, ainsi que des classements à jour, vous aidant ainsi à trouver un outil puissant et transformateur qui améliore considérablement la productivité. Explorez dès maintenant pour découvrir votre solution de chatbot IA idéale !
9 outils
xix.ai
Les meilleurs générateurs de storyboards basés sur l'IA de 2026 pour les équipes créatives publicitaires ! XIX.AI a sélectionné une liste des outils les mieux notés, à la fois puissants et révolutionnaires, qui aident les équipes à créer plus rapidement des contenus visuels époustouflants, grâce à des tests en conditions réelles et à un classement rigoureux mis à jour chaque semaine. Profitez d'une comparaison entre les versions gratuites et payantes pour trouver celle qui correspond le mieux à votre flux de travail. Découvrez-les dès maintenant pour exploiter pleinement le potentiel de l'IA dans la création publicitaire !
8 outils
xix.ai
2026 Dernières Meilleures Outils de Chatbot IA les mieux notés pour la Documentation Interne sont ici sur XIX.AI ! Cette liste soigneusement sélectionnée propose des solutions puissantes et révolutionnaires qui augmentent considérablement la productivité en aidant les équipes à générer rapidement du contenu de haute qualité, rationaliser la création de documentation et surmonner les défis courants d’écriture. Nous effectuons des tests rigoureux en conditions réelles et fournissons une comparaison hebdomadaire gratuite vs payante ainsi que des classements détaillés pour vous aider à trouver l’option incontournable qui correspond le mieux à vos besoins. Explorez dès maintenant pour découvrir votre outil parfait !
12 outils
xix.ai
2026 Derniers Meilleurs Outils de Synthèse Vocale par IA les mieux notés, sélectionnés pour créer des voix off naturelles dans les vidéos. XIX.AI propose des solutions puissantes et révolutionnaires qui améliorent l'efficacité de l'écriture et vous aident à surmonner les blocages créatifs. Nous réalisons des tests en conditions réelles, proposons des comparaisons entre versions gratuites et payantes, et mettons à jour nos classements chaque semaine. Les options incontournables sont mises en avant sur la base d'évaluations rigoureuses. Explorez dès maintenant pour découvrir l'outil parfait afin d'améliorer la qualité de vos vidéos.
9 outils
xix.ai

有道のZi Yue 4って、27Bパラメータで数学SOTA達成しつつ3秒で感情クローン?技術の進歩が速すぎて追いつけない。特にTTSエンジンのオープンソース化は開発者には朗報だけど、倫理面の規制が追いついてないのが心配だ。ただ、リアルタイムの音声合成精度が上がれば、アクセシビリティの向上に大きく貢献するはず。今後のアップデートに期待しつつも、深偽技術の悪用防止策がどうなるか注視したい。🤖✨












