


 首頁
Meta計劃在2027年前推出四代自主研發的AI晶片,參與算力競爭
Meta 正加大力度減少對外部硬體供應商的依賴,力求在競爭激烈的全球人工智慧領域保持領先地位。有訊息稱,這家社交媒體巨頭計劃在 2027 年底前推出四代自研人工智慧晶片。如此激進的規劃旨在為其快速擴張的人工智慧業務提供專用硬體,同時降低對 NVIDIA 等外部供應商的長期依賴。
目前 Meta 的自研晶片系列遵循明確的迭代路線圖。專為內容排序與推薦模型訓練設計的 MTIA 300 已進入大規模生產階段;代號為 “Iris” 的 MTIA 400 已透過實驗室測試,正逐步投入應用;更為先進的 MTIA 450(代號 “Alce”)和 MTIA 500(代號 “Astrid”)則分別計劃於 2027 年的上半年和下半年推出。如此快速的研發節奏體現了 Meta 力求讓硬體發展與人工智慧演算法的進步保持同步的決心。
儘管 Meta 正投入數十億美元組建自有晶片團隊,並收購 Rivos 等初創企業以擴充人才儲備,但其策略並非完全封閉。公司高層明確表示採取雙軌並行的方式:一方面仍作為全球最大的 GPU 購買方之一,與 NVIDIA、AMD 簽訂大型採購協議以確保基礎計算能力;另一方面則推出去除了多餘功能的專用晶片,用於日常任務,從而在 Instagram 內容排序及生成式人工智慧推理等特定場景中實現更高效率。
軟體與硬體的深度整合正逐漸成為頂尖科技企業的核心競爭優勢。雖然晶片開發通常需要兩年時間且面臨諸多工程挑戰,但 Meta 相信透過去除非必要功能,自研晶片能夠降低長期運營成本。鑑於對計算能力的需求超出預期,Meta 正不斷審視並最佳化各代 MTIA 晶片的技術路線圖,力求在自主研發與外部採購之間找到動態平衡,從而在生成式人工智慧領域保持優勢。
相關文章
 Claude Opus 5.2 夜灰色版釋出,響應速度更快,解決懶惰問題
Opus 5.2 今晨悄然上線,促使許多開發者注意到,更新後的模型 Claude Opus 5.2 已在 Claude Code 內部開始有限範圍的推送。昨晚,X 平臺使用者觀察到,在 Claude Code 中呼叫 Opus 5 時,其效能遠超標準網頁版,宛如“降維打擊”。這種路由策略在頂級 AI 公司中十分常見。資料包分析顯示,儘管前端標籤未變,但底層模型識別符號已切換為 Opus 5.2,這表明 Anthropic 可能完全跳過了 5.1 版本。速度、精度與自動“高強度迴圈”下的持續執
Fireworks AI 釋出搭載 Opus 的 FireRouter:編碼成本降低 57%,精度損失極小
Fireworks AI 推出了搭載 Opus 的 FireRouter,這是業界首個專為 Claude Opus 系列定製的快取感知路由系統。目前,該獨立路由模型已透過無伺服器端點開放使用。經過超過一個月的內部 A/B 測試,FireRouter 在編碼任務中實現了 98.1% 的準確率,同時與單獨使用 Opus 相比,成本降低了 57%。FireRouter 的工作原理是在每次使用者互動時評估每個模型對當前任務的適用性。它計算處理成本(包括提示詞快取),並判斷切換模型所節省的成本是否足以抵消緩
NVIDIA 釋出 Nemotron-Labs-Audex-30B-A3B 統一音訊智慧模型
隨著多模態大模型的快速發展,音訊處理能力往往受到妥協——許多模型在提升音訊理解能力的同時,卻犧牲了文字邏輯。為解決這一問題,NVIDIA 研究人員推出了 Nemotron-Labs-Audex-30B-A3B(Audex),這是一款統一的音訊-文字大語言模型,旨在彌合這一差距。Audex 採用精簡高效的設計,基於強大的純文字混合專家(MoE)架構構建。透過利用單個 Transformer 解碼器,它同時處理文字和量化音訊令牌。該方法將音訊輸入投影到文字嵌入空間,確保與現有用於多模態任務的大語言
相關專題推薦
數據分析
 最適合快速製作報表的 AI 圖表製作工具
2026 年最新、最受好評的 AI 圖表製作工具,助您快速完成報表製作,現已登陸 XIX.AI!這份精心挑選的清單收錄了多款強大且顛覆傳統的工具,只需點擊幾下即可生成精準專業的圖表,助您提升撰寫效率並簡化內容創作流程。 透過免費版與付費版的比較、實際測試結果及詳細排名,找出最符合您需求的必試解決方案。立即探索,釋放您的 AI 優勢!
 9 個工具
 xix.ai
聊天機器人
適用於電商排隊系統、VIP 買家及退貨申請的 AI 即時聊天路由工具
2026 年最新、最佳且評價最高的 AI 即時聊天路由工具,適用於電商排隊系統、VIP 買家及退貨申請。這份精選清單收錄了經實測證實能大幅提升生產力的強大、顛覆業界的解決方案,並包含免費版與付費版的比較分析,以及詳細排名,助您找到最合適的選擇。 XIX.AI 作為此領域中備受信賴的供應商,表現尤為突出。立即探索,釋放您的 AI 競爭優勢!
9 個工具
xix.ai
寫作
最適合非母語英語寫作者的 AI 編輯工具:提升語氣、文法與行文流暢度
2026 年最新、最受好評的 ESL 寫作者專用 AI 編輯工具,就在 XIX.AI!這份精心挑選的清單收錄了多款強大且具革命性的工具,均經過實際測試以確保準確性。 您可在此查閱免費版與付費版的比較分析,以及詳細的排名榜單,助您挑選那款必試的解決方案,完美提升您的寫作語調、文法與行文流暢度。立即探索,解鎖您的 AI 優勢!
9 個工具
xix.ai
軟件開發
工程團隊最實用的 AI 錯誤分級工具
2026 年最新、最受好評的頂級 AI 錯誤分類工具,專為工程團隊打造!XIX.AI 精心精選了一系列強大且具顛覆性的必試工具,這些工具均經過嚴格的實際環境測試,能提供精準的問題分析與高效的解決方案。 立即獲取免費版與付費版的比較分析及詳細排名,助您找到能顯著提升團隊生產力的完美解決方案。立即探索,釋放您的 AI 競爭優勢!
9 個工具
xix.ai
圖像編輯
最佳 AI 人像優化工具:改善光線、膚色與清晰度
2026 年最新、最佳且評價最高的 AI 人像優化工具精選,致力於呈現極致影像品質。這些強大的工具能輕鬆提升光線、膚色與銳利度,帶來顛覆性的效果,非常適合需要快速優化照片的創作者。XIX.AI 提供免費版與付費版的比較分析,並附有實際測試結果及每週更新的排行榜。 立即發掘最適合您的工具,釋放您的 AI 優勢。立即探索!
7 個工具
xix.ai
寫作
用於 API 指南、版本說明及入門文件的 AI 技術文件工具
2026 年最新、最佳且評價最高的 AI 技術文件工具,適用於 API 指南、發行說明及入門文件。這份精選清單收錄了強大且能顛覆遊戲規則的解決方案,可簡化內容創作流程、提升撰寫效率,並在所有專案階段節省時間。XIX.AI 提供每週更新的排行榜,以及基於實際測試所得的免費版與付費版比較結果。 立即探索,發掘最適合您的工具,並釋放您的 AI 競爭優勢。
10 個工具
xix.ai

 評論 (0)
0/500
Meta 正加大力度減少對外部硬體供應商的依賴,力求在競爭激烈的全球人工智慧領域保持領先地位。有訊息稱,這家社交媒體巨頭計劃在 2027 年底前推出四代自研人工智慧晶片。如此激進的規劃旨在為其快速擴張的人工智慧業務提供專用硬體,同時降低對 NVIDIA 等外部供應商的長期依賴。
目前 Meta 的自研晶片系列遵循明確的迭代路線圖。專為內容排序與推薦模型訓練設計的 MTIA 300 已進入大規模生產階段;代號為 “Iris” 的 MTIA 400 已透過實驗室測試,正逐步投入應用;更為先進的 MTIA 450(代號 “Alce”)和 MTIA 500(代號 “Astrid”)則分別計劃於 2027 年的上半年和下半年推出。如此快速的研發節奏體現了 Meta 力求讓硬體發展與人工智慧演算法的進步保持同步的決心。
儘管 Meta 正投入數十億美元組建自有晶片團隊,並收購 Rivos 等初創企業以擴充人才儲備,但其策略並非完全封閉。公司高層明確表示採取雙軌並行的方式:一方面仍作為全球最大的 GPU 購買方之一,與 NVIDIA、AMD 簽訂大型採購協議以確保基礎計算能力;另一方面則推出去除了多餘功能的專用晶片,用於日常任務,從而在 Instagram 內容排序及生成式人工智慧推理等特定場景中實現更高效率。
軟體與硬體的深度整合正逐漸成為頂尖科技企業的核心競爭優勢。雖然晶片開發通常需要兩年時間且面臨諸多工程挑戰,但 Meta 相信透過去除非必要功能,自研晶片能夠降低長期運營成本。鑑於對計算能力的需求超出預期,Meta 正不斷審視並最佳化各代 MTIA 晶片的技術路線圖,力求在自主研發與外部採購之間找到動態平衡,從而在生成式人工智慧領域保持優勢。








 Claude Opus 5.2 夜灰色版釋出,響應速度更快,解決懶惰問題
Opus 5.2 今晨悄然上線,促使許多開發者注意到,更新後的模型 Claude Opus 5.2 已在 Claude Code 內部開始有限範圍的推送。昨晚,X 平臺使用者觀察到,在 Claude Code 中呼叫 Opus 5 時,其效能遠超標準網頁版,宛如“降維打擊”。這種路由策略在頂級 AI 公司中十分常見。資料包分析顯示,儘管前端標籤未變,但底層模型識別符號已切換為 Opus 5.2,這表明 Anthropic 可能完全跳過了 5.1 版本。速度、精度與自動“高強度迴圈”下的持續執
 Fireworks AI 釋出搭載 Opus 的 FireRouter:編碼成本降低 57%,精度損失極小
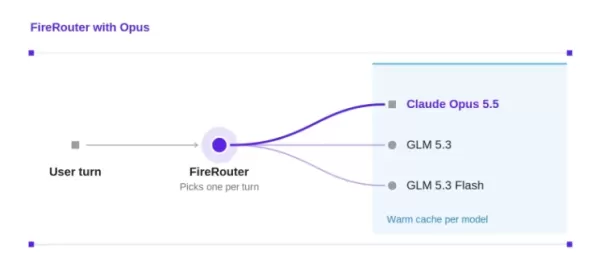
Fireworks AI 推出了搭載 Opus 的 FireRouter,這是業界首個專為 Claude Opus 系列定製的快取感知路由系統。目前,該獨立路由模型已透過無伺服器端點開放使用。經過超過一個月的內部 A/B 測試,FireRouter 在編碼任務中實現了 98.1% 的準確率,同時與單獨使用 Opus 相比,成本降低了 57%。FireRouter 的工作原理是在每次使用者互動時評估每個模型對當前任務的適用性。它計算處理成本(包括提示詞快取),並判斷切換模型所節省的成本是否足以抵消緩
 NVIDIA 釋出 Nemotron-Labs-Audex-30B-A3B 統一音訊智慧模型
隨著多模態大模型的快速發展,音訊處理能力往往受到妥協——許多模型在提升音訊理解能力的同時,卻犧牲了文字邏輯。為解決這一問題,NVIDIA 研究人員推出了 Nemotron-Labs-Audex-30B-A3B(Audex),這是一款統一的音訊-文字大語言模型,旨在彌合這一差距。Audex 採用精簡高效的設計,基於強大的純文字混合專家(MoE)架構構建。透過利用單個 Transformer 解碼器,它同時處理文字和量化音訊令牌。該方法將音訊輸入投影到文字嵌入空間,確保與現有用於多模態任務的大語言
2026 年最新、最受好評的 AI 圖表製作工具,助您快速完成報表製作,現已登陸 XIX.AI!這份精心挑選的清單收錄了多款強大且顛覆傳統的工具,只需點擊幾下即可生成精準專業的圖表,助您提升撰寫效率並簡化內容創作流程。 透過免費版與付費版的比較、實際測試結果及詳細排名,找出最符合您需求的必試解決方案。立即探索,釋放您的 AI 優勢!
9 個工具
xix.ai
2026 年最新、最佳且評價最高的 AI 即時聊天路由工具,適用於電商排隊系統、VIP 買家及退貨申請。這份精選清單收錄了經實測證實能大幅提升生產力的強大、顛覆業界的解決方案,並包含免費版與付費版的比較分析,以及詳細排名,助您找到最合適的選擇。 XIX.AI 作為此領域中備受信賴的供應商,表現尤為突出。立即探索,釋放您的 AI 競爭優勢!
9 個工具
xix.ai
2026 年最新、最受好評的 ESL 寫作者專用 AI 編輯工具,就在 XIX.AI!這份精心挑選的清單收錄了多款強大且具革命性的工具,均經過實際測試以確保準確性。 您可在此查閱免費版與付費版的比較分析,以及詳細的排名榜單,助您挑選那款必試的解決方案,完美提升您的寫作語調、文法與行文流暢度。立即探索,解鎖您的 AI 優勢!
9 個工具
xix.ai
2026 年最新、最受好評的頂級 AI 錯誤分類工具,專為工程團隊打造!XIX.AI 精心精選了一系列強大且具顛覆性的必試工具,這些工具均經過嚴格的實際環境測試,能提供精準的問題分析與高效的解決方案。 立即獲取免費版與付費版的比較分析及詳細排名,助您找到能顯著提升團隊生產力的完美解決方案。立即探索,釋放您的 AI 競爭優勢!
9 個工具
xix.ai
2026 年最新、最佳且評價最高的 AI 人像優化工具精選,致力於呈現極致影像品質。這些強大的工具能輕鬆提升光線、膚色與銳利度,帶來顛覆性的效果,非常適合需要快速優化照片的創作者。XIX.AI 提供免費版與付費版的比較分析,並附有實際測試結果及每週更新的排行榜。 立即發掘最適合您的工具,釋放您的 AI 優勢。立即探索!
7 個工具
xix.ai
2026 年最新、最佳且評價最高的 AI 技術文件工具,適用於 API 指南、發行說明及入門文件。這份精選清單收錄了強大且能顛覆遊戲規則的解決方案,可簡化內容創作流程、提升撰寫效率,並在所有專案階段節省時間。XIX.AI 提供每週更新的排行榜,以及基於實際測試所得的免費版與付費版比較結果。 立即探索,發掘最適合您的工具,並釋放您的 AI 競爭優勢。
10 個工具
xix.ai












