


 Дом
Освойте обобщение больших текстов с помощью OpenAI: руководство и методики
В современном мире, основанном на данных, эффективная обработка больших объемов информации имеет решающее значение. В этом комплексном руководстве показано, как использовать передовую технологию API OpenAI для обобщения различных текстовых источников, от простых TXT-файлов до сложных PDF-документов. Мы рассмотрим проверенные методы управления огромными документами, их стратегического сегментирования и создания проницательных резюме с помощью искусственного интеллекта. Эти методы идеально подходят для специалистов, работающих с техническими отчетами, академическими исследованиями или юридическими контрактами. Они предлагают практические решения для преобразования перегруженного контента в ценные сведения.
Ключевые моменты
Резюме TXT/PDF: Освоение методов сжатия документов для различных форматов файлов.
Преобразование PDF: Узнайте надежные методы извлечения текста из PDF-документов.
Сегментация документов: Откройте для себя оптимальные подходы к разделению больших файлов.
Интеграция API: Реализуйте мощные возможности обобщения OpenAI.
Учет кодировок: Поймите критические аспекты работы с наборами символов.
Синтез резюме: Объединение частичных резюме в целостные обзоры.
Методы обобщения документов с помощью ИИ
Преодоление проблем крупномасштабного суммирования
Резюмирование объемных документов сопряжено с серьезными препятствиями, которые традиционные методы зачастую не могут решить в должной мере. Современные решения на основе ИИ, в частности API OpenAI, предлагают масштабируемые альтернативы, которые позволяют преодолеть ограничения на обработку, сохраняя при этом точность.
Эффективное обобщение требует извлечения важной информации с сохранением контекста и смысла. Специалисты разных отраслей, в том числе ученые, анализирующие исследования, и адвокаты, изучающие контракты, выигрывают от использования этих передовых возможностей.
Методология включает в себя интеллектуальную сегментацию документов, позволяющую систематически обрабатывать управляемые участки контента, соблюдая при этом ограничения API. Такой структурированный подход гарантирует всесторонний охват без ущерба для критически важных деталей, независимо от длины исходного документа.
Основные компоненты процесса суммирования
Рабочий процесс сжатия документов включает в себя несколько основных элементов:
- Обработка входного документа: Поддержка форматов TXT и PDF с автоматическим распознаванием.
- Преобразование PDF: Преобразование содержимого PDF в анализируемый текст с сохранением целостности макета
- Сегментация содержимого: Стратегическое разделение больших документов на оптимальные блоки обработки
- Обработка API: Использование алгоритмов OpenAI для интеллектуального извлечения контента
- Интеграция резюме: Объединяет частичные резюме в единые, целостные обзоры
Детали реализации
Основная функция подведения итогов
Центральная функция summarize_document управляет всем конвейером обобщения:
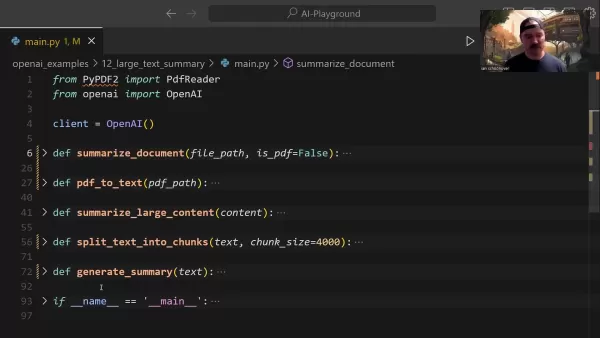
Эта функция интеллектуально обрабатывает распознавание форматов, при необходимости делегирует задачи преобразования и определяет подходящие стратегии обобщения в зависимости от размера документа.
Методология преобразования PDF
В процессе извлечения текста из PDF используются специализированные библиотеки:
Используя PyPDF2, преобразование сохраняет структуру абзацев, эффективно удаляя ненужные элементы форматирования.
Обработка больших документов
Для работы с большим контентом в системе реализована стратегическая сегментация:
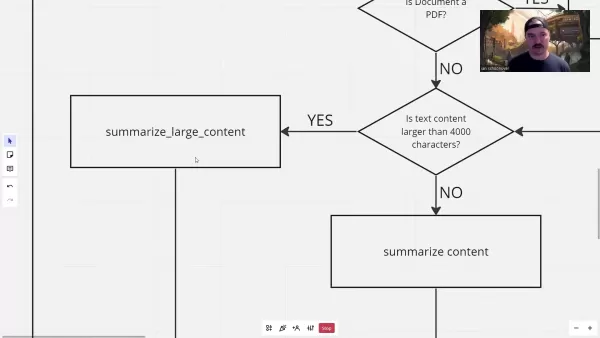
Этот подход сочетает предварительное обобщение фрагментов с окончательной консолидацией для сохранения контекста во всех объемных документах.
Сегментация контента
Алгоритм разбиения на куски обеспечивает оптимальный размер:
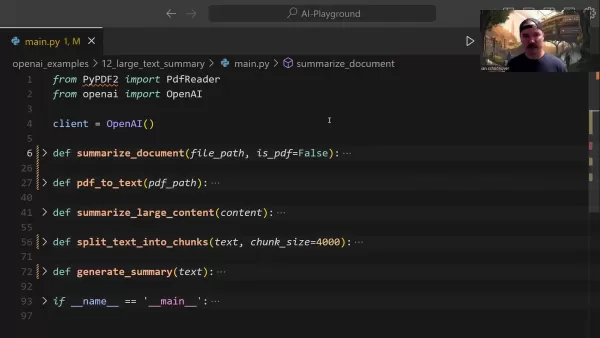
Настраиваемые размеры кусков позволяют использовать различные типы документов, соблюдая при этом ограничения API.
Интеграция искусственного интеллекта
Компонент взаимодействия с API обеспечивает интеллектуальное обобщение:
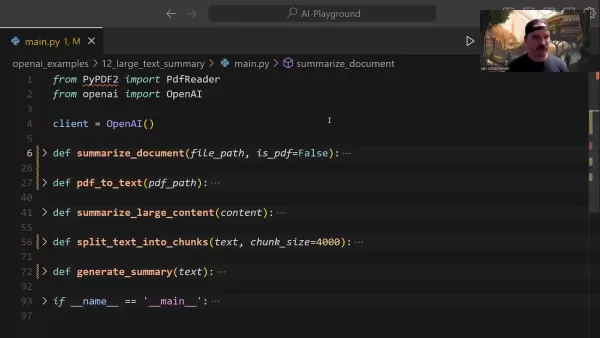
Тщательная настройка параметров обеспечивает баланс между сохранением деталей и краткостью.
Преимущества и соображения
Преимущества
- Масштабируемая обработка: Эффективно обрабатывает документы практически любого размера
- Интеллектуальное извлечение: Точная идентификация и сохранение важной информации
- Гибкость формата: Адаптация к различным структурам и макетам документов
- Повышение эффективности: Значительное сокращение времени на ручное обобщение
- Доступность: Делает плотную информацию более удобоваримой
Ограничения
- Структура затрат: Плата взимается в зависимости от объема обработки
- Требования к подключению: Зависит от стабильного доступа в Интернет
- Контекстные ограничения: Иногда могут быть упущены специализированные нюансы
- Чувствительность данных: Требуется осторожность при работе с конфиденциальной информацией
Общие вопросы
Поддерживаемые типы файлов
В настоящее время система обрабатывает стандартные документы TXT и PDF.
Ограничения по размеру
Интеллектуальная сегментация позволяет обобщать документы произвольного размера.
Спецификации моделей
В реализации используется модель OpenAI gpt-3.5-turbo-1106.
Руководство по реализации
Процесс обобщения PDF
Включите обработку PDF с помощью булевого флага:
document_summary = summarize_document('/document/location/file.pdf', is_pdf=True)
Связанная статья
 Генеральный директор DeepMind Хассабис: я сплю шесть часов в день, обычно чувствую прилив энергии около часа ночи.
В недавнем интервью журналу Fortune генеральный директор Google DeepMind Демис Хаассабис раскрыл свой нестандартный подход к отдыху и продуктивности. Хаассабис признался, что спит очень мало, распределяя свои бодрствующие часы на два отдельных рабочи
OpenAI и Anthropic борются за долю рынка, несмотря на снижение выручки
Несмотря на недавние сообщения о том, что OpenAI не достигла целевых показателей по выручке, что во вторник оказало давление на акции технологических компаний, частные инвесторы, вкладывающие средства
Соблюдение требований к автономным транспортным средствам в Калифорнии: новая эра штрафов, геозоны и 1 млн миль
Компания Guident эксплуатирует шаттл AuveTech в Южной Флориде, обслуживая маршрут протяженностью четыре мили в Вест-Палм-Бич и маршрут протяженностью одну милю в Бока-Ратоне с использованием своей тех
Рекомендации по связанным специальным темам
Музыкальная композиция
 Инструменты разделения стемов с использованием ИИ для создания ремиксов, подготовки образцов звука и формирования финальных версий караоке.
2026 год: лучшие и наиболее высоко оценённые инструменты для разделения аудиосигналов с использованием ИИ, отобранные специально для работы над ремиксами, подготовки образцов звука и создания караоке-версий. Эти мощные революционные инструменты проходят реальные тесты, обеспечивая точную изоляцию аудиосигналов и значительно повышая производительность. XIX.AI предоставляет еженедельно обновляемый бесплатный справочник сравнения платных и бесплатных решений, который поможет вам найти оптимальный вариант, соответствующий вашим потребностям. Ознакомьтесь с ним прямо сейчас, чтобы раскрыть потенциал ИИ в вашей работе.
 8 инструментов
 xix.ai
Анализ данных
ИИ-копилоты для SQL, предназначенные для создания панелей управления доходами, анализа воронки продаж и отслеживания показателей продуктов.
2026 год: лучшие AI-ассистенты для SQL, занявшие верхние строчки рейтингов! XIX.AI собрал мощный набор инструментов, регулярно обновляемый на основе реальных тестов. Эти неотъемлемые инструменты помогают создавать точные дашборды с данными о доходах, анализировать каналы продаж и оперативно отслеживать показатели продуктов, значительно повышая производительность. Ознакомьтесь сейчас, чтобы найти идеальный инструмент для принятия решений на основе данных! 238 символов
9 инструментов
xix.ai
Музыкальная композиция
Лучшие инструменты для написания мелодий с помощью ИИ для черновиков песен
2026 год: лучшие, топовые и высокооценённые инструменты ИИ для написания мелодий для черновиков песен! XIX.AI подобрал высокоэффективную коллекцию, меняющую правила игры, которая прошла строгие реальные испытания, чтобы обеспечить лучший опыт написания. Вы можете найти подробные сравнения бесплатных и платных версий, точные рейтинги и обязательные к использованию варианты, разработанные, чтобы помочь вам создавать потрясающие черновики песен без усилий и значительно повысить вашу творческую продуктивность. Исследуйте сейчас, чтобы найти свой идеальный инструмент!
8 инструментов
xix.ai
чат-бот
Лучшие инструменты для тренировки разговоров с помощью ИИ для подготовки к собеседованиям
2026 г. — новейшие, лучшие и наиболее высоко оцененные инструменты для тренировки разговорных навыков с помощью ИИ для подготовки к собеседованиям уже доступны на XIX.AI! Эта тщательно отобранная подборка включает мощные, революционные инструменты, прошедшие строгие реальные испытания и обеспечивающие точную обратную связь. Вы найдете сравнение бесплатных и платных вариантов, а также подробные рейтинги, которые помогут вам выбрать наиболее подходящий инструмент, повышающий вашу уверенность и навыки. Исследуйте сейчас, чтобы найти идеальный инструмент для успешного прохождения собеседований!
12 инструментов
xix.ai
Дизайн и искусство
Лучшие инструменты для переноса стилей с помощью ИИ для творческих экспериментов
2026: лучшие и самые популярные инструменты для переноса стиля с помощью ИИ для творческих экспериментов! XIX.AI подготовила подборку мощных, революционных инструментов, которые обязательно стоит попробовать: они демонстрируют исключительные результаты, подтвержденные реальными тестами и тщательным рейтингом. Эти ведущие решения помогают творческим людям значительно повысить продуктивность, ускоряя создание контента и открывая безграничные творческие возможности. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент и начать творить уже сегодня!
9 инструментов
xix.ai
Создание комиксов
Лучшие инструменты для создания диалоговых пузырей с помощью ИИ для визуального повествования
2026 года: самые новые и лучшие инструменты с ИИ для создания диалоговых пузырей в визуальном сторителлинге представлены на XIX.AI! В этой тщательно подобранной подборке представлены мощные, революционные инструменты, которые помогут творческим людям повысить продуктивность и преодолеть творческие кризисы. Ознакомьтесь со сравнением бесплатных и платных версий, посмотрите тесты в реальных условиях и изучите последние рейтинги, чтобы найти решения, которые обязательно стоит попробовать и которые идеально подходят для создания увлекательных визуальных историй. Исследуйте коллекцию прямо сейчас, чтобы найти свой идеальный инструмент!
10 инструментов
xix.ai

 Комментарии (2)
![RyanPerez]()
Honestly, summarizing massive text files is a game-changer for my workflow. I used to spend hours reading reports, but now I just feed them into the API and get concise summaries instantly. It’s like having a super-fast assistant who never gets tired. The guide is super helpful for beginners too. Highly recommend giving it a try if you deal with lots of data! 🚀
![EmmaTurner]()
この記事を読んで、大規模テキスト要約の可能性にますます興味が湧きました!特に基本テキストファイルから複雑な文章まで扱える柔軟性が素晴らしいですね。私は実際に大量のリサーチ論文を要約する必要があって、OpenAIの技術はまさに救世主です🎯。でも、長文要約の精度ってどれくらいなんだろう?細部のニュアンスが抜け落ちないか心配な面もあります。今度試してみたいと思います。
В современном мире, основанном на данных, эффективная обработка больших объемов информации имеет решающее значение. В этом комплексном руководстве показано, как использовать передовую технологию API OpenAI для обобщения различных текстовых источников, от простых TXT-файлов до сложных PDF-документов. Мы рассмотрим проверенные методы управления огромными документами, их стратегического сегментирования и создания проницательных резюме с помощью искусственного интеллекта. Эти методы идеально подходят для специалистов, работающих с техническими отчетами, академическими исследованиями или юридическими контрактами. Они предлагают практические решения для преобразования перегруженного контента в ценные сведения.
Ключевые моменты
Резюме TXT/PDF: Освоение методов сжатия документов для различных форматов файлов.
Преобразование PDF: Узнайте надежные методы извлечения текста из PDF-документов.
Сегментация документов: Откройте для себя оптимальные подходы к разделению больших файлов.
Интеграция API: Реализуйте мощные возможности обобщения OpenAI.
Учет кодировок: Поймите критические аспекты работы с наборами символов.
Синтез резюме: Объединение частичных резюме в целостные обзоры.
Методы обобщения документов с помощью ИИ
Преодоление проблем крупномасштабного суммирования
Резюмирование объемных документов сопряжено с серьезными препятствиями, которые традиционные методы зачастую не могут решить в должной мере. Современные решения на основе ИИ, в частности API OpenAI, предлагают масштабируемые альтернативы, которые позволяют преодолеть ограничения на обработку, сохраняя при этом точность.
Эффективное обобщение требует извлечения важной информации с сохранением контекста и смысла. Специалисты разных отраслей, в том числе ученые, анализирующие исследования, и адвокаты, изучающие контракты, выигрывают от использования этих передовых возможностей.
Методология включает в себя интеллектуальную сегментацию документов, позволяющую систематически обрабатывать управляемые участки контента, соблюдая при этом ограничения API. Такой структурированный подход гарантирует всесторонний охват без ущерба для критически важных деталей, независимо от длины исходного документа.
Основные компоненты процесса суммирования
Рабочий процесс сжатия документов включает в себя несколько основных элементов:
- Обработка входного документа: Поддержка форматов TXT и PDF с автоматическим распознаванием.
- Преобразование PDF: Преобразование содержимого PDF в анализируемый текст с сохранением целостности макета
- Сегментация содержимого: Стратегическое разделение больших документов на оптимальные блоки обработки
- Обработка API: Использование алгоритмов OpenAI для интеллектуального извлечения контента
- Интеграция резюме: Объединяет частичные резюме в единые, целостные обзоры
Детали реализации
Основная функция подведения итогов
Центральная функция summarize_document управляет всем конвейером обобщения:
Эта функция интеллектуально обрабатывает распознавание форматов, при необходимости делегирует задачи преобразования и определяет подходящие стратегии обобщения в зависимости от размера документа.
Методология преобразования PDF
В процессе извлечения текста из PDF используются специализированные библиотеки:
Используя PyPDF2, преобразование сохраняет структуру абзацев, эффективно удаляя ненужные элементы форматирования.
Обработка больших документов
Для работы с большим контентом в системе реализована стратегическая сегментация:
Этот подход сочетает предварительное обобщение фрагментов с окончательной консолидацией для сохранения контекста во всех объемных документах.
Сегментация контента
Алгоритм разбиения на куски обеспечивает оптимальный размер:
Настраиваемые размеры кусков позволяют использовать различные типы документов, соблюдая при этом ограничения API.
Интеграция искусственного интеллекта
Компонент взаимодействия с API обеспечивает интеллектуальное обобщение:
Тщательная настройка параметров обеспечивает баланс между сохранением деталей и краткостью.
Преимущества и соображения
Преимущества
- Масштабируемая обработка: Эффективно обрабатывает документы практически любого размера
- Интеллектуальное извлечение: Точная идентификация и сохранение важной информации
- Гибкость формата: Адаптация к различным структурам и макетам документов
- Повышение эффективности: Значительное сокращение времени на ручное обобщение
- Доступность: Делает плотную информацию более удобоваримой
Ограничения
- Структура затрат: Плата взимается в зависимости от объема обработки
- Требования к подключению: Зависит от стабильного доступа в Интернет
- Контекстные ограничения: Иногда могут быть упущены специализированные нюансы
- Чувствительность данных: Требуется осторожность при работе с конфиденциальной информацией
Общие вопросы
Поддерживаемые типы файлов
В настоящее время система обрабатывает стандартные документы TXT и PDF.
Ограничения по размеру
Интеллектуальная сегментация позволяет обобщать документы произвольного размера.
Спецификации моделей
В реализации используется модель OpenAI gpt-3.5-turbo-1106.
Руководство по реализации
Процесс обобщения PDF
Включите обработку PDF с помощью булевого флага:
document_summary = summarize_document('/document/location/file.pdf', is_pdf=True)








 Генеральный директор DeepMind Хассабис: я сплю шесть часов в день, обычно чувствую прилив энергии около часа ночи.
В недавнем интервью журналу Fortune генеральный директор Google DeepMind Демис Хаассабис раскрыл свой нестандартный подход к отдыху и продуктивности. Хаассабис признался, что спит очень мало, распределяя свои бодрствующие часы на два отдельных рабочи
 OpenAI и Anthropic борются за долю рынка, несмотря на снижение выручки
Несмотря на недавние сообщения о том, что OpenAI не достигла целевых показателей по выручке, что во вторник оказало давление на акции технологических компаний, частные инвесторы, вкладывающие средства
Соблюдение требований к автономным транспортным средствам в Калифорнии: новая эра штрафов, геозоны и 1 млн миль
Компания Guident эксплуатирует шаттл AuveTech в Южной Флориде, обслуживая маршрут протяженностью четыре мили в Вест-Палм-Бич и маршрут протяженностью одну милю в Бока-Ратоне с использованием своей тех

2026 год: лучшие и наиболее высоко оценённые инструменты для разделения аудиосигналов с использованием ИИ, отобранные специально для работы над ремиксами, подготовки образцов звука и создания караоке-версий. Эти мощные революционные инструменты проходят реальные тесты, обеспечивая точную изоляцию аудиосигналов и значительно повышая производительность. XIX.AI предоставляет еженедельно обновляемый бесплатный справочник сравнения платных и бесплатных решений, который поможет вам найти оптимальный вариант, соответствующий вашим потребностям. Ознакомьтесь с ним прямо сейчас, чтобы раскрыть потенциал ИИ в вашей работе.
8 инструментов
xix.ai

2026 год: лучшие AI-ассистенты для SQL, занявшие верхние строчки рейтингов! XIX.AI собрал мощный набор инструментов, регулярно обновляемый на основе реальных тестов. Эти неотъемлемые инструменты помогают создавать точные дашборды с данными о доходах, анализировать каналы продаж и оперативно отслеживать показатели продуктов, значительно повышая производительность. Ознакомьтесь сейчас, чтобы найти идеальный инструмент для принятия решений на основе данных! 238 символов
9 инструментов
xix.ai

2026 год: лучшие, топовые и высокооценённые инструменты ИИ для написания мелодий для черновиков песен! XIX.AI подобрал высокоэффективную коллекцию, меняющую правила игры, которая прошла строгие реальные испытания, чтобы обеспечить лучший опыт написания. Вы можете найти подробные сравнения бесплатных и платных версий, точные рейтинги и обязательные к использованию варианты, разработанные, чтобы помочь вам создавать потрясающие черновики песен без усилий и значительно повысить вашу творческую продуктивность. Исследуйте сейчас, чтобы найти свой идеальный инструмент!
8 инструментов
xix.ai

2026 г. — новейшие, лучшие и наиболее высоко оцененные инструменты для тренировки разговорных навыков с помощью ИИ для подготовки к собеседованиям уже доступны на XIX.AI! Эта тщательно отобранная подборка включает мощные, революционные инструменты, прошедшие строгие реальные испытания и обеспечивающие точную обратную связь. Вы найдете сравнение бесплатных и платных вариантов, а также подробные рейтинги, которые помогут вам выбрать наиболее подходящий инструмент, повышающий вашу уверенность и навыки. Исследуйте сейчас, чтобы найти идеальный инструмент для успешного прохождения собеседований!
12 инструментов
xix.ai

2026: лучшие и самые популярные инструменты для переноса стиля с помощью ИИ для творческих экспериментов! XIX.AI подготовила подборку мощных, революционных инструментов, которые обязательно стоит попробовать: они демонстрируют исключительные результаты, подтвержденные реальными тестами и тщательным рейтингом. Эти ведущие решения помогают творческим людям значительно повысить продуктивность, ускоряя создание контента и открывая безграничные творческие возможности. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент и начать творить уже сегодня!
9 инструментов
xix.ai

2026 года: самые новые и лучшие инструменты с ИИ для создания диалоговых пузырей в визуальном сторителлинге представлены на XIX.AI! В этой тщательно подобранной подборке представлены мощные, революционные инструменты, которые помогут творческим людям повысить продуктивность и преодолеть творческие кризисы. Ознакомьтесь со сравнением бесплатных и платных версий, посмотрите тесты в реальных условиях и изучите последние рейтинги, чтобы найти решения, которые обязательно стоит попробовать и которые идеально подходят для создания увлекательных визуальных историй. Исследуйте коллекцию прямо сейчас, чтобы найти свой идеальный инструмент!
10 инструментов
xix.ai

Honestly, summarizing massive text files is a game-changer for my workflow. I used to spend hours reading reports, but now I just feed them into the API and get concise summaries instantly. It’s like having a super-fast assistant who never gets tired. The guide is super helpful for beginners too. Highly recommend giving it a try if you deal with lots of data! 🚀
この記事を読んで、大規模テキスト要約の可能性にますます興味が湧きました!特に基本テキストファイルから複雑な文章まで扱える柔軟性が素晴らしいですね。私は実際に大量のリサーチ論文を要約する必要があって、OpenAIの技術はまさに救世主です🎯。でも、長文要約の精度ってどれくらいなんだろう?細部のニュアンスが抜け落ちないか心配な面もあります。今度試してみたいと思います。












