


 Дом
Google и NVIDIA открыли исходный код DiffusionGemma, что позволило в 4 раза ускорить инференцию на одной видеокарте
10 июня 2026 года компания Google представила DiffusionGemma — экспериментальную языковую модель с открытым исходным кодом, которая отходит от традиционной авторегрессионной парадигмы генерации текста по одному слову за раз. Она впервые применяет механизмы диффузии, используемые в области искусственного интеллекта для обработки изображений, к генерации текста: начиная со случайного шума и итеративно уточняя результат, она выводит 256 блоков токенов параллельно за каждый шаг.
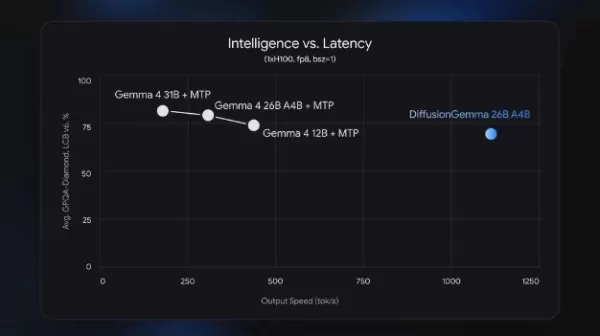
Что касается производительности оборудования, глубокие оптимизации NVIDIA позволяют модели работать почти в четыре раза быстрее, чем сопоставимые традиционные модели в режиме одного пользователя с одним графическим процессором. На графическом процессоре H100 она достигает скорости вывода до 1 000 токенов в секунду для одного запроса, а даже на высокопроизводительных потребительских графических процессорах, таких как RTX 5090, может превышать 700 токенов в секунду.
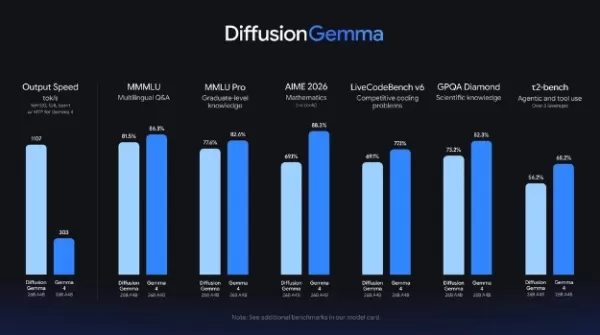
DiffusionGemma имеет 26 миллиардов параметров и использует архитектуру «смеси экспертов» (MoE), активируя лишь 3,8 миллиарда параметров за один шаг. Хотя качество и точность генерации текста в ней немного уступают традиционным моделям серии Gemma4 по стандартным тестам, её уникальная способность «учитывать весь блок» преодолевает ограничение авторегрессионных моделей, работающих только в обратном направлении. Поскольку все токены могут ссылаться друг на друга во время генерации, модель отлично справляется с задачами, связанными с нелинейными и структурированными данными, такими как автозаполнение текста, заполнение кода, решение судоку и обработка аминокислотных последовательностей.
Веса модели теперь доступны в открытом доступе на Hugging Face по лицензии Apache 2.0 и беспрепятственно работают с основными фреймворками для инференса, такими как vLLM и MLX. Данное исследование не только устраняет ограничения пропускной способности памяти, сдерживающие вычислительную мощность графических процессоров, но и открывает новый технический путь для будущих приложений искусственного интеллекта в области сложной логики и генерации нелинейного текста.
Связанная статья
 Генеральный директор DeepMind Хассабис: я сплю шесть часов в день, обычно чувствую прилив энергии около часа ночи.
В недавнем интервью журналу Fortune генеральный директор Google DeepMind Демис Хаассабис раскрыл свой нестандартный подход к отдыху и продуктивности. Хаассабис признался, что спит очень мало, распределяя свои бодрствующие часы на два отдельных рабочи
OpenAI и Anthropic борются за долю рынка, несмотря на снижение выручки
Несмотря на недавние сообщения о том, что OpenAI не достигла целевых показателей по выручке, что во вторник оказало давление на акции технологических компаний, частные инвесторы, вкладывающие средства
Соблюдение требований к автономным транспортным средствам в Калифорнии: новая эра штрафов, геозоны и 1 млн миль
Компания Guident эксплуатирует шаттл AuveTech в Южной Флориде, обслуживая маршрут протяженностью четыре мили в Вест-Палм-Бич и маршрут протяженностью одну милю в Бока-Ратоне с использованием своей тех
Рекомендации по связанным специальным темам
Создание видео
 Генераторы привлекательных заглавий для коротких видеороликов с использованием ИИ: для Reels, Shorts и кампаний по запуску продуктов
2026: лучшие современные генераторы захватывающих заставок для короткометражных видео на базе ИИ для Reels, Shorts и кампаний по запуску продуктов! XIX.AI подбирает самые высокооцененные и мощные инструменты, способные кардинально изменить ситуацию, которые в ходе реальных тестов демонстрируют результаты, которые обязательно стоит попробовать. Эта страница, обновляемая еженедельно, предлагает сравнительные рейтинги бесплатных и платных инструментов, чтобы помочь вам найти идеальное решение для повышения креативности и продуктивности при создании контента. Ознакомьтесь с ними прямо сейчас, чтобы раскрыть свой потенциал с помощью ИИ!
 11 инструментов
 xix.ai
письмо
Инструменты для создания плана статей с использованием ИИ при написании длинных текстов
2026: лучшие и самые популярные инструменты для создания планов статей с помощью ИИ для написания длинных текстов! В эту тщательно подобранную подборку вошли мощные, революционные инструменты, которые генерируют точные и структурированные планы, прошедшие проверку на практике, что позволяет значительно повысить эффективность написания текстов. XIX.AI входит в эту элитную подборку. Получите сравнение бесплатных и платных версий, чтобы выбрать идеальный инструмент. Изучите их прямо сейчас и раскройте свой потенциал с помощью ИИ!
9 инструментов
xix.ai
чат-бот
Лучшие приложения для ролевых чатов с ИИ для практики языка, подготовки к собеседованиям и ежедневной разговорной практики
2026 г. — новейшие, лучшие и наиболее рейтинговые приложения для ИИ-ролевых чатов, предназначенные для практики языка, подготовки к собеседованиям и ежедневной беглости речи! XIX.AI предлагает мощную коллекцию, меняющую правила игры: бесплатные и платные варианты, реальные тесты и обновляемые еженедельно рейтинги. Эти обязательные к использованию инструменты помогут вам улучшить навыки письма, преодолеть трудности с беглостью и повысить эффективность общения во всех повседневных ситуациях. Исследуйте сейчас, чтобы найти идеальный инструмент для развития вашего языка!
10 инструментов
xix.ai
Музыкальная композиция
Инструменты разделения стемов с использованием ИИ для создания ремиксов, подготовки образцов звука и формирования финальных версий караоке.
2026 год: лучшие и наиболее высоко оценённые инструменты для разделения аудиосигналов с использованием ИИ, отобранные специально для работы над ремиксами, подготовки образцов звука и создания караоке-версий. Эти мощные революционные инструменты проходят реальные тесты, обеспечивая точную изоляцию аудиосигналов и значительно повышая производительность. XIX.AI предоставляет еженедельно обновляемый бесплатный справочник сравнения платных и бесплатных решений, который поможет вам найти оптимальный вариант, соответствующий вашим потребностям. Ознакомьтесь с ним прямо сейчас, чтобы раскрыть потенциал ИИ в вашей работе.
8 инструментов
xix.ai
Анализ данных
ИИ-копилоты для SQL, предназначенные для создания панелей управления доходами, анализа воронки продаж и отслеживания показателей продуктов.
2026 год: лучшие AI-ассистенты для SQL, занявшие верхние строчки рейтингов! XIX.AI собрал мощный набор инструментов, регулярно обновляемый на основе реальных тестов. Эти неотъемлемые инструменты помогают создавать точные дашборды с данными о доходах, анализировать каналы продаж и оперативно отслеживать показатели продуктов, значительно повышая производительность. Ознакомьтесь сейчас, чтобы найти идеальный инструмент для принятия решений на основе данных! 238 символов
9 инструментов
xix.ai
Музыкальная композиция
Лучшие инструменты для написания мелодий с помощью ИИ для черновиков песен
2026 год: лучшие, топовые и высокооценённые инструменты ИИ для написания мелодий для черновиков песен! XIX.AI подобрал высокоэффективную коллекцию, меняющую правила игры, которая прошла строгие реальные испытания, чтобы обеспечить лучший опыт написания. Вы можете найти подробные сравнения бесплатных и платных версий, точные рейтинги и обязательные к использованию варианты, разработанные, чтобы помочь вам создавать потрясающие черновики песен без усилий и значительно повысить вашу творческую продуктивность. Исследуйте сейчас, чтобы найти свой идеальный инструмент!
8 инструментов
xix.ai

 Комментарии (0)
10 июня 2026 года компания Google представила DiffusionGemma — экспериментальную языковую модель с открытым исходным кодом, которая отходит от традиционной авторегрессионной парадигмы генерации текста по одному слову за раз. Она впервые применяет механизмы диффузии, используемые в области искусственного интеллекта для обработки изображений, к генерации текста: начиная со случайного шума и итеративно уточняя результат, она выводит 256 блоков токенов параллельно за каждый шаг.
Что касается производительности оборудования, глубокие оптимизации NVIDIA позволяют модели работать почти в четыре раза быстрее, чем сопоставимые традиционные модели в режиме одного пользователя с одним графическим процессором. На графическом процессоре H100 она достигает скорости вывода до 1 000 токенов в секунду для одного запроса, а даже на высокопроизводительных потребительских графических процессорах, таких как RTX 5090, может превышать 700 токенов в секунду.
DiffusionGemma имеет 26 миллиардов параметров и использует архитектуру «смеси экспертов» (MoE), активируя лишь 3,8 миллиарда параметров за один шаг. Хотя качество и точность генерации текста в ней немного уступают традиционным моделям серии Gemma4 по стандартным тестам, её уникальная способность «учитывать весь блок» преодолевает ограничение авторегрессионных моделей, работающих только в обратном направлении. Поскольку все токены могут ссылаться друг на друга во время генерации, модель отлично справляется с задачами, связанными с нелинейными и структурированными данными, такими как автозаполнение текста, заполнение кода, решение судоку и обработка аминокислотных последовательностей.
Веса модели теперь доступны в открытом доступе на Hugging Face по лицензии Apache 2.0 и беспрепятственно работают с основными фреймворками для инференса, такими как vLLM и MLX. Данное исследование не только устраняет ограничения пропускной способности памяти, сдерживающие вычислительную мощность графических процессоров, но и открывает новый технический путь для будущих приложений искусственного интеллекта в области сложной логики и генерации нелинейного текста.








 Генеральный директор DeepMind Хассабис: я сплю шесть часов в день, обычно чувствую прилив энергии около часа ночи.
В недавнем интервью журналу Fortune генеральный директор Google DeepMind Демис Хаассабис раскрыл свой нестандартный подход к отдыху и продуктивности. Хаассабис признался, что спит очень мало, распределяя свои бодрствующие часы на два отдельных рабочи
 OpenAI и Anthropic борются за долю рынка, несмотря на снижение выручки
Несмотря на недавние сообщения о том, что OpenAI не достигла целевых показателей по выручке, что во вторник оказало давление на акции технологических компаний, частные инвесторы, вкладывающие средства
Соблюдение требований к автономным транспортным средствам в Калифорнии: новая эра штрафов, геозоны и 1 млн миль
Компания Guident эксплуатирует шаттл AuveTech в Южной Флориде, обслуживая маршрут протяженностью четыре мили в Вест-Палм-Бич и маршрут протяженностью одну милю в Бока-Ратоне с использованием своей тех

2026: лучшие современные генераторы захватывающих заставок для короткометражных видео на базе ИИ для Reels, Shorts и кампаний по запуску продуктов! XIX.AI подбирает самые высокооцененные и мощные инструменты, способные кардинально изменить ситуацию, которые в ходе реальных тестов демонстрируют результаты, которые обязательно стоит попробовать. Эта страница, обновляемая еженедельно, предлагает сравнительные рейтинги бесплатных и платных инструментов, чтобы помочь вам найти идеальное решение для повышения креативности и продуктивности при создании контента. Ознакомьтесь с ними прямо сейчас, чтобы раскрыть свой потенциал с помощью ИИ!
11 инструментов
xix.ai

2026: лучшие и самые популярные инструменты для создания планов статей с помощью ИИ для написания длинных текстов! В эту тщательно подобранную подборку вошли мощные, революционные инструменты, которые генерируют точные и структурированные планы, прошедшие проверку на практике, что позволяет значительно повысить эффективность написания текстов. XIX.AI входит в эту элитную подборку. Получите сравнение бесплатных и платных версий, чтобы выбрать идеальный инструмент. Изучите их прямо сейчас и раскройте свой потенциал с помощью ИИ!
9 инструментов
xix.ai

2026 г. — новейшие, лучшие и наиболее рейтинговые приложения для ИИ-ролевых чатов, предназначенные для практики языка, подготовки к собеседованиям и ежедневной беглости речи! XIX.AI предлагает мощную коллекцию, меняющую правила игры: бесплатные и платные варианты, реальные тесты и обновляемые еженедельно рейтинги. Эти обязательные к использованию инструменты помогут вам улучшить навыки письма, преодолеть трудности с беглостью и повысить эффективность общения во всех повседневных ситуациях. Исследуйте сейчас, чтобы найти идеальный инструмент для развития вашего языка!
10 инструментов
xix.ai

2026 год: лучшие и наиболее высоко оценённые инструменты для разделения аудиосигналов с использованием ИИ, отобранные специально для работы над ремиксами, подготовки образцов звука и создания караоке-версий. Эти мощные революционные инструменты проходят реальные тесты, обеспечивая точную изоляцию аудиосигналов и значительно повышая производительность. XIX.AI предоставляет еженедельно обновляемый бесплатный справочник сравнения платных и бесплатных решений, который поможет вам найти оптимальный вариант, соответствующий вашим потребностям. Ознакомьтесь с ним прямо сейчас, чтобы раскрыть потенциал ИИ в вашей работе.
8 инструментов
xix.ai

2026 год: лучшие AI-ассистенты для SQL, занявшие верхние строчки рейтингов! XIX.AI собрал мощный набор инструментов, регулярно обновляемый на основе реальных тестов. Эти неотъемлемые инструменты помогают создавать точные дашборды с данными о доходах, анализировать каналы продаж и оперативно отслеживать показатели продуктов, значительно повышая производительность. Ознакомьтесь сейчас, чтобы найти идеальный инструмент для принятия решений на основе данных! 238 символов
9 инструментов
xix.ai

2026 год: лучшие, топовые и высокооценённые инструменты ИИ для написания мелодий для черновиков песен! XIX.AI подобрал высокоэффективную коллекцию, меняющую правила игры, которая прошла строгие реальные испытания, чтобы обеспечить лучший опыт написания. Вы можете найти подробные сравнения бесплатных и платных версий, точные рейтинги и обязательные к использованию варианты, разработанные, чтобы помочь вам создавать потрясающие черновики песен без усилий и значительно повысить вашу творческую продуктивность. Исследуйте сейчас, чтобы найти свой идеальный инструмент!
8 инструментов
xix.ai












