


 Lar
Google e NVIDIA tornam o DiffusionGemma de código aberto, acelerando a inferência com uma única placa em 4 vezes
Em 10 de junho de 2026, o Google lançou o DiffusionGemma, um modelo de linguagem experimental de código aberto que rompe com o paradigma autorregressivo tradicional de geração de texto, palavra por palavra. Ele é pioneiro no uso de mecanismos de difusão da IA de imagens na geração de texto, partindo de ruído aleatório e refinando-se iterativamente para produzir blocos de 256 tokens em paralelo a cada etapa.
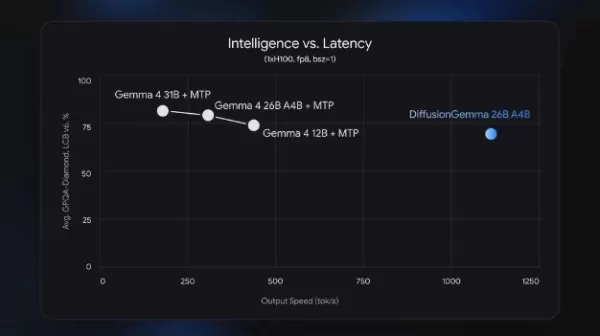
Em termos de desempenho de hardware, as otimizações profundas da NVIDIA permitem que o modelo seja executado quase quatro vezes mais rápido do que modelos tradicionais comparáveis no modo de usuário único com uma única GPU. Em uma GPU H100, ele atinge velocidades de saída de até 1.000 tokens por segundo para uma única solicitação e, mesmo em GPUs de consumo de ponta, como a RTX 5090, pode ultrapassar 700 tokens por segundo.
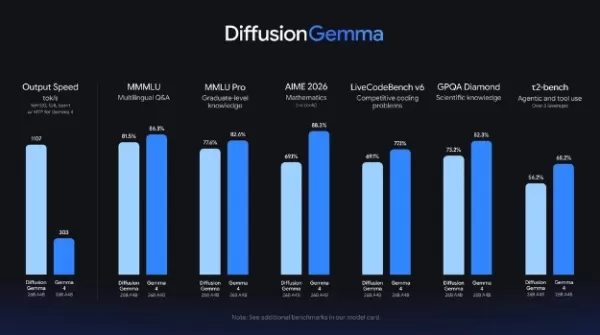
O DiffusionGemma possui 26 bilhões de parâmetros e utiliza uma arquitetura de mistura de especialistas (MoE), ativando apenas 3,8 bilhões de parâmetros por etapa. Embora sua qualidade e precisão na geração de texto fiquem ligeiramente atrás dos modelos tradicionais da série Gemma4 em benchmarks padrão, sua exclusiva “consciência de bloco completo” supera a limitação de processamento apenas retroativo dos modelos autorregressivos. Como todos os tokens podem fazer referência uns aos outros durante a geração, ele se destaca em tarefas que envolvem dados não lineares e estruturados, como preenchimento de texto, preenchimento de código, resolução de Sudoku e processamento de sequências de aminoácidos.
Os pesos do modelo agora estão disponíveis em código aberto no Hugging Face sob a licença Apache 2.0 e funcionam perfeitamente com estruturas de inferência convencionais, como vLLM e MLX. Essa exploração não apenas elimina as restrições de largura de banda de memória no poder de computação da GPU, mas também abre um novo caminho técnico para futuras aplicações de IA em lógica complexa e geração de texto não linear.
Artigo relacionado
 iFLYTEK Apresenta o Modelo Grande Geral Spark X2.5
Em 1º de setembro, a iFlytek lançará como código aberto dois modelos de linguagem de grande escala focados em dispositivos de borda, o Xinghuo X2.5-4B e o Xinghuo X2.5-1.7B, conforme o mais recente anúncio oficial. Ambos os modelos suportam nativamen
Meta Remove Funcionalidade de Edição de Fotos por IA Após Reação Negativa dos Usuários
A Meta, gigante das redes sociais, está novamente envolvida em um debate público sobre o delicado equilíbrio entre inteligência artificial e privacidade dos usuários. De acordo com a TechCrunch, o Superintelligence Labs da Meta apresentou um novo ger
CEO da DeepMind, Hassabis: Durmo seis horas por dia, geralmente me sinto energético por volta da 1h
O Fortune recentemente publicou uma entrevista com Demis Hassabis, CEO da Google DeepMind, revelando sua abordagem incomum para descanso e produtividade. Hassabis revelou que dorme muito pouco, estruturando suas horas acordadas em dois blocos de trab
Recomendações de tópicos especiais relacionados
Criação de Animação
 Ferramentas de animação de cenas com IA para conteúdo de mídias sociais
As melhores e mais bem avaliadas ferramentas de 2026 para animação de cenas com IA para conteúdo de mídias sociais foram selecionadas aqui pela XIX.AI. Essas ferramentas poderosas e revolucionárias oferecem testes práticos e uma comparação detalhada entre versões gratuitas e pagas, ajudando os criadores a aumentar significativamente sua produtividade. Explore agora para descobrir sua vantagem com a IA.
 9 ferramentas
 xix.ai
Criação de vídeo
Geradores de ganchos para vídeos curtos com IA para Reels, Shorts e campanhas de lançamento de produtos
Os melhores geradores de ganchos para vídeos curtos com IA de 2026 para Reels, Shorts e campanhas de lançamento de produtos! A XIX.AI seleciona as ferramentas mais bem avaliadas, poderosas e revolucionárias, que oferecem resultados imperdíveis comprovados por testes reais. Esta página, atualizada semanalmente, apresenta rankings comparativos entre opções gratuitas e pagas para ajudar você a encontrar a solução perfeita para impulsionar a criatividade e a produtividade do seu conteúdo. Explore agora para descobrir sua vantagem com IA!
11 ferramentas
xix.ai
escrita
Ferramentas de IA para esboço de artigos em formato longo
2026: As melhores e mais bem avaliadas ferramentas de esboço com IA para redação de textos longos! Esta coleção selecionada apresenta ferramentas poderosas e revolucionárias que geram esboços precisos e estruturados, comprovados em testes reais, para aumentar significativamente a eficiência na redação. A XIX.AI faz parte dessa seleção de elite. Veja uma comparação entre as versões gratuita e paga para ajudá-lo a escolher a ferramenta perfeita. Explore agora e descubra sua vantagem com a IA!
9 ferramentas
xix.ai
chatbot
Melhores aplicativos de chat de interpretação de papéis com IA para prática de idiomas, preparação para entrevistas e fluência diária
2026 Últimas Melhores Aplicativos de Chat de Interpretação de Papéis por IA Mais Bem Avaliados para Prática de Idiomas, Preparação para Entrevistas e Fluência Diária! O XIX.AI seleciona uma poderosa coleção revolucionária que oferece comparação entre gratuito e pago, testes do mundo real e classificações atualizadas semanalmente. Essas ferramentas imperdíveis ajudam você a aprimorar suas habilidades de escrita, superar desafios de fluência e melhorar a eficiência da comunicação em todos os cenários diários. Explore agora para descobrir sua ferramenta perfeita para o crescimento do idioma!
10 ferramentas
xix.ai
Composição musical
Ferramentas de separação de stems com IA para produção de remixes, preparação de samples e masters de karaokê
As melhores e mais bem avaliadas ferramentas de separação de faixas com IA de 2026, selecionadas especialmente para produção de remixes, preparação de samples e masters de karaokê. Essas ferramentas poderosas e revolucionárias passaram por testes práticos para oferecer isolamento de áudio preciso, aumentando significativamente a produtividade. A XIX.AI oferece um guia comparativo entre versões gratuitas e pagas, atualizado semanalmente, para ajudá-lo a encontrar a solução imperdível que melhor atenda às suas necessidades. Explore agora para aproveitar ao máximo as vantagens da IA.
8 ferramentas
xix.ai
Análise de dados
Copilotos de IA para SQL voltados para painéis de receita, análise de funis e métricas de produtos
2026: Os melhores copilotos AI para SQL, atualizados e classificados entre os melhores! A XIX.AI reúne uma coleção poderosa e revolucionária, com testes em ambiente real atualizados semanalmente. Essas ferramentas indispensáveis ajudam a gerar painéis de controle de receita precisos, analisar funis de vendas e rastrear métricas de produtos de forma rápida, aumentando significativamente a produtividade. Explore agora e encontre a ferramenta perfeita para tomada de decisões baseadas em dados! 238 caracteres
9 ferramentas
xix.ai

 Comentários (0)
Em 10 de junho de 2026, o Google lançou o DiffusionGemma, um modelo de linguagem experimental de código aberto que rompe com o paradigma autorregressivo tradicional de geração de texto, palavra por palavra. Ele é pioneiro no uso de mecanismos de difusão da IA de imagens na geração de texto, partindo de ruído aleatório e refinando-se iterativamente para produzir blocos de 256 tokens em paralelo a cada etapa.
Em termos de desempenho de hardware, as otimizações profundas da NVIDIA permitem que o modelo seja executado quase quatro vezes mais rápido do que modelos tradicionais comparáveis no modo de usuário único com uma única GPU. Em uma GPU H100, ele atinge velocidades de saída de até 1.000 tokens por segundo para uma única solicitação e, mesmo em GPUs de consumo de ponta, como a RTX 5090, pode ultrapassar 700 tokens por segundo.
O DiffusionGemma possui 26 bilhões de parâmetros e utiliza uma arquitetura de mistura de especialistas (MoE), ativando apenas 3,8 bilhões de parâmetros por etapa. Embora sua qualidade e precisão na geração de texto fiquem ligeiramente atrás dos modelos tradicionais da série Gemma4 em benchmarks padrão, sua exclusiva “consciência de bloco completo” supera a limitação de processamento apenas retroativo dos modelos autorregressivos. Como todos os tokens podem fazer referência uns aos outros durante a geração, ele se destaca em tarefas que envolvem dados não lineares e estruturados, como preenchimento de texto, preenchimento de código, resolução de Sudoku e processamento de sequências de aminoácidos.
Os pesos do modelo agora estão disponíveis em código aberto no Hugging Face sob a licença Apache 2.0 e funcionam perfeitamente com estruturas de inferência convencionais, como vLLM e MLX. Essa exploração não apenas elimina as restrições de largura de banda de memória no poder de computação da GPU, mas também abre um novo caminho técnico para futuras aplicações de IA em lógica complexa e geração de texto não linear.








 iFLYTEK Apresenta o Modelo Grande Geral Spark X2.5
Em 1º de setembro, a iFlytek lançará como código aberto dois modelos de linguagem de grande escala focados em dispositivos de borda, o Xinghuo X2.5-4B e o Xinghuo X2.5-1.7B, conforme o mais recente anúncio oficial. Ambos os modelos suportam nativamen
 Meta Remove Funcionalidade de Edição de Fotos por IA Após Reação Negativa dos Usuários
A Meta, gigante das redes sociais, está novamente envolvida em um debate público sobre o delicado equilíbrio entre inteligência artificial e privacidade dos usuários. De acordo com a TechCrunch, o Superintelligence Labs da Meta apresentou um novo ger
 CEO da DeepMind, Hassabis: Durmo seis horas por dia, geralmente me sinto energético por volta da 1h
O Fortune recentemente publicou uma entrevista com Demis Hassabis, CEO da Google DeepMind, revelando sua abordagem incomum para descanso e produtividade. Hassabis revelou que dorme muito pouco, estruturando suas horas acordadas em dois blocos de trab

As melhores e mais bem avaliadas ferramentas de 2026 para animação de cenas com IA para conteúdo de mídias sociais foram selecionadas aqui pela XIX.AI. Essas ferramentas poderosas e revolucionárias oferecem testes práticos e uma comparação detalhada entre versões gratuitas e pagas, ajudando os criadores a aumentar significativamente sua produtividade. Explore agora para descobrir sua vantagem com a IA.
9 ferramentas
xix.ai

Os melhores geradores de ganchos para vídeos curtos com IA de 2026 para Reels, Shorts e campanhas de lançamento de produtos! A XIX.AI seleciona as ferramentas mais bem avaliadas, poderosas e revolucionárias, que oferecem resultados imperdíveis comprovados por testes reais. Esta página, atualizada semanalmente, apresenta rankings comparativos entre opções gratuitas e pagas para ajudar você a encontrar a solução perfeita para impulsionar a criatividade e a produtividade do seu conteúdo. Explore agora para descobrir sua vantagem com IA!
11 ferramentas
xix.ai

2026: As melhores e mais bem avaliadas ferramentas de esboço com IA para redação de textos longos! Esta coleção selecionada apresenta ferramentas poderosas e revolucionárias que geram esboços precisos e estruturados, comprovados em testes reais, para aumentar significativamente a eficiência na redação. A XIX.AI faz parte dessa seleção de elite. Veja uma comparação entre as versões gratuita e paga para ajudá-lo a escolher a ferramenta perfeita. Explore agora e descubra sua vantagem com a IA!
9 ferramentas
xix.ai

2026 Últimas Melhores Aplicativos de Chat de Interpretação de Papéis por IA Mais Bem Avaliados para Prática de Idiomas, Preparação para Entrevistas e Fluência Diária! O XIX.AI seleciona uma poderosa coleção revolucionária que oferece comparação entre gratuito e pago, testes do mundo real e classificações atualizadas semanalmente. Essas ferramentas imperdíveis ajudam você a aprimorar suas habilidades de escrita, superar desafios de fluência e melhorar a eficiência da comunicação em todos os cenários diários. Explore agora para descobrir sua ferramenta perfeita para o crescimento do idioma!
10 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de separação de faixas com IA de 2026, selecionadas especialmente para produção de remixes, preparação de samples e masters de karaokê. Essas ferramentas poderosas e revolucionárias passaram por testes práticos para oferecer isolamento de áudio preciso, aumentando significativamente a produtividade. A XIX.AI oferece um guia comparativo entre versões gratuitas e pagas, atualizado semanalmente, para ajudá-lo a encontrar a solução imperdível que melhor atenda às suas necessidades. Explore agora para aproveitar ao máximo as vantagens da IA.
8 ferramentas
xix.ai

2026: Os melhores copilotos AI para SQL, atualizados e classificados entre os melhores! A XIX.AI reúne uma coleção poderosa e revolucionária, com testes em ambiente real atualizados semanalmente. Essas ferramentas indispensáveis ajudam a gerar painéis de controle de receita precisos, analisar funis de vendas e rastrear métricas de produtos de forma rápida, aumentando significativamente a produtividade. Explore agora e encontre a ferramenta perfeita para tomada de decisões baseadas em dados! 238 caracteres
9 ferramentas
xix.ai












