


 Дом
Alibaba Tongyi представляет голосовую модель с управлением на естественном языке «FreeStyle»
Сегодня команда Alibaba Tongyi Lab по разработке речевых технологий представила две революционные модели генерации голоса: Fun-CosyVoice3.5 и Fun-AudioGen-VD. Отличительной особенностью этих моделей является поддержка команд «FreeStyle». Вместо сложной настройки параметров пользователи могут точно контролировать стили вокального выражения или создавать сложные аудиосцены с нуля, используя простые описания на естественном языке.
Каждая модель служит определенным целям:
Fun-CosyVoice3.5: многоязычное воспроизведение и тонкое управление
Эта усовершенствованная версия CosyVoice достигает прорыва в понимании нюансов речевой экспрессии.
Генерация на основе команд: пользователи могут вводить инструкции, такие как «говорить более уверенно» или «замедлить речь с эмоциональными колебаниями», для корректировки голоса в режиме реального времени.
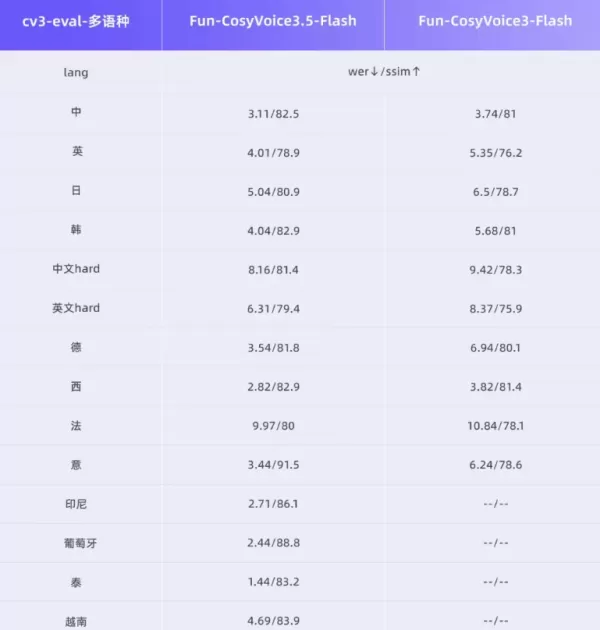
Расширение языкового диапазона: добавлена поддержка тайского, индонезийского, португальского и вьетнамского языков, что позволяет сохранить лидирующие в отрасли показатели точности транскрипции (WER) и схожести голоса на 13 языках.
Оптимизация редких символов: специальное обучение снизило уровень ошибок для редких символов с 15,2% до 5,3%.
Повышение производительности: задержка первого пакета уменьшилась на 35%, что значительно улучшило плавность взаимодействия в реальном времени.
Fun-AudioGen-VD: комплексное звуковое проектирование
Эта модель действует как «аудиорежиссер», генерируя интегрированный звук, сочетающий «персонажей + окружение».
Настройка голоса: Укажите пол, возраст, акцент и подробные характеристики, такие как «хриплый, глубокий или низкий» голос.
Эмоции и ролевые игры: имитирует роли, включая агентов службы поддержки клиентов, дикторов и детей, даже передавая сложные состояния, такие как «внешнее спокойствие с внутренним напряжением».
Иммерсивные среды: добавляет фоновые звуки (хаос на поле боя, шум в кафе) и пространственные эффекты (реверберация собора, подводная акустика) для полной пространственной симуляции.
Tongyi Lab отмечает, что эти модели демократизируют создание высококачественного голоса, предлагая мощную поддержку ИИ для подкастинга, разработки игр и постпродакшна фильмов.
Связанная статья
 Генеральный директор DeepMind Хассабис: я сплю шесть часов в день, обычно чувствую прилив энергии около часа ночи.
В недавнем интервью журналу Fortune генеральный директор Google DeepMind Демис Хаассабис раскрыл свой нестандартный подход к отдыху и продуктивности. Хаассабис признался, что спит очень мало, распределяя свои бодрствующие часы на два отдельных рабочи
OpenAI и Anthropic борются за долю рынка, несмотря на снижение выручки
Несмотря на недавние сообщения о том, что OpenAI не достигла целевых показателей по выручке, что во вторник оказало давление на акции технологических компаний, частные инвесторы, вкладывающие средства
Соблюдение требований к автономным транспортным средствам в Калифорнии: новая эра штрафов, геозоны и 1 млн миль
Компания Guident эксплуатирует шаттл AuveTech в Южной Флориде, обслуживая маршрут протяженностью четыре мили в Вест-Палм-Бич и маршрут протяженностью одну милю в Бока-Ратоне с использованием своей тех
Рекомендации по связанным специальным темам
письмо
 Инструменты для создания плана статей с использованием ИИ при написании длинных текстов
2026: лучшие и самые популярные инструменты для создания планов статей с помощью ИИ для написания длинных текстов! В эту тщательно подобранную подборку вошли мощные, революционные инструменты, которые генерируют точные и структурированные планы, прошедшие проверку на практике, что позволяет значительно повысить эффективность написания текстов. XIX.AI входит в эту элитную подборку. Получите сравнение бесплатных и платных версий, чтобы выбрать идеальный инструмент. Изучите их прямо сейчас и раскройте свой потенциал с помощью ИИ!
 9 инструментов
 xix.ai
чат-бот
Лучшие приложения для ролевых чатов с ИИ для практики языка, подготовки к собеседованиям и ежедневной разговорной практики
2026 г. — новейшие, лучшие и наиболее рейтинговые приложения для ИИ-ролевых чатов, предназначенные для практики языка, подготовки к собеседованиям и ежедневной беглости речи! XIX.AI предлагает мощную коллекцию, меняющую правила игры: бесплатные и платные варианты, реальные тесты и обновляемые еженедельно рейтинги. Эти обязательные к использованию инструменты помогут вам улучшить навыки письма, преодолеть трудности с беглостью и повысить эффективность общения во всех повседневных ситуациях. Исследуйте сейчас, чтобы найти идеальный инструмент для развития вашего языка!
10 инструментов
xix.ai
Музыкальная композиция
Инструменты разделения стемов с использованием ИИ для создания ремиксов, подготовки образцов звука и формирования финальных версий караоке.
2026 год: лучшие и наиболее высоко оценённые инструменты для разделения аудиосигналов с использованием ИИ, отобранные специально для работы над ремиксами, подготовки образцов звука и создания караоке-версий. Эти мощные революционные инструменты проходят реальные тесты, обеспечивая точную изоляцию аудиосигналов и значительно повышая производительность. XIX.AI предоставляет еженедельно обновляемый бесплатный справочник сравнения платных и бесплатных решений, который поможет вам найти оптимальный вариант, соответствующий вашим потребностям. Ознакомьтесь с ним прямо сейчас, чтобы раскрыть потенциал ИИ в вашей работе.
8 инструментов
xix.ai
Анализ данных
ИИ-копилоты для SQL, предназначенные для создания панелей управления доходами, анализа воронки продаж и отслеживания показателей продуктов.
2026 год: лучшие AI-ассистенты для SQL, занявшие верхние строчки рейтингов! XIX.AI собрал мощный набор инструментов, регулярно обновляемый на основе реальных тестов. Эти неотъемлемые инструменты помогают создавать точные дашборды с данными о доходах, анализировать каналы продаж и оперативно отслеживать показатели продуктов, значительно повышая производительность. Ознакомьтесь сейчас, чтобы найти идеальный инструмент для принятия решений на основе данных! 238 символов
9 инструментов
xix.ai
Музыкальная композиция
Лучшие инструменты для написания мелодий с помощью ИИ для черновиков песен
2026 год: лучшие, топовые и высокооценённые инструменты ИИ для написания мелодий для черновиков песен! XIX.AI подобрал высокоэффективную коллекцию, меняющую правила игры, которая прошла строгие реальные испытания, чтобы обеспечить лучший опыт написания. Вы можете найти подробные сравнения бесплатных и платных версий, точные рейтинги и обязательные к использованию варианты, разработанные, чтобы помочь вам создавать потрясающие черновики песен без усилий и значительно повысить вашу творческую продуктивность. Исследуйте сейчас, чтобы найти свой идеальный инструмент!
8 инструментов
xix.ai
чат-бот
Лучшие инструменты для тренировки разговоров с помощью ИИ для подготовки к собеседованиям
2026 г. — новейшие, лучшие и наиболее высоко оцененные инструменты для тренировки разговорных навыков с помощью ИИ для подготовки к собеседованиям уже доступны на XIX.AI! Эта тщательно отобранная подборка включает мощные, революционные инструменты, прошедшие строгие реальные испытания и обеспечивающие точную обратную связь. Вы найдете сравнение бесплатных и платных вариантов, а также подробные рейтинги, которые помогут вам выбрать наиболее подходящий инструмент, повышающий вашу уверенность и навыки. Исследуйте сейчас, чтобы найти идеальный инструмент для успешного прохождения собеседований!
12 инструментов
xix.ai

 Комментарии (0)
Сегодня команда Alibaba Tongyi Lab по разработке речевых технологий представила две революционные модели генерации голоса: Fun-CosyVoice3.5 и Fun-AudioGen-VD. Отличительной особенностью этих моделей является поддержка команд «FreeStyle». Вместо сложной настройки параметров пользователи могут точно контролировать стили вокального выражения или создавать сложные аудиосцены с нуля, используя простые описания на естественном языке.
Каждая модель служит определенным целям:
Fun-CosyVoice3.5: многоязычное воспроизведение и тонкое управление
Эта усовершенствованная версия CosyVoice достигает прорыва в понимании нюансов речевой экспрессии.
Генерация на основе команд: пользователи могут вводить инструкции, такие как «говорить более уверенно» или «замедлить речь с эмоциональными колебаниями», для корректировки голоса в режиме реального времени.
Расширение языкового диапазона: добавлена поддержка тайского, индонезийского, португальского и вьетнамского языков, что позволяет сохранить лидирующие в отрасли показатели точности транскрипции (WER) и схожести голоса на 13 языках.
Оптимизация редких символов: специальное обучение снизило уровень ошибок для редких символов с 15,2% до 5,3%.
Повышение производительности: задержка первого пакета уменьшилась на 35%, что значительно улучшило плавность взаимодействия в реальном времени.
Fun-AudioGen-VD: комплексное звуковое проектирование
Эта модель действует как «аудиорежиссер», генерируя интегрированный звук, сочетающий «персонажей + окружение».
Настройка голоса: Укажите пол, возраст, акцент и подробные характеристики, такие как «хриплый, глубокий или низкий» голос.
Эмоции и ролевые игры: имитирует роли, включая агентов службы поддержки клиентов, дикторов и детей, даже передавая сложные состояния, такие как «внешнее спокойствие с внутренним напряжением».
Иммерсивные среды: добавляет фоновые звуки (хаос на поле боя, шум в кафе) и пространственные эффекты (реверберация собора, подводная акустика) для полной пространственной симуляции.
Tongyi Lab отмечает, что эти модели демократизируют создание высококачественного голоса, предлагая мощную поддержку ИИ для подкастинга, разработки игр и постпродакшна фильмов.








 Генеральный директор DeepMind Хассабис: я сплю шесть часов в день, обычно чувствую прилив энергии около часа ночи.
В недавнем интервью журналу Fortune генеральный директор Google DeepMind Демис Хаассабис раскрыл свой нестандартный подход к отдыху и продуктивности. Хаассабис признался, что спит очень мало, распределяя свои бодрствующие часы на два отдельных рабочи
 OpenAI и Anthropic борются за долю рынка, несмотря на снижение выручки
Несмотря на недавние сообщения о том, что OpenAI не достигла целевых показателей по выручке, что во вторник оказало давление на акции технологических компаний, частные инвесторы, вкладывающие средства
Соблюдение требований к автономным транспортным средствам в Калифорнии: новая эра штрафов, геозоны и 1 млн миль
Компания Guident эксплуатирует шаттл AuveTech в Южной Флориде, обслуживая маршрут протяженностью четыре мили в Вест-Палм-Бич и маршрут протяженностью одну милю в Бока-Ратоне с использованием своей тех

2026: лучшие и самые популярные инструменты для создания планов статей с помощью ИИ для написания длинных текстов! В эту тщательно подобранную подборку вошли мощные, революционные инструменты, которые генерируют точные и структурированные планы, прошедшие проверку на практике, что позволяет значительно повысить эффективность написания текстов. XIX.AI входит в эту элитную подборку. Получите сравнение бесплатных и платных версий, чтобы выбрать идеальный инструмент. Изучите их прямо сейчас и раскройте свой потенциал с помощью ИИ!
9 инструментов
xix.ai

2026 г. — новейшие, лучшие и наиболее рейтинговые приложения для ИИ-ролевых чатов, предназначенные для практики языка, подготовки к собеседованиям и ежедневной беглости речи! XIX.AI предлагает мощную коллекцию, меняющую правила игры: бесплатные и платные варианты, реальные тесты и обновляемые еженедельно рейтинги. Эти обязательные к использованию инструменты помогут вам улучшить навыки письма, преодолеть трудности с беглостью и повысить эффективность общения во всех повседневных ситуациях. Исследуйте сейчас, чтобы найти идеальный инструмент для развития вашего языка!
10 инструментов
xix.ai

2026 год: лучшие и наиболее высоко оценённые инструменты для разделения аудиосигналов с использованием ИИ, отобранные специально для работы над ремиксами, подготовки образцов звука и создания караоке-версий. Эти мощные революционные инструменты проходят реальные тесты, обеспечивая точную изоляцию аудиосигналов и значительно повышая производительность. XIX.AI предоставляет еженедельно обновляемый бесплатный справочник сравнения платных и бесплатных решений, который поможет вам найти оптимальный вариант, соответствующий вашим потребностям. Ознакомьтесь с ним прямо сейчас, чтобы раскрыть потенциал ИИ в вашей работе.
8 инструментов
xix.ai

2026 год: лучшие AI-ассистенты для SQL, занявшие верхние строчки рейтингов! XIX.AI собрал мощный набор инструментов, регулярно обновляемый на основе реальных тестов. Эти неотъемлемые инструменты помогают создавать точные дашборды с данными о доходах, анализировать каналы продаж и оперативно отслеживать показатели продуктов, значительно повышая производительность. Ознакомьтесь сейчас, чтобы найти идеальный инструмент для принятия решений на основе данных! 238 символов
9 инструментов
xix.ai

2026 год: лучшие, топовые и высокооценённые инструменты ИИ для написания мелодий для черновиков песен! XIX.AI подобрал высокоэффективную коллекцию, меняющую правила игры, которая прошла строгие реальные испытания, чтобы обеспечить лучший опыт написания. Вы можете найти подробные сравнения бесплатных и платных версий, точные рейтинги и обязательные к использованию варианты, разработанные, чтобы помочь вам создавать потрясающие черновики песен без усилий и значительно повысить вашу творческую продуктивность. Исследуйте сейчас, чтобы найти свой идеальный инструмент!
8 инструментов
xix.ai

2026 г. — новейшие, лучшие и наиболее высоко оцененные инструменты для тренировки разговорных навыков с помощью ИИ для подготовки к собеседованиям уже доступны на XIX.AI! Эта тщательно отобранная подборка включает мощные, революционные инструменты, прошедшие строгие реальные испытания и обеспечивающие точную обратную связь. Вы найдете сравнение бесплатных и платных вариантов, а также подробные рейтинги, которые помогут вам выбрать наиболее подходящий инструмент, повышающий вашу уверенность и навыки. Исследуйте сейчас, чтобы найти идеальный инструмент для успешного прохождения собеседований!
12 инструментов
xix.ai












