


 Дом
Каковы последние достижения в области LLM и задачи для AGI Reasoning в 2025 году?
Стремление к созданию искусственного общего интеллекта набирает обороты. В этой статье рассматриваются передовые исследования, посвященные расширению возможностей больших языковых моделей, и инновационные методы таких институтов, как Стэнфорд, Гарвард, Массачусетский технологический институт, NVIDIA и Университет Карнеги-Меллон. Мы раскроем основные идеи, рассмотрим существующие ограничения, а также рассмотрим будущую траекторию исследований в области AGI, что в конечном итоге позволит понять путь к настоящему общему интеллекту.
Ключевые моменты
Последние исследования сосредоточены на улучшении навыков рассуждения больших языковых моделей.
Появляющиеся методы включают в себя обучение LLM определению абстрактных понятий и использование сложной информации при агрегировании моделей.
Основное внимание уделяется раннему закладыванию основ мышления путем стратегического использования данных, полученных до и после обучения.
Несмотря на достигнутый прогресс, остаются значительные препятствия, особенно при решении открытых задач.
Продвижение за пределы простого голосования большинством голосов в многоагентных системах считается необходимым для получения более сильных и надежных результатов.
Строгие эксперименты и высококачественные наборы данных являются основополагающими для улучшения качества рассуждений моделей AGI.
Предварительное обучение под наблюдением в низкоразмерном пространстве моделей имеет решающее значение для разработки универсальных моделей.
Поощрение разнообразия и устранение статистических погрешностей способствует созданию более устойчивых систем ИИ.
Ландшафт исследований в области рассуждений LLM
Последние исследования в области искусственного общего интеллекта и рассуждений
Область AGI развивается быстрыми темпами, и в нее вносят значительный вклад ведущие академические и исследовательские организации. Современные исследования направлены на преодоление разрыва между специализированным ИИ и широким, человекоподобным интеллектом. Одной из центральных задач является обучение магистрантов передовым навыкам рассуждения для решения сложных задач и формирования обоснованных суждений.
Проблема рассуждений: Хотя LLM хорошо справляются с генерацией и переводом текстов, рассуждения представляют собой более сложную задачу. Как правило, для этого требуется:
- Абстрагирование: Сведение проблемы к ее основным принципам и концепциям.
- Умозаключение: Вывод логических заключений из заданного набора информации.
- Планирование: Формулирование пошагового подхода к достижению поставленной цели.
Многие современные модели сталкиваются с трудностями при решении этих задач, особенно когда требуется обрабатывать данные в одном формате и выдавать их в другом, непредсказуемом формате. Эта сложность является существенным препятствием для разработки надежных AGI.
Ключевые исследовательские институты и их вклад
Известные институты возглавляют исследования в области рассуждений LLM:
- Стэнфордский университет: Новаторские методы обучения LLM для выявления абстракций, которые помогают в решении проблем.
- Гарвардский университет: Продвижение методов агрегирования LLM, которые включают в себя взаимосвязи данных более высокого порядка.
- МАССАЧУСЕТСКИЙ ТЕХНОЛОГИЧЕСКИЙ ИНСТИТУТ: Разработка подходов, выходящих за рамки базового голосования по большинству голосов в совместных системах ИИ.
- NVIDIA: Изучение того, как оптимально сочетать данные до и после обучения для формирования навыков рассуждения с самого начала.
- Университет Карнеги-Меллона: Фокусируется на методологиях обучения, специально предназначенных для решения проблем, основанных на рассуждениях.
Эти совместные и разнообразные усилия подчеркивают многогранность задачи достижения AGI.
Разбор ключевых документов
Обучение LLM для обнаружения абстракций
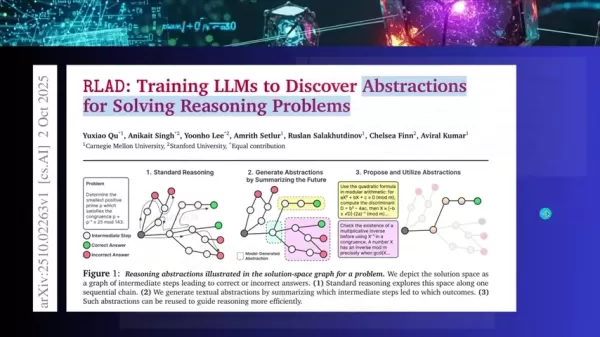
Одно из значительных исследований посвящено обучению магистрантов постижению абстрактных принципов. Цель состоит в том, чтобы повысить их навыки решения проблем и логического мышления. Исследователи разработали методику, при которой модель генерирует абстракции для решения проблем. Абстрактно представляя проблему, LLM может лучше понять ее и разработать эффективные решения. В этой совместной работе Карнеги-Меллона и Стэнфорда особое внимание уделяется методам обучения, которые раскрывают фундаментальную структуру проблемы, делая пути решения более ясными.
Детали обучения:
- Методология фокусируется на понимании основных элементов проблемы.
- Она представляет собой переход от одношаговых рассуждений к многоуровневым, иерархическим стратегиям.
- Ключевым нововведением стало разделение планирования стратегии и ее реализации.
Преимущества
- Создает разделение труда, позволяющее оптимизировать различные компоненты.
- Способствует эффективному обучению, поскольку каждая часть тренируется на соответствующих данных.
- Упрощает сложность, облегчая обработку информации моделью.
За пределами голосования большинством: Агрегация LLM за счет использования информации более высокого порядка
В этом исследовании критикуется распространенная практика полагаться только на большинство голосов в многоагентных системах. Консенсус может быть ограниченным. В статье предлагается использовать информацию более высокого порядка для более точного предсказания наилучшего возможного результата.
Аналогично тому, как мнение ученого-ракетчика по аэрокосмической тематике ценится выше общего консенсуса, этот подход взвешивает вклад отдельных агентов ИИ на основе их опыта и корреляции с другими. Это исследование - совместная работа Массачусетского технологического института, Гарварда и Чикагского университета.
Голосование, выходящее за рамки большинства:
- Оно использует информацию первого порядка, например, известную точность каждой модели.
- Он также включает в себя информацию второго порядка, которая касается того, как ответы моделей соотносятся друг с другом.
- Метод оценивает такие вопросы, как "Учитывая, что модели B и C ответили на X, насколько значимо, что модель A ответила на Y?", чтобы в полной мере использовать коллективный разум.
Front-Loading Reasoning: Синергия между данными до и после обучения
Совместная работа NVIDIA, Carnegie Mellon, Бостонского университета и Стэнфорда посвящена исследованию рассуждений на основе предварительной загрузки и взаимодействию между данными, полученными до и после обучения. Цель состоит в том, чтобы определить оптимальное время для введения различных типов данных, чтобы максимизировать эффективность и производительность модели.
- Введение данных для рассуждений во время предварительного обучения приводит к более длительным улучшениям.
- Самой по себе контролируемой тонкой настройки недостаточно; ключевым фактором для достижения значительных результатов является баланс между качеством и разнообразием данных.
- Правильная реализация позволяет модели показывать хорошие результаты даже на небольших тестовых наборах, что свидетельствует о более высокой общей производительности.
Как применить результаты исследования
Практические шаги по внедрению
Несмотря на то что полная реализация может потребовать значительных ресурсов, разработчики могут взять на вооружение несколько основных принципов:
- Отдавайте предпочтение высококачественным данным для предварительного обучения: Инвестируйте в разнообразные, тщательно контролируемые наборы данных для начального этапа обучения.
- Изучите иерархические архитектуры рассуждений: Применяйте модели, которые отличают стратегическое планирование от тактического исполнения.
- Внедряйте сложные метрики оценки: Выходите за рамки базовой точности и включайте метрики, отражающие межмодельные связи для более точной оценки эффективности.
Применение этих принципов может привести к разработке более надежных и способных моделей, способствуя постепенному прогрессу на пути к AGI.
Изучение генератора абстракций для больших языковых моделей
Pros
Повышение производительности достигается за счет разделения формулирования стратегии и ее исполнения.
Разделение труда обеспечивает специализацию и более эффективные процессы обучения.
Потенциал для достижения превосходных результатов.
Сокращение количества необходимых тестовых данных при улучшении результатов.
Минусы
Многие эксперименты в настоящее время ограничены задачами математического мышления.
Требуется дальнейшее тестирование в сценариях с человекоподобным взаимодействием.
Модели обычно обучались с нуля, что требует значительных ресурсов.
Ограниченное руководство для модели при решении очень сложных задач.
ЧАСТО ЗАДАВАЕМЫЕ ВОПРОСЫ
Что такое AGI?
AGI, или искусственный интеллект общего назначения, - это теоретическая форма ИИ, обладающая способностью понимать, обучаться и применять знания в широком спектре задач на уровне человека. В отличие от узкоспециализированного ИИ, предназначенного для выполнения конкретных функций, AGI будет демонстрировать адаптируемые навыки решения проблем и рассуждения.
Как создать высококачественный набор данных для моделей
Создание высококачественных наборов данных - ресурсоемкий процесс, который часто требует ручного анализа и проверки. Один из подходов заключается в использовании мультиагентной системы для оценки и балансировки качества данных по различным параметрам. Набор данных, который одновременно является высококачественным и разнообразным, приводит к созданию более стабильной и обобщенной модели, способной обрабатывать более широкий спектр входных данных.
Что означает "рассуждения с фронтальной загрузкой"?
Под "фронтальной загрузкой рассуждений" понимается стратегия встраивания возможностей рассуждений на этапе фундаментального предварительного обучения LLM. Такой ранний акцент помогает модели с самого начала заложить прочную основу для абстрактного мышления и решения сложных задач.
Похожие вопросы
Каковы ограничения голосования по большинству голосов в многоагентных системах LLM?
Хотя мажоритарное голосование обеспечивает простой базовый уровень, у него есть недостатки. Оно не учитывает различную точность отдельных моделей, а если модели имеют схожую архитектуру, то они могут сохранять одни и те же системные ошибки, подавляя инновации. Использование информации более высокого порядка дает возможность принимать более тонкие и точные решения.
Каков наилучший способ введения аргументированных данных в процесс настройки данных?
Наиболее эффективным подходом является интеграция данных, ориентированных на рассуждения, на начальном этапе предварительного обучения. Этот основополагающий шаг позволяет добиться наиболее стойких улучшений при разработке моделей с развитыми способностями к рассуждениям.
Связанная статья
 Генеральный директор DeepMind Хассабис: я сплю шесть часов в день, обычно чувствую прилив энергии около часа ночи.
В недавнем интервью журналу Fortune генеральный директор Google DeepMind Демис Хаассабис раскрыл свой нестандартный подход к отдыху и продуктивности. Хаассабис признался, что спит очень мало, распределяя свои бодрствующие часы на два отдельных рабочи
OpenAI и Anthropic борются за долю рынка, несмотря на снижение выручки
Несмотря на недавние сообщения о том, что OpenAI не достигла целевых показателей по выручке, что во вторник оказало давление на акции технологических компаний, частные инвесторы, вкладывающие средства
Соблюдение требований к автономным транспортным средствам в Калифорнии: новая эра штрафов, геозоны и 1 млн миль
Компания Guident эксплуатирует шаттл AuveTech в Южной Флориде, обслуживая маршрут протяженностью четыре мили в Вест-Палм-Бич и маршрут протяженностью одну милю в Бока-Ратоне с использованием своей тех
Рекомендации по связанным специальным темам
Музыкальная композиция
 Инструменты разделения стемов с использованием ИИ для создания ремиксов, подготовки образцов звука и формирования финальных версий караоке.
2026 год: лучшие и наиболее высоко оценённые инструменты для разделения аудиосигналов с использованием ИИ, отобранные специально для работы над ремиксами, подготовки образцов звука и создания караоке-версий. Эти мощные революционные инструменты проходят реальные тесты, обеспечивая точную изоляцию аудиосигналов и значительно повышая производительность. XIX.AI предоставляет еженедельно обновляемый бесплатный справочник сравнения платных и бесплатных решений, который поможет вам найти оптимальный вариант, соответствующий вашим потребностям. Ознакомьтесь с ним прямо сейчас, чтобы раскрыть потенциал ИИ в вашей работе.
 8 инструментов
 xix.ai
Анализ данных
ИИ-копилоты для SQL, предназначенные для создания панелей управления доходами, анализа воронки продаж и отслеживания показателей продуктов.
2026 год: лучшие AI-ассистенты для SQL, занявшие верхние строчки рейтингов! XIX.AI собрал мощный набор инструментов, регулярно обновляемый на основе реальных тестов. Эти неотъемлемые инструменты помогают создавать точные дашборды с данными о доходах, анализировать каналы продаж и оперативно отслеживать показатели продуктов, значительно повышая производительность. Ознакомьтесь сейчас, чтобы найти идеальный инструмент для принятия решений на основе данных! 238 символов
9 инструментов
xix.ai
Музыкальная композиция
Лучшие инструменты для написания мелодий с помощью ИИ для черновиков песен
2026 год: лучшие, топовые и высокооценённые инструменты ИИ для написания мелодий для черновиков песен! XIX.AI подобрал высокоэффективную коллекцию, меняющую правила игры, которая прошла строгие реальные испытания, чтобы обеспечить лучший опыт написания. Вы можете найти подробные сравнения бесплатных и платных версий, точные рейтинги и обязательные к использованию варианты, разработанные, чтобы помочь вам создавать потрясающие черновики песен без усилий и значительно повысить вашу творческую продуктивность. Исследуйте сейчас, чтобы найти свой идеальный инструмент!
8 инструментов
xix.ai
чат-бот
Лучшие инструменты для тренировки разговоров с помощью ИИ для подготовки к собеседованиям
2026 г. — новейшие, лучшие и наиболее высоко оцененные инструменты для тренировки разговорных навыков с помощью ИИ для подготовки к собеседованиям уже доступны на XIX.AI! Эта тщательно отобранная подборка включает мощные, революционные инструменты, прошедшие строгие реальные испытания и обеспечивающие точную обратную связь. Вы найдете сравнение бесплатных и платных вариантов, а также подробные рейтинги, которые помогут вам выбрать наиболее подходящий инструмент, повышающий вашу уверенность и навыки. Исследуйте сейчас, чтобы найти идеальный инструмент для успешного прохождения собеседований!
12 инструментов
xix.ai
Дизайн и искусство
Лучшие инструменты для переноса стилей с помощью ИИ для творческих экспериментов
2026: лучшие и самые популярные инструменты для переноса стиля с помощью ИИ для творческих экспериментов! XIX.AI подготовила подборку мощных, революционных инструментов, которые обязательно стоит попробовать: они демонстрируют исключительные результаты, подтвержденные реальными тестами и тщательным рейтингом. Эти ведущие решения помогают творческим людям значительно повысить продуктивность, ускоряя создание контента и открывая безграничные творческие возможности. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент и начать творить уже сегодня!
9 инструментов
xix.ai
Создание комиксов
Лучшие инструменты для создания диалоговых пузырей с помощью ИИ для визуального повествования
2026 года: самые новые и лучшие инструменты с ИИ для создания диалоговых пузырей в визуальном сторителлинге представлены на XIX.AI! В этой тщательно подобранной подборке представлены мощные, революционные инструменты, которые помогут творческим людям повысить продуктивность и преодолеть творческие кризисы. Ознакомьтесь со сравнением бесплатных и платных версий, посмотрите тесты в реальных условиях и изучите последние рейтинги, чтобы найти решения, которые обязательно стоит попробовать и которые идеально подходят для создания увлекательных визуальных историй. Исследуйте коллекцию прямо сейчас, чтобы найти свой идеальный инструмент!
10 инструментов
xix.ai

 Комментарии (3)
![HarryMartinez]()
Honestly, these reasoning benchmarks feel like measuring how well a parrot can mimic logic. Still cool though. 🦜
![WillieRamirez]()
Die Forschung zu Reasoning-Fähigkeiten bei LLMs ist echt spannend! Besonders interessant finde ich die Frage, ob solche Modelle irgendwann wirklich logische Schlüsse ziehen können oder ob sie nur Muster reproduzieren. Die ethischen Implikationen, wenn solche Systeme in kritischen Bereichen eingesetzt werden, machen mir aber auch etwas Sorgen. 🤔
![WillGarcía]()
2025年のAGI推論?ちょっと未来すぎるかな🤔 でもスタンフォードの研究はやっぱり面白いね。今のLLMってまだ「覚えたこと」しか答えられない気がする。本当の意味で考えられるようになるまで、まだまだ壁がありそう。個人的には、推論能力が上がると、AIとの会話がもっと自然になるのかなって期待してるよ。
Стремление к созданию искусственного общего интеллекта набирает обороты. В этой статье рассматриваются передовые исследования, посвященные расширению возможностей больших языковых моделей, и инновационные методы таких институтов, как Стэнфорд, Гарвард, Массачусетский технологический институт, NVIDIA и Университет Карнеги-Меллон. Мы раскроем основные идеи, рассмотрим существующие ограничения, а также рассмотрим будущую траекторию исследований в области AGI, что в конечном итоге позволит понять путь к настоящему общему интеллекту.
Ключевые моменты
Последние исследования сосредоточены на улучшении навыков рассуждения больших языковых моделей.
Появляющиеся методы включают в себя обучение LLM определению абстрактных понятий и использование сложной информации при агрегировании моделей.
Основное внимание уделяется раннему закладыванию основ мышления путем стратегического использования данных, полученных до и после обучения.
Несмотря на достигнутый прогресс, остаются значительные препятствия, особенно при решении открытых задач.
Продвижение за пределы простого голосования большинством голосов в многоагентных системах считается необходимым для получения более сильных и надежных результатов.
Строгие эксперименты и высококачественные наборы данных являются основополагающими для улучшения качества рассуждений моделей AGI.
Предварительное обучение под наблюдением в низкоразмерном пространстве моделей имеет решающее значение для разработки универсальных моделей.
Поощрение разнообразия и устранение статистических погрешностей способствует созданию более устойчивых систем ИИ.
Ландшафт исследований в области рассуждений LLM
Последние исследования в области искусственного общего интеллекта и рассуждений
Область AGI развивается быстрыми темпами, и в нее вносят значительный вклад ведущие академические и исследовательские организации. Современные исследования направлены на преодоление разрыва между специализированным ИИ и широким, человекоподобным интеллектом. Одной из центральных задач является обучение магистрантов передовым навыкам рассуждения для решения сложных задач и формирования обоснованных суждений.
Проблема рассуждений: Хотя LLM хорошо справляются с генерацией и переводом текстов, рассуждения представляют собой более сложную задачу. Как правило, для этого требуется:
- Абстрагирование: Сведение проблемы к ее основным принципам и концепциям.
- Умозаключение: Вывод логических заключений из заданного набора информации.
- Планирование: Формулирование пошагового подхода к достижению поставленной цели.
Многие современные модели сталкиваются с трудностями при решении этих задач, особенно когда требуется обрабатывать данные в одном формате и выдавать их в другом, непредсказуемом формате. Эта сложность является существенным препятствием для разработки надежных AGI.
Ключевые исследовательские институты и их вклад
Известные институты возглавляют исследования в области рассуждений LLM:
- Стэнфордский университет: Новаторские методы обучения LLM для выявления абстракций, которые помогают в решении проблем.
- Гарвардский университет: Продвижение методов агрегирования LLM, которые включают в себя взаимосвязи данных более высокого порядка.
- МАССАЧУСЕТСКИЙ ТЕХНОЛОГИЧЕСКИЙ ИНСТИТУТ: Разработка подходов, выходящих за рамки базового голосования по большинству голосов в совместных системах ИИ.
- NVIDIA: Изучение того, как оптимально сочетать данные до и после обучения для формирования навыков рассуждения с самого начала.
- Университет Карнеги-Меллона: Фокусируется на методологиях обучения, специально предназначенных для решения проблем, основанных на рассуждениях.
Эти совместные и разнообразные усилия подчеркивают многогранность задачи достижения AGI.
Разбор ключевых документов
Обучение LLM для обнаружения абстракций
Одно из значительных исследований посвящено обучению магистрантов постижению абстрактных принципов. Цель состоит в том, чтобы повысить их навыки решения проблем и логического мышления. Исследователи разработали методику, при которой модель генерирует абстракции для решения проблем. Абстрактно представляя проблему, LLM может лучше понять ее и разработать эффективные решения. В этой совместной работе Карнеги-Меллона и Стэнфорда особое внимание уделяется методам обучения, которые раскрывают фундаментальную структуру проблемы, делая пути решения более ясными.
Детали обучения:
- Методология фокусируется на понимании основных элементов проблемы.
- Она представляет собой переход от одношаговых рассуждений к многоуровневым, иерархическим стратегиям.
- Ключевым нововведением стало разделение планирования стратегии и ее реализации.
Преимущества
- Создает разделение труда, позволяющее оптимизировать различные компоненты.
- Способствует эффективному обучению, поскольку каждая часть тренируется на соответствующих данных.
- Упрощает сложность, облегчая обработку информации моделью.
За пределами голосования большинством: Агрегация LLM за счет использования информации более высокого порядка
В этом исследовании критикуется распространенная практика полагаться только на большинство голосов в многоагентных системах. Консенсус может быть ограниченным. В статье предлагается использовать информацию более высокого порядка для более точного предсказания наилучшего возможного результата.
Аналогично тому, как мнение ученого-ракетчика по аэрокосмической тематике ценится выше общего консенсуса, этот подход взвешивает вклад отдельных агентов ИИ на основе их опыта и корреляции с другими. Это исследование - совместная работа Массачусетского технологического института, Гарварда и Чикагского университета.
Голосование, выходящее за рамки большинства:
- Оно использует информацию первого порядка, например, известную точность каждой модели.
- Он также включает в себя информацию второго порядка, которая касается того, как ответы моделей соотносятся друг с другом.
- Метод оценивает такие вопросы, как "Учитывая, что модели B и C ответили на X, насколько значимо, что модель A ответила на Y?", чтобы в полной мере использовать коллективный разум.
Front-Loading Reasoning: Синергия между данными до и после обучения
Совместная работа NVIDIA, Carnegie Mellon, Бостонского университета и Стэнфорда посвящена исследованию рассуждений на основе предварительной загрузки и взаимодействию между данными, полученными до и после обучения. Цель состоит в том, чтобы определить оптимальное время для введения различных типов данных, чтобы максимизировать эффективность и производительность модели.
- Введение данных для рассуждений во время предварительного обучения приводит к более длительным улучшениям.
- Самой по себе контролируемой тонкой настройки недостаточно; ключевым фактором для достижения значительных результатов является баланс между качеством и разнообразием данных.
- Правильная реализация позволяет модели показывать хорошие результаты даже на небольших тестовых наборах, что свидетельствует о более высокой общей производительности.
Как применить результаты исследования
Практические шаги по внедрению
Несмотря на то что полная реализация может потребовать значительных ресурсов, разработчики могут взять на вооружение несколько основных принципов:
- Отдавайте предпочтение высококачественным данным для предварительного обучения: Инвестируйте в разнообразные, тщательно контролируемые наборы данных для начального этапа обучения.
- Изучите иерархические архитектуры рассуждений: Применяйте модели, которые отличают стратегическое планирование от тактического исполнения.
- Внедряйте сложные метрики оценки: Выходите за рамки базовой точности и включайте метрики, отражающие межмодельные связи для более точной оценки эффективности.
Применение этих принципов может привести к разработке более надежных и способных моделей, способствуя постепенному прогрессу на пути к AGI.
Изучение генератора абстракций для больших языковых моделей
Pros
Повышение производительности достигается за счет разделения формулирования стратегии и ее исполнения.
Разделение труда обеспечивает специализацию и более эффективные процессы обучения.
Потенциал для достижения превосходных результатов.
Сокращение количества необходимых тестовых данных при улучшении результатов.
Минусы
Многие эксперименты в настоящее время ограничены задачами математического мышления.
Требуется дальнейшее тестирование в сценариях с человекоподобным взаимодействием.
Модели обычно обучались с нуля, что требует значительных ресурсов.
Ограниченное руководство для модели при решении очень сложных задач.
ЧАСТО ЗАДАВАЕМЫЕ ВОПРОСЫ
Что такое AGI?
AGI, или искусственный интеллект общего назначения, - это теоретическая форма ИИ, обладающая способностью понимать, обучаться и применять знания в широком спектре задач на уровне человека. В отличие от узкоспециализированного ИИ, предназначенного для выполнения конкретных функций, AGI будет демонстрировать адаптируемые навыки решения проблем и рассуждения.
Как создать высококачественный набор данных для моделей
Создание высококачественных наборов данных - ресурсоемкий процесс, который часто требует ручного анализа и проверки. Один из подходов заключается в использовании мультиагентной системы для оценки и балансировки качества данных по различным параметрам. Набор данных, который одновременно является высококачественным и разнообразным, приводит к созданию более стабильной и обобщенной модели, способной обрабатывать более широкий спектр входных данных.
Что означает "рассуждения с фронтальной загрузкой"?
Под "фронтальной загрузкой рассуждений" понимается стратегия встраивания возможностей рассуждений на этапе фундаментального предварительного обучения LLM. Такой ранний акцент помогает модели с самого начала заложить прочную основу для абстрактного мышления и решения сложных задач.
Похожие вопросы
Каковы ограничения голосования по большинству голосов в многоагентных системах LLM?
Хотя мажоритарное голосование обеспечивает простой базовый уровень, у него есть недостатки. Оно не учитывает различную точность отдельных моделей, а если модели имеют схожую архитектуру, то они могут сохранять одни и те же системные ошибки, подавляя инновации. Использование информации более высокого порядка дает возможность принимать более тонкие и точные решения.
Каков наилучший способ введения аргументированных данных в процесс настройки данных?
Наиболее эффективным подходом является интеграция данных, ориентированных на рассуждения, на начальном этапе предварительного обучения. Этот основополагающий шаг позволяет добиться наиболее стойких улучшений при разработке моделей с развитыми способностями к рассуждениям.








 Генеральный директор DeepMind Хассабис: я сплю шесть часов в день, обычно чувствую прилив энергии около часа ночи.
В недавнем интервью журналу Fortune генеральный директор Google DeepMind Демис Хаассабис раскрыл свой нестандартный подход к отдыху и продуктивности. Хаассабис признался, что спит очень мало, распределяя свои бодрствующие часы на два отдельных рабочи
 OpenAI и Anthropic борются за долю рынка, несмотря на снижение выручки
Несмотря на недавние сообщения о том, что OpenAI не достигла целевых показателей по выручке, что во вторник оказало давление на акции технологических компаний, частные инвесторы, вкладывающие средства
Соблюдение требований к автономным транспортным средствам в Калифорнии: новая эра штрафов, геозоны и 1 млн миль
Компания Guident эксплуатирует шаттл AuveTech в Южной Флориде, обслуживая маршрут протяженностью четыре мили в Вест-Палм-Бич и маршрут протяженностью одну милю в Бока-Ратоне с использованием своей тех

2026 год: лучшие и наиболее высоко оценённые инструменты для разделения аудиосигналов с использованием ИИ, отобранные специально для работы над ремиксами, подготовки образцов звука и создания караоке-версий. Эти мощные революционные инструменты проходят реальные тесты, обеспечивая точную изоляцию аудиосигналов и значительно повышая производительность. XIX.AI предоставляет еженедельно обновляемый бесплатный справочник сравнения платных и бесплатных решений, который поможет вам найти оптимальный вариант, соответствующий вашим потребностям. Ознакомьтесь с ним прямо сейчас, чтобы раскрыть потенциал ИИ в вашей работе.
8 инструментов
xix.ai

2026 год: лучшие AI-ассистенты для SQL, занявшие верхние строчки рейтингов! XIX.AI собрал мощный набор инструментов, регулярно обновляемый на основе реальных тестов. Эти неотъемлемые инструменты помогают создавать точные дашборды с данными о доходах, анализировать каналы продаж и оперативно отслеживать показатели продуктов, значительно повышая производительность. Ознакомьтесь сейчас, чтобы найти идеальный инструмент для принятия решений на основе данных! 238 символов
9 инструментов
xix.ai

2026 год: лучшие, топовые и высокооценённые инструменты ИИ для написания мелодий для черновиков песен! XIX.AI подобрал высокоэффективную коллекцию, меняющую правила игры, которая прошла строгие реальные испытания, чтобы обеспечить лучший опыт написания. Вы можете найти подробные сравнения бесплатных и платных версий, точные рейтинги и обязательные к использованию варианты, разработанные, чтобы помочь вам создавать потрясающие черновики песен без усилий и значительно повысить вашу творческую продуктивность. Исследуйте сейчас, чтобы найти свой идеальный инструмент!
8 инструментов
xix.ai

2026 г. — новейшие, лучшие и наиболее высоко оцененные инструменты для тренировки разговорных навыков с помощью ИИ для подготовки к собеседованиям уже доступны на XIX.AI! Эта тщательно отобранная подборка включает мощные, революционные инструменты, прошедшие строгие реальные испытания и обеспечивающие точную обратную связь. Вы найдете сравнение бесплатных и платных вариантов, а также подробные рейтинги, которые помогут вам выбрать наиболее подходящий инструмент, повышающий вашу уверенность и навыки. Исследуйте сейчас, чтобы найти идеальный инструмент для успешного прохождения собеседований!
12 инструментов
xix.ai

2026: лучшие и самые популярные инструменты для переноса стиля с помощью ИИ для творческих экспериментов! XIX.AI подготовила подборку мощных, революционных инструментов, которые обязательно стоит попробовать: они демонстрируют исключительные результаты, подтвержденные реальными тестами и тщательным рейтингом. Эти ведущие решения помогают творческим людям значительно повысить продуктивность, ускоряя создание контента и открывая безграничные творческие возможности. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент и начать творить уже сегодня!
9 инструментов
xix.ai

2026 года: самые новые и лучшие инструменты с ИИ для создания диалоговых пузырей в визуальном сторителлинге представлены на XIX.AI! В этой тщательно подобранной подборке представлены мощные, революционные инструменты, которые помогут творческим людям повысить продуктивность и преодолеть творческие кризисы. Ознакомьтесь со сравнением бесплатных и платных версий, посмотрите тесты в реальных условиях и изучите последние рейтинги, чтобы найти решения, которые обязательно стоит попробовать и которые идеально подходят для создания увлекательных визуальных историй. Исследуйте коллекцию прямо сейчас, чтобы найти свой идеальный инструмент!
10 инструментов
xix.ai

Honestly, these reasoning benchmarks feel like measuring how well a parrot can mimic logic. Still cool though. 🦜
Die Forschung zu Reasoning-Fähigkeiten bei LLMs ist echt spannend! Besonders interessant finde ich die Frage, ob solche Modelle irgendwann wirklich logische Schlüsse ziehen können oder ob sie nur Muster reproduzieren. Die ethischen Implikationen, wenn solche Systeme in kritischen Bereichen eingesetzt werden, machen mir aber auch etwas Sorgen. 🤔
2025年のAGI推論?ちょっと未来すぎるかな🤔 でもスタンフォードの研究はやっぱり面白いね。今のLLMってまだ「覚えたこと」しか答えられない気がする。本当の意味で考えられるようになるまで、まだまだ壁がありそう。個人的には、推論能力が上がると、AIとの会話がもっと自然になるのかなって期待してるよ。












