


 Maison
Quelles sont les avancées récentes du LLM et quels sont les défis pour le raisonnement AGI en 2025 ?
La recherche sur l'intelligence générale artificielle prend de l'ampleur. Cet article explore la recherche de pointe consacrée à l'amélioration des capacités de raisonnement des grands modèles de langage, en mettant en évidence les méthodes innovantes d'institutions telles que Stanford, Harvard, le MIT, NVIDIA et l'université Carnegie Mellon. Nous décrypterons les idées fondamentales, aborderons les limites actuelles et envisagerons la trajectoire future de la recherche sur l'AGI, pour finalement démystifier la voie vers une véritable intelligence générale.
Points clés
Des études récentes se sont concentrées sur l'amélioration des capacités de raisonnement des grands modèles de langage.
Les techniques émergentes impliquent l'entraînement des LLM à l'identification de concepts abstraits et à l'utilisation d'informations sophistiquées lors de l'agrégation des modèles.
L'accent est mis sur l'établissement de bases de raisonnement précoces en exploitant stratégiquement les données de préformation et de post-formation.
Malgré les progrès réalisés, des obstacles importants subsistent, notamment en ce qui concerne la résolution de problèmes ouverts.
Il est essentiel d'aller au-delà du vote à la majorité simple dans les systèmes multi-agents pour obtenir des résultats plus solides et plus fiables.
Une expérimentation rigoureuse et des ensembles de données de haute qualité sont essentiels pour améliorer la qualité du raisonnement des modèles AGI.
Le pré-entraînement supervisé dans un espace de modèle à faible dimension est crucial pour développer des modèles polyvalents.
La promotion de la diversité et l'élimination des biais statistiques contribuent à rendre le système d'IA plus résistant.
Le paysage de la recherche sur le raisonnement en LLM
Dernières recherches en intelligence générale artificielle et en raisonnement
Le domaine de l'AGI progresse rapidement, avec des contributions majeures d'organisations universitaires et de recherche de premier plan. La recherche contemporaine s'efforce de combler le fossé entre l'IA spécialisée et l'intelligence générale de type humain. L'un des principaux objectifs est de doter les MLA de capacités de raisonnement avancées pour relever des défis complexes et former des jugements solides.
Le défi du raisonnement : Si les LLM sont performants dans la génération et la traduction de textes, le raisonnement représente un plus grand défi. Il nécessite généralement
- L'abstraction : La distillation d'un problème jusqu'à ses principes et concepts essentiels.
- L'inférence : Tirer des conclusions logiques d'un ensemble d'informations donné.
- La planification : Formuler une approche étape par étape pour atteindre un objectif souhaité.
De nombreux modèles actuels trouvent ces tâches difficiles, en particulier lorsqu'il s'agit de traiter des données dans un format et de les restituer dans un autre format imprévu. Cette complexité constitue un obstacle important au développement d'une AGI robuste.
Principales institutions de recherche et leurs contributions
Des institutions de premier plan mènent la charge en matière de recherche sur le raisonnement LLM :
- L'université de Stanford : Méthodes pionnières de formation des LLM pour découvrir les abstractions qui aident à résoudre les problèmes.
- Université de Harvard : Amélioration des techniques d'agrégation LLM qui intègrent des relations de données d'ordre supérieur.
- MIT : Développement d'approches qui vont au-delà du simple vote à la majorité dans les systèmes d'IA collaboratifs.
- NVIDIA : Étude de la manière de combiner de manière optimale les données de préformation et de post-formation pour développer les capacités de raisonnement dès le départ.
- Université Carnegie Mellon : Elle se concentre sur les méthodologies de formation spécifiquement axées sur la résolution de problèmes fondés sur le raisonnement.
Ces efforts collaboratifs et diversifiés soulignent les multiples facettes du défi que représente la réalisation de l'AGI.
Décortiquer les articles clés
Former les LLM à la découverte d'abstractions
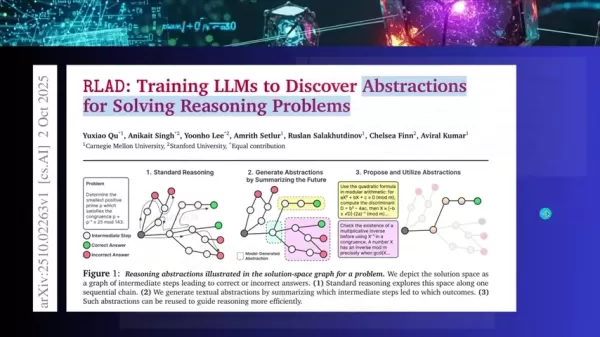
Une étude importante se concentre sur l'apprentissage des LLM à saisir des principes abstraits. L'objectif est de renforcer leurs compétences en matière de résolution de problèmes et de raisonnement logique. Les chercheurs ont mis au point une technique dans laquelle le modèle génère des abstractions pour résoudre les problèmes. En conceptualisant un problème de manière abstraite, le LLM peut mieux le comprendre et concevoir des solutions efficaces. Cette collaboration entre Carnegie Mellon et Stanford met l'accent sur les méthodes de formation qui révèlent la structure fondamentale d'un problème, rendant ainsi les voies de solution plus claires.
Détails de la formation :
- La méthodologie se concentre sur la compréhension des éléments fondamentaux d'un problème.
- Elle représente le passage d'un raisonnement en une seule étape à des stratégies hiérarchiques en couches.
- Une innovation clé a été de séparer la planification d'une stratégie de son exécution.
Avantages
- Établit une division du travail, permettant une optimisation spécialisée des différents composants.
- Favorise un apprentissage efficace, chaque partie s'entraînant sur des données pertinentes.
- Simplifie la complexité, ce qui permet au modèle de traiter plus facilement les informations.
Au-delà du vote à la majorité : Agrégation LLM par l'exploitation d'informations d'ordre supérieur
Cette recherche critique la pratique courante qui consiste à s'appuyer uniquement sur le vote majoritaire dans les systèmes multi-agents. Le consensus peut être limitatif. L'article propose d'utiliser des informations d'ordre supérieur pour prédire avec plus de précision le meilleur résultat possible.
À l'instar de l'opinion d'un spécialiste des fusées sur les questions aérospatiales, qui est plus importante que le consensus général, cette approche pondère les contributions des agents d'intelligence artificielle en fonction de leur expertise et de leurs corrélations avec d'autres agents. Cette recherche est le fruit d'une collaboration entre le MIT, Harvard et l'université de Chicago.
Le vote au-delà de la majorité :
- Il utilise des informations de premier ordre, telles que la précision connue de chaque modèle.
- Elle intègre également des informations de second ordre, qui concernent la manière dont les réponses des modèles sont liées les unes aux autres.
- La méthode évalue des questions telles que "Étant donné que les modèles B et C ont répondu à X, quelle est l'importance de la réponse du modèle A à Y ?" pour tirer pleinement parti de l'intelligence collective.
Raisonnement en amont : La synergie entre les données de préformation et de post-formation
Un effort conjoint de NVIDIA, Carnegie Mellon, Boston University et Stanford explore le raisonnement par chargement frontal et l'interaction entre les données de pré-entraînement et de post-entraînement. L'objectif est de déterminer le moment optimal pour introduire différents types de données afin de maximiser l'efficacité et les performances du modèle.
- L'introduction de données de raisonnement au cours de la préformation conduit à des améliorations plus durables.
- La mise au point supervisée est insuffisante en soi ; un équilibre entre la qualité et la diversité des données est essentiel pour obtenir des gains significatifs.
- Une mise en œuvre appropriée permet au modèle d'être performant même sur des ensembles de tests plus petits, ce qui indique une performance globale plus élevée.
Comment appliquer ces résultats de recherche
Étapes pratiques de la mise en œuvre
Bien qu'une mise en œuvre complète puisse nécessiter des ressources substantielles, les développeurs peuvent adopter plusieurs principes de base :
- Donner la priorité à des données de préformation de haute qualité : Investir dans des ensembles de données diversifiés et méticuleusement sélectionnés pour la phase de formation initiale.
- Explorer les architectures de raisonnement hiérarchique : Adopter des modèles qui distinguent la planification stratégique de l'exécution tactique.
- Mettre en œuvre des mesures d'évaluation sophistiquées : Aller au-delà de la précision de base pour inclure des mesures qui capturent les relations entre les modèles pour une évaluation plus juste des performances.
L'application de ces principes peut conduire au développement de modèles plus robustes et plus performants, contribuant ainsi au progrès progressif vers l'AGI.
Exploration du générateur d'abstraction pour les grands modèles de langage
Pour
L'amélioration des performances résulte de la séparation entre la formulation de la stratégie et son exécution.
La division du travail permet une spécialisation et des processus d'apprentissage plus efficaces.
Possibilité d'obtenir des résultats supérieurs.
Réduit la quantité de données de test nécessaires tout en améliorant les résultats.
Inconvénients
De nombreuses expériences sont actuellement limitées à des tâches de raisonnement mathématique.
Des tests supplémentaires sont nécessaires dans des scénarios impliquant une interaction de type humain.
Les modèles ont généralement été formés à partir de zéro, ce qui demande beaucoup de ressources.
Le modèle ne dispose que de peu de conseils lorsqu'il s'agit d'aborder des questions très complexes.
FAQ
Qu'est-ce que l'AGI ?
L'AGI, ou intelligence artificielle générale, désigne une forme théorique d'IA qui possède la capacité de comprendre, d'apprendre et d'appliquer des connaissances à un large éventail de tâches à un niveau humain. Contrairement à l'IA étroite conçue pour des fonctions spécifiques, l'AGI ferait preuve de compétences adaptables en matière de résolution de problèmes et de raisonnement.
Comment puis-je créer des ensembles de données de haute qualité pour les modèles ?
La constitution d'ensembles de données de haute qualité est un processus à forte intensité de ressources qui exige souvent un examen et une analyse manuels. Une approche consiste à employer un système multi-agents pour évaluer et équilibrer la qualité des données à travers différentes dimensions. Un ensemble de données à la fois de haute qualité et diversifié permet d'obtenir un modèle plus stable et plus généralisé, capable de traiter un plus grand nombre d'entrées.
Que signifie "raisonnement frontal" ?
L'expression "Front-loading reasoning" décrit une stratégie consistant à intégrer des capacités de raisonnement au cours de l'étape fondamentale de pré-entraînement d'un LLM. Cet accent précoce aide le modèle à construire une base solide pour la pensée abstraite et la résolution de problèmes complexes dès le départ.
Questions connexes
Quelles sont les limites du vote majoritaire dans les systèmes LLM multi-agents ?
Bien que le vote majoritaire fournisse une base de référence simple, il présente des lacunes. Il ne tient pas compte de la précision variable des modèles individuels, et si les modèles partagent des architectures similaires, ils peuvent perpétuer les mêmes erreurs systémiques, ce qui étouffe l'innovation. L'utilisation d'informations d'ordre supérieur permet de prendre des décisions plus nuancées et plus précises.
Quelle est la meilleure façon d'injecter des données de raisonnement dans l'optimisation des données ?
L'approche la plus efficace consiste à intégrer des données axées sur le raisonnement au cours de la phase initiale de pré-entraînement. Cette étape fondamentale permet d'obtenir les améliorations les plus durables pour le développement de modèles dotés de capacités de raisonnement avancées.
Article connexe
 iFLYTEK dévoile le grand modèle général Spark X2.5
Le 1er septembre, iFlytek ouvrira en open source deux grands modèles de langage axés sur l’edge, Xinghuo X2.5-4B et Xinghuo X2.5-1.7B, selon la dernière annonce officielle. Ces deux modèles prennent nativement en charge une fenêtre de contexte allant
Meta supprime la fonction de retouche photo par IA suite aux critiques des utilisateurs
Meta, le géant des réseaux sociaux, est une fois de plus au cœur d’un débat public concernant l’équilibre délicat entre l’intelligence artificielle et la vie privée des utilisateurs. Selon TechCrunch, les Superintelligence Labs de Meta ont présenté u
PDG de DeepMind, Hassabis : Je dors six heures par jour et je me sens généralement plein d’énergie vers 1 h du matin.
Fortune a récemment publié une interview avec Demis Hassabis, PDG de Google DeepMind, révélant son approche non conventionnelle du repos et de la productivité. Hassabis a divulgué qu’il dort très peu, structurant ses heures d’éveil en deux blocs de t
Recommandations de sujets spéciaux liés
Création d'animations
 Outils d'animation de scènes basés sur l'IA pour les contenus destinés aux réseaux sociaux
XIX.AI vous présente ici les meilleurs outils d'animation de scènes par IA les mieux notés de 2026 pour les contenus destinés aux réseaux sociaux. Ces outils puissants et révolutionnaires font l'objet de tests en conditions réelles et d'une comparaison détaillée entre les versions gratuites et payantes, aidant ainsi les créateurs à booster considérablement leur productivité. Découvrez-les dès maintenant pour tirer pleinement parti de l'IA.
 9 outils
 xix.ai
Création vidéo
Générateurs d'accroches pour vidéos courtes basés sur l'IA, destinés aux Reels, aux Shorts et aux campagnes de lancement de produits
Les meilleurs générateurs de accroches pour vidéos courtes basées sur l'IA en 2026 : pour Reels, Shorts et campagnes de lancement de produits ! XIX.AI sélectionne les outils les mieux notés, puissants et révolutionnaires, qui offrent des résultats incontournables grâce à des tests en conditions réelles. Cette page, mise à jour chaque semaine, propose des classements comparatifs entre les solutions gratuites et payantes pour vous aider à trouver la solution idéale afin de booster votre créativité et votre productivité en matière de contenu. Découvrez-la dès maintenant pour exploiter pleinement le potentiel de l’IA !
11 outils
xix.ai
en écrivant
Outils d'IA pour la structuration d'articles destinés à la rédaction de textes longs
2026 : les meilleurs outils d'aide à la rédaction de plans pour les textes longs, sélectionnés parmi les mieux notés ! Cette sélection rigoureuse regroupe des outils puissants et révolutionnaires qui fournissent des plans précis et structurés, validés par des tests concrets, afin d'améliorer considérablement l'efficacité de la rédaction. XIX.AI fait partie de cette sélection d'élite. Consultez notre comparatif entre les versions gratuites et payantes pour vous aider à choisir l'outil idéal. Découvrez-les dès maintenant et tirez parti de l'IA !
9 outils
xix.ai
chatbot
Meilleures applications de chat de jeu de rôle par IA pour la pratique des langues, la préparation aux entretiens et la fluidité quotidienne
2026 Dernières Meilleures Applications de Chat IA pour le Jeu de Rôle, les plus bien notées pour la Pratique des Langues, la Préparation aux Entretiens et la Fluidité Quotidienne ! XIX.AI sélectionne une collection puissante et révolutionnaire qui propose une comparaison gratuit vs payant, des tests en conditions réelles et des classements mis à jour chaque semaine. Ces outils à essayer absolument vous aident à améliorer vos compétences en écriture, à surmonter les défis de fluidité et à optimiser l’efficacité de la communication dans tous les scénarios quotidiens. Explorez dès maintenant pour découvrir l’outil parfait pour votre progression linguistique !
10 outils
xix.ai
Composition musicale
Outils de séparation des pistes audio par IA pour la production de remix, la préparation de samples et les masters de karaoké
2026 : Les meilleures et plus récentes outils de séparation des pistes audio par IA, hautement notés, sélectionnés spécialement pour la production de remix, la préparation de samples et l’enregistrement de karaokés. Ces outils puissants et révolutionnaires, éprouvés dans des conditions réelles, permettent une isolation audio précise, ce qui améliore considérablement la productivité. XIX.AI propose un guide de comparaison gratuit mis à jour chaque semaine entre les versions payantes et gratuites, afin de vous aider à trouver la solution idéale adaptée à vos besoins. Découvrez-les dès maintenant pour tirer parti des avantages offerts par l’IA.
8 outils
xix.ai
Analyse des données
Copilotes SQL basés sur l’IA pour les tableaux de bord de chiffre d’affaires, l’analyse des funnels et les indicateurs de produits
2026 : Les meilleurs copilotes AI SQL actuels, classés parmi les plus performants ! XIX.AI a sélectionné une collection puissante et révolutionnaire, mise à jour chaque semaine grâce à des tests concrets. Ces outils indispensables vous aident à créer des tableaux de bord financiers précis, à analyser les canaux de vente et à suivre en temps réel les indicateurs produits, ce qui améliore considérablement votre productivité. Découvrez-les dès maintenant pour trouver l’outil idéal pour des décisions basées sur les données ! 238 caractères
9 outils
xix.ai

 commentaires (3)
![HarryMartinez]()
Honestly, these reasoning benchmarks feel like measuring how well a parrot can mimic logic. Still cool though. 🦜
![WillieRamirez]()
Die Forschung zu Reasoning-Fähigkeiten bei LLMs ist echt spannend! Besonders interessant finde ich die Frage, ob solche Modelle irgendwann wirklich logische Schlüsse ziehen können oder ob sie nur Muster reproduzieren. Die ethischen Implikationen, wenn solche Systeme in kritischen Bereichen eingesetzt werden, machen mir aber auch etwas Sorgen. 🤔
![WillGarcía]()
2025年のAGI推論?ちょっと未来すぎるかな🤔 でもスタンフォードの研究はやっぱり面白いね。今のLLMってまだ「覚えたこと」しか答えられない気がする。本当の意味で考えられるようになるまで、まだまだ壁がありそう。個人的には、推論能力が上がると、AIとの会話がもっと自然になるのかなって期待してるよ。
La recherche sur l'intelligence générale artificielle prend de l'ampleur. Cet article explore la recherche de pointe consacrée à l'amélioration des capacités de raisonnement des grands modèles de langage, en mettant en évidence les méthodes innovantes d'institutions telles que Stanford, Harvard, le MIT, NVIDIA et l'université Carnegie Mellon. Nous décrypterons les idées fondamentales, aborderons les limites actuelles et envisagerons la trajectoire future de la recherche sur l'AGI, pour finalement démystifier la voie vers une véritable intelligence générale.
Points clés
Des études récentes se sont concentrées sur l'amélioration des capacités de raisonnement des grands modèles de langage.
Les techniques émergentes impliquent l'entraînement des LLM à l'identification de concepts abstraits et à l'utilisation d'informations sophistiquées lors de l'agrégation des modèles.
L'accent est mis sur l'établissement de bases de raisonnement précoces en exploitant stratégiquement les données de préformation et de post-formation.
Malgré les progrès réalisés, des obstacles importants subsistent, notamment en ce qui concerne la résolution de problèmes ouverts.
Il est essentiel d'aller au-delà du vote à la majorité simple dans les systèmes multi-agents pour obtenir des résultats plus solides et plus fiables.
Une expérimentation rigoureuse et des ensembles de données de haute qualité sont essentiels pour améliorer la qualité du raisonnement des modèles AGI.
Le pré-entraînement supervisé dans un espace de modèle à faible dimension est crucial pour développer des modèles polyvalents.
La promotion de la diversité et l'élimination des biais statistiques contribuent à rendre le système d'IA plus résistant.
Le paysage de la recherche sur le raisonnement en LLM
Dernières recherches en intelligence générale artificielle et en raisonnement
Le domaine de l'AGI progresse rapidement, avec des contributions majeures d'organisations universitaires et de recherche de premier plan. La recherche contemporaine s'efforce de combler le fossé entre l'IA spécialisée et l'intelligence générale de type humain. L'un des principaux objectifs est de doter les MLA de capacités de raisonnement avancées pour relever des défis complexes et former des jugements solides.
Le défi du raisonnement : Si les LLM sont performants dans la génération et la traduction de textes, le raisonnement représente un plus grand défi. Il nécessite généralement
- L'abstraction : La distillation d'un problème jusqu'à ses principes et concepts essentiels.
- L'inférence : Tirer des conclusions logiques d'un ensemble d'informations donné.
- La planification : Formuler une approche étape par étape pour atteindre un objectif souhaité.
De nombreux modèles actuels trouvent ces tâches difficiles, en particulier lorsqu'il s'agit de traiter des données dans un format et de les restituer dans un autre format imprévu. Cette complexité constitue un obstacle important au développement d'une AGI robuste.
Principales institutions de recherche et leurs contributions
Des institutions de premier plan mènent la charge en matière de recherche sur le raisonnement LLM :
- L'université de Stanford : Méthodes pionnières de formation des LLM pour découvrir les abstractions qui aident à résoudre les problèmes.
- Université de Harvard : Amélioration des techniques d'agrégation LLM qui intègrent des relations de données d'ordre supérieur.
- MIT : Développement d'approches qui vont au-delà du simple vote à la majorité dans les systèmes d'IA collaboratifs.
- NVIDIA : Étude de la manière de combiner de manière optimale les données de préformation et de post-formation pour développer les capacités de raisonnement dès le départ.
- Université Carnegie Mellon : Elle se concentre sur les méthodologies de formation spécifiquement axées sur la résolution de problèmes fondés sur le raisonnement.
Ces efforts collaboratifs et diversifiés soulignent les multiples facettes du défi que représente la réalisation de l'AGI.
Décortiquer les articles clés
Former les LLM à la découverte d'abstractions
Une étude importante se concentre sur l'apprentissage des LLM à saisir des principes abstraits. L'objectif est de renforcer leurs compétences en matière de résolution de problèmes et de raisonnement logique. Les chercheurs ont mis au point une technique dans laquelle le modèle génère des abstractions pour résoudre les problèmes. En conceptualisant un problème de manière abstraite, le LLM peut mieux le comprendre et concevoir des solutions efficaces. Cette collaboration entre Carnegie Mellon et Stanford met l'accent sur les méthodes de formation qui révèlent la structure fondamentale d'un problème, rendant ainsi les voies de solution plus claires.
Détails de la formation :
- La méthodologie se concentre sur la compréhension des éléments fondamentaux d'un problème.
- Elle représente le passage d'un raisonnement en une seule étape à des stratégies hiérarchiques en couches.
- Une innovation clé a été de séparer la planification d'une stratégie de son exécution.
Avantages
- Établit une division du travail, permettant une optimisation spécialisée des différents composants.
- Favorise un apprentissage efficace, chaque partie s'entraînant sur des données pertinentes.
- Simplifie la complexité, ce qui permet au modèle de traiter plus facilement les informations.
Au-delà du vote à la majorité : Agrégation LLM par l'exploitation d'informations d'ordre supérieur
Cette recherche critique la pratique courante qui consiste à s'appuyer uniquement sur le vote majoritaire dans les systèmes multi-agents. Le consensus peut être limitatif. L'article propose d'utiliser des informations d'ordre supérieur pour prédire avec plus de précision le meilleur résultat possible.
À l'instar de l'opinion d'un spécialiste des fusées sur les questions aérospatiales, qui est plus importante que le consensus général, cette approche pondère les contributions des agents d'intelligence artificielle en fonction de leur expertise et de leurs corrélations avec d'autres agents. Cette recherche est le fruit d'une collaboration entre le MIT, Harvard et l'université de Chicago.
Le vote au-delà de la majorité :
- Il utilise des informations de premier ordre, telles que la précision connue de chaque modèle.
- Elle intègre également des informations de second ordre, qui concernent la manière dont les réponses des modèles sont liées les unes aux autres.
- La méthode évalue des questions telles que "Étant donné que les modèles B et C ont répondu à X, quelle est l'importance de la réponse du modèle A à Y ?" pour tirer pleinement parti de l'intelligence collective.
Raisonnement en amont : La synergie entre les données de préformation et de post-formation
Un effort conjoint de NVIDIA, Carnegie Mellon, Boston University et Stanford explore le raisonnement par chargement frontal et l'interaction entre les données de pré-entraînement et de post-entraînement. L'objectif est de déterminer le moment optimal pour introduire différents types de données afin de maximiser l'efficacité et les performances du modèle.
- L'introduction de données de raisonnement au cours de la préformation conduit à des améliorations plus durables.
- La mise au point supervisée est insuffisante en soi ; un équilibre entre la qualité et la diversité des données est essentiel pour obtenir des gains significatifs.
- Une mise en œuvre appropriée permet au modèle d'être performant même sur des ensembles de tests plus petits, ce qui indique une performance globale plus élevée.
Comment appliquer ces résultats de recherche
Étapes pratiques de la mise en œuvre
Bien qu'une mise en œuvre complète puisse nécessiter des ressources substantielles, les développeurs peuvent adopter plusieurs principes de base :
- Donner la priorité à des données de préformation de haute qualité : Investir dans des ensembles de données diversifiés et méticuleusement sélectionnés pour la phase de formation initiale.
- Explorer les architectures de raisonnement hiérarchique : Adopter des modèles qui distinguent la planification stratégique de l'exécution tactique.
- Mettre en œuvre des mesures d'évaluation sophistiquées : Aller au-delà de la précision de base pour inclure des mesures qui capturent les relations entre les modèles pour une évaluation plus juste des performances.
L'application de ces principes peut conduire au développement de modèles plus robustes et plus performants, contribuant ainsi au progrès progressif vers l'AGI.
Exploration du générateur d'abstraction pour les grands modèles de langage
Pour
L'amélioration des performances résulte de la séparation entre la formulation de la stratégie et son exécution.
La division du travail permet une spécialisation et des processus d'apprentissage plus efficaces.
Possibilité d'obtenir des résultats supérieurs.
Réduit la quantité de données de test nécessaires tout en améliorant les résultats.
Inconvénients
De nombreuses expériences sont actuellement limitées à des tâches de raisonnement mathématique.
Des tests supplémentaires sont nécessaires dans des scénarios impliquant une interaction de type humain.
Les modèles ont généralement été formés à partir de zéro, ce qui demande beaucoup de ressources.
Le modèle ne dispose que de peu de conseils lorsqu'il s'agit d'aborder des questions très complexes.
FAQ
Qu'est-ce que l'AGI ?
L'AGI, ou intelligence artificielle générale, désigne une forme théorique d'IA qui possède la capacité de comprendre, d'apprendre et d'appliquer des connaissances à un large éventail de tâches à un niveau humain. Contrairement à l'IA étroite conçue pour des fonctions spécifiques, l'AGI ferait preuve de compétences adaptables en matière de résolution de problèmes et de raisonnement.
Comment puis-je créer des ensembles de données de haute qualité pour les modèles ?
La constitution d'ensembles de données de haute qualité est un processus à forte intensité de ressources qui exige souvent un examen et une analyse manuels. Une approche consiste à employer un système multi-agents pour évaluer et équilibrer la qualité des données à travers différentes dimensions. Un ensemble de données à la fois de haute qualité et diversifié permet d'obtenir un modèle plus stable et plus généralisé, capable de traiter un plus grand nombre d'entrées.
Que signifie "raisonnement frontal" ?
L'expression "Front-loading reasoning" décrit une stratégie consistant à intégrer des capacités de raisonnement au cours de l'étape fondamentale de pré-entraînement d'un LLM. Cet accent précoce aide le modèle à construire une base solide pour la pensée abstraite et la résolution de problèmes complexes dès le départ.
Questions connexes
Quelles sont les limites du vote majoritaire dans les systèmes LLM multi-agents ?
Bien que le vote majoritaire fournisse une base de référence simple, il présente des lacunes. Il ne tient pas compte de la précision variable des modèles individuels, et si les modèles partagent des architectures similaires, ils peuvent perpétuer les mêmes erreurs systémiques, ce qui étouffe l'innovation. L'utilisation d'informations d'ordre supérieur permet de prendre des décisions plus nuancées et plus précises.
Quelle est la meilleure façon d'injecter des données de raisonnement dans l'optimisation des données ?
L'approche la plus efficace consiste à intégrer des données axées sur le raisonnement au cours de la phase initiale de pré-entraînement. Cette étape fondamentale permet d'obtenir les améliorations les plus durables pour le développement de modèles dotés de capacités de raisonnement avancées.








 iFLYTEK dévoile le grand modèle général Spark X2.5
Le 1er septembre, iFlytek ouvrira en open source deux grands modèles de langage axés sur l’edge, Xinghuo X2.5-4B et Xinghuo X2.5-1.7B, selon la dernière annonce officielle. Ces deux modèles prennent nativement en charge une fenêtre de contexte allant
 Meta supprime la fonction de retouche photo par IA suite aux critiques des utilisateurs
Meta, le géant des réseaux sociaux, est une fois de plus au cœur d’un débat public concernant l’équilibre délicat entre l’intelligence artificielle et la vie privée des utilisateurs. Selon TechCrunch, les Superintelligence Labs de Meta ont présenté u
 PDG de DeepMind, Hassabis : Je dors six heures par jour et je me sens généralement plein d’énergie vers 1 h du matin.
Fortune a récemment publié une interview avec Demis Hassabis, PDG de Google DeepMind, révélant son approche non conventionnelle du repos et de la productivité. Hassabis a divulgué qu’il dort très peu, structurant ses heures d’éveil en deux blocs de t

XIX.AI vous présente ici les meilleurs outils d'animation de scènes par IA les mieux notés de 2026 pour les contenus destinés aux réseaux sociaux. Ces outils puissants et révolutionnaires font l'objet de tests en conditions réelles et d'une comparaison détaillée entre les versions gratuites et payantes, aidant ainsi les créateurs à booster considérablement leur productivité. Découvrez-les dès maintenant pour tirer pleinement parti de l'IA.
9 outils
xix.ai

Les meilleurs générateurs de accroches pour vidéos courtes basées sur l'IA en 2026 : pour Reels, Shorts et campagnes de lancement de produits ! XIX.AI sélectionne les outils les mieux notés, puissants et révolutionnaires, qui offrent des résultats incontournables grâce à des tests en conditions réelles. Cette page, mise à jour chaque semaine, propose des classements comparatifs entre les solutions gratuites et payantes pour vous aider à trouver la solution idéale afin de booster votre créativité et votre productivité en matière de contenu. Découvrez-la dès maintenant pour exploiter pleinement le potentiel de l’IA !
11 outils
xix.ai

2026 : les meilleurs outils d'aide à la rédaction de plans pour les textes longs, sélectionnés parmi les mieux notés ! Cette sélection rigoureuse regroupe des outils puissants et révolutionnaires qui fournissent des plans précis et structurés, validés par des tests concrets, afin d'améliorer considérablement l'efficacité de la rédaction. XIX.AI fait partie de cette sélection d'élite. Consultez notre comparatif entre les versions gratuites et payantes pour vous aider à choisir l'outil idéal. Découvrez-les dès maintenant et tirez parti de l'IA !
9 outils
xix.ai

2026 Dernières Meilleures Applications de Chat IA pour le Jeu de Rôle, les plus bien notées pour la Pratique des Langues, la Préparation aux Entretiens et la Fluidité Quotidienne ! XIX.AI sélectionne une collection puissante et révolutionnaire qui propose une comparaison gratuit vs payant, des tests en conditions réelles et des classements mis à jour chaque semaine. Ces outils à essayer absolument vous aident à améliorer vos compétences en écriture, à surmonter les défis de fluidité et à optimiser l’efficacité de la communication dans tous les scénarios quotidiens. Explorez dès maintenant pour découvrir l’outil parfait pour votre progression linguistique !
10 outils
xix.ai

2026 : Les meilleures et plus récentes outils de séparation des pistes audio par IA, hautement notés, sélectionnés spécialement pour la production de remix, la préparation de samples et l’enregistrement de karaokés. Ces outils puissants et révolutionnaires, éprouvés dans des conditions réelles, permettent une isolation audio précise, ce qui améliore considérablement la productivité. XIX.AI propose un guide de comparaison gratuit mis à jour chaque semaine entre les versions payantes et gratuites, afin de vous aider à trouver la solution idéale adaptée à vos besoins. Découvrez-les dès maintenant pour tirer parti des avantages offerts par l’IA.
8 outils
xix.ai

2026 : Les meilleurs copilotes AI SQL actuels, classés parmi les plus performants ! XIX.AI a sélectionné une collection puissante et révolutionnaire, mise à jour chaque semaine grâce à des tests concrets. Ces outils indispensables vous aident à créer des tableaux de bord financiers précis, à analyser les canaux de vente et à suivre en temps réel les indicateurs produits, ce qui améliore considérablement votre productivité. Découvrez-les dès maintenant pour trouver l’outil idéal pour des décisions basées sur les données ! 238 caractères
9 outils
xix.ai

Honestly, these reasoning benchmarks feel like measuring how well a parrot can mimic logic. Still cool though. 🦜
Die Forschung zu Reasoning-Fähigkeiten bei LLMs ist echt spannend! Besonders interessant finde ich die Frage, ob solche Modelle irgendwann wirklich logische Schlüsse ziehen können oder ob sie nur Muster reproduzieren. Die ethischen Implikationen, wenn solche Systeme in kritischen Bereichen eingesetzt werden, machen mir aber auch etwas Sorgen. 🤔
2025年のAGI推論?ちょっと未来すぎるかな🤔 でもスタンフォードの研究はやっぱり面白いね。今のLLMってまだ「覚えたこと」しか答えられない気がする。本当の意味で考えられるようになるまで、まだまだ壁がありそう。個人的には、推論能力が上がると、AIとの会話がもっと自然になるのかなって期待してるよ。












