


 家
最近のLLMの進歩と2025年のAGI推論の課題とは?
人工知能の追求が加速している。本稿では、スタンフォード大学、ハーバード大学、マサチューセッツ工科大学(MIT)、エヌビディア(NVIDIA)、カーネギーメロン大学(Carnegie Mellon University)などの研究機関による革新的な手法を取り上げ、大規模言語モデルの推論能力を強化するための最先端の研究を紹介する。核となるアイデアを紐解き、現在の限界に対処し、AGI研究の将来の軌跡を考察し、最終的に真の一般知能への道を解明する。
キーポイント
最近の研究は、大規模言語モデルの推論能力を向上させることに集中している。
新しい技術には、抽象的な概念を識別するためにLLMを訓練し、モデル集約時に高度な情報を利用することが含まれる。
主な焦点は、事前学習と事後学習の両方のデータを戦略的に活用することで、早期に推論基盤を確立することである。
進展は見られるものの、特にオープンエンドな問題解決には大きなハードルが残されている。
マルチエージェントシステムにおける単純な多数決を超える進歩は、より強力で信頼性の高い結果を得るために不可欠であると考えられている。
厳密な実験と高品質のデータセットは、AGIモデルの推論品質を向上させるための基本である。
低次元のモデル空間における教師ありの事前学習は、汎用性の高いモデルを開発する上で極めて重要である。
多様性を育成し、統計的バイアスを排除することは、よりレジリエントなAIシステムに貢献する。
LLM推論研究の展望
人工知能と推論の最新研究
AGI分野は急速に進歩しており、主要な学術機関や研究機関から多くの情報が寄せられている。現代の研究は、専門的なAIと人間のような広範な知能との間の溝を埋めようとしています。その中心的な目的は、複雑な課題に取り組み、適切な判断を下すための高度な推論能力をLLMに身につけさせることである。
推論への挑戦LLMはテキスト生成や翻訳では優れた能力を発揮するが、推論には大きな課題がある。通常、次のようなことが要求される:
- 抽象化:問題を本質的な原理や概念にまで絞り込むこと。
- 推論:与えられた情報から論理的な結論を導き出す。
- 計画:望ましい目的に到達するための段階的なアプローチを策定すること。
現在の多くのモデルでは、これらのタスクは困難である。特に、あるフォーマットでデータを処理し、別の予期せぬフォーマットで出力する必要がある場合はなおさらである。この複雑さが、強固なAGI開発の大きな障壁となっている。
主要研究機関とその貢献
著名な研究機関がLLM推論研究をリードしている:
- スタンフォード大学:スタンフォード大学:LLMを訓練し、問題解決を助ける抽象的な概念を発見する方法を開拓している。
- ハーバード大学高次のデータ関係を組み込んだLLMの集計技術を推進。
- マサチューセッツ工科大学協調AIシステムにおいて、基本的な多数決を超えるアプローチを開発。
- エヌビディア推論スキルを最初から構築するために、事前学習データと事後学習データを最適に組み合わせる方法を研究。
- カーネギーメロン大学推論に基づく問題の解決に特化したトレーニング方法論に焦点を当てている。
これらの協力的で多様な取り組みは、AGIを実現するための多面的な挑戦を強調している。
主要論文の分解
抽象度を発見するLLMのトレーニング
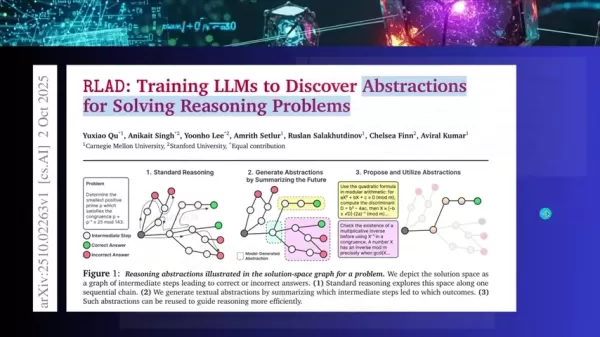
ある重要な研究は、LLMに抽象的な原理を理解させることに集中している。その目的は、問題解決能力と論理的推論能力を高めることである。研究者たちは、モデルが問題に対処するために抽象的な概念を生成する手法を考案した。問題を抽象的に概念化することで、LLMはその問題をよりよく理解し、効果的な解決策を考案することができる。カーネギーメロン大学とスタンフォード大学のこの共同研究は、問題の基本構造を明らかにし、解決への道筋をより明確にするトレーニング方法を重視している。
トレーニングの詳細
- この方法論は、問題の核となる要素を理解することに重点を置いている。
- これは、シングルステップの推論から、階層化された戦略へのシフトを表している。
- 重要な革新は、戦略のプランニングとその実行を分離したことである。
利点
- 分業を確立し、異なるコンポーネントの専門的な最適化を可能にする。
- 各コンポーネントが関連データに基づいて学習することで、効率的な学習を促進。
- 複雑さが単純化され、モデルが情報を処理しやすくなる。
多数決を超える:高次情報を活用したLLM集約
この研究は、マルチエージェントシステムにおいて多数決のみに頼る一般的なやり方を批判している。コンセンサスには限界がある。この論文では、可能な限り最良の結果をより正確に予測するために、高次の情報を利用することを提案している。
一般的なコンセンサスよりも、航空宇宙トピックに関するロケット科学者の意見を重視するのと同様に、このアプローチでは、個々のAIエージェントの専門知識と他者との相関関係に基づいて、その貢献に重み付けを行う。この研究は、MIT、ハーバード大学、シカゴ大学の共同研究である。
多数決を超えた投票
- 各モデルの既知の精度などの一次情報を利用する。
- また、モデルの答えが互いにどのように関連しているかに関係する二次情報も取り入れる。
- この手法では、「モデルBとCがXと答えたとすると、モデルAがYと答えたことにどの程度の意味があるのか」といった質問を評価し、集合知を十分に活用する。
フロントローディング推論:学習前データと学習後データの相乗効果
NVIDIA、カーネギーメロン大学、ボストン大学、スタンフォード大学による共同研究では、フロントローディング推論と、事前学習データと事後学習データの相互作用を探求している。その目的は、モデルの効率と性能を最大化するために、異なるデータタイプを導入する最適なタイミングを決定することです。
- 事前トレーニング中に推論データを導入することで、より持続的な改善につながる。
- 教師ありのファインチューニングだけでは不十分であり、データの質と多様性のバランスが大幅な改善の鍵となる。
- 適切な実装により、モデルはより小さなテストセットでも良好なパフォーマンスを示し、全体的なパフォーマンスが向上する。
これらの研究結果の適用方法
実装のための実践的ステップ
完全な実装にはかなりのリソースが必要かもしれないが、開発者はいくつかの基本原則を採用することができる:
- 質の高い事前学習データを優先する:最初のトレーニング段階では、多様で綿密に管理されたデータセットに投資する。
- 階層的推論アーキテクチャを探求する:戦略的計画と戦術的実行を区別するモデル設計を採用する。
- 洗練された評価指標の導入:基本的な精度にとどまらず、モデル間の関係を把握する評価指標を導入することで、真のパフォーマンス評価を行う。
これらの原則を適用することで、より頑健で有能なモデルを開発することができ、AGIに向けた漸進的な進展に貢献することができる。
大規模言語モデルの抽象化ジェネレーターの探求
長所
戦略策定と実行を分離することによるパフォーマンスの向上。
分業により、専門化とより効率的な学習プロセスが可能になる。
優れた結果を達成する可能性。
結果を向上させながら、必要なテストデータの量を減らすことができる。
短所
現在のところ、多くの実験は数学的推論タスクに限定されている。
人間のようなインタラクションを含むシナリオでのさらなるテストが必要。
モデルは通常ゼロからトレーニングされるため、リソースを消費する。
非常に複雑な問題に取り組む際、モデルのガイダンスが限られている。
よくある質問
AGIとは何ですか?
AGI(Artificial General Intelligence)とは、人間レベルで幅広いタスクを理解し、学習し、知識を適用する能力を持つAIの理論的形態を指す。特定の機能のために設計された狭い範囲のAIとは異なり、AGIは適応可能な問題解決能力と推論能力を発揮します。
モデル用の高品質なデータセットはどのように作成できますか?
高品質なデータセットの作成は、多くの場合、手作業によるレビューと分析を必要とする、資源集約的なプロセスである。一つのアプローチは、様々な次元でデータの質を評価し、バランスをとるためにマルチエージェントシステムを採用することである。高品質で多様性のあるデータセットは、より安定した、より一般化されたモデルにつながり、より幅広い入力を扱うことができる。
フロントローディング推論」とはどういう意味か?
フロントローディング推論」とは、LLMの基礎的な事前学習段階で推論機能を組み込む戦略のことです。このように早い段階から推論に重点を置くことで、抽象的思考や複雑な問題解決のための強固な基盤を最初から構築することができます。
関連する質問
マルチエージェントLLMシステムにおける多数決の限界は何ですか?
多数決はシンプルなベースラインを提供しますが、欠点もあります。多数決は、個々のモデルの精度のばらつきを考慮しておらず、モデルが似たようなアーキテクチャを共有している場合、同じシステムエラーを永続させ、イノベーションを阻害する可能性がある。高次の情報を活用することで、より微妙で正確な意思決定が可能になる。
データチューニングに推論データを注入する最善の方法とは?
最も効果的なアプローチは、最初のプレトレーニングフェーズで推論にフォーカスしたデータを統合することです。この基本的なステップは、高度な推論能力を持つモデルを開発するための最も耐久性のある改善をもたらします。
関連記事
 DeepMindのCEOハサビス氏:1日6時間睡眠し、通常午前1時頃に活力を感じます。
フォーチュンは最近、Google DeepMindのCEOであるデミス・ハサビスへのインタビューを掲載し、彼の休息と生産性に対する非伝統的なアプローチを明らかにした。ハサビスは、睡眠時間が非常に短いことを明かし、覚醒時間を2つの明確な作業ブロックに構造化していると語った。彼の睡眠習慣について、ハサビスは「6時間の睡眠を目標としているが、私の習慣は典型的ではない。一日中効果的に機能できる」と述べた。彼は、6時間未満の睡眠は脳の健康に悪影響を及ぼすことを強調した。2010年にDeepMindを共
OpenAIとAnthropic、収益の伸び悩みにもかかわらず市場シェア争いを繰り広げる
OpenAIが収益目標を達成できなかったとする最近の報道を受け、今週火曜日にハイテク株に売り圧力が生じたにもかかわらず、AI研究機関への民間投資家は依然として堅調だ。経験豊富な出資者たちは、メディアによる否定的な報道にもかかわらず、投資額を減らすつもりはないことを明らかにしている。アナリストらは、現在のAI競争はまだ初期段階にあると見ており、「勝者総取り」という結末はあり得ないと見ている。高いコン
カリフォルニア州の自動運転車規制:違反切符、ジオフェンス、そして100万マイルという新たな時代
Guident社は南フロリダでAuveTechのシャトルを運行しており、同社の遠隔監視技術を活用して、ウェストパームビーチでの4マイルのルートとボカラトンでの1マイルのルートを管理している。 | 提供:Guidentカリフォルニア州は、自動運転車の規制環境を再定義しつつあり、テクノロジー業界の「迅速に動き、失敗を恐れない」という考え方から、厳格な説明責任と厳しい走行距離要件へと移行している。Gui
関連特集おすすめ
チャットボット
 言語練習、面接対策、そして日常の流暢さのための最高のAIロールプレイチャットアプリ
2026年最新版・最高評価のAIロールプレイチャットアプリ|語学練習、面接対策、日常会話の流暢さ向上に!XIX.AIは、無料と有料の比較、実世界でのテスト、毎週更新されるランキングを提供する革新的なコレクションを厳選しています。これらの必須ツールは、ライティングスキルの向上、流暢さの課題克服、そしてあらゆる日常シナリオにおけるコミュニケーション効率の改善をサポートします。今すぐ探索して、あなたの言語成長に最適なツールを見つけましょう!
 10 ツール
 xix.ai
作曲
リミックス制作、サンプリングの準備、カラオケマスター作成のためのAIステム分離ツール
2026年最新・最高評価のAIステム分離ツール。リミックス制作、サンプリング準備、カラオケマスター向けに厳選されました。これらの強力で画期的なツールは、実環境でのテストを経て、正確なオーディオ分離を実現し、生産性を大幅に向上させます。 XIX.AIでは、ニーズに合った「必試」のソリューションを見つけるお手伝いをするため、無料版と有料版の比較ガイドを毎週更新して提供しています。今すぐチェックして、AIの力を最大限に活用しましょう。
8 ツール
xix.ai
データ分析
収益ダッシュボード、ファネル分析、および製品指標向けのAI SQLコピロット
2026年最新かつ最も優れたAI SQLコピロットが最高評価でランクイン!XIX.AIは、毎週更新される実際の環境でのテストに対応した、強力で革新的なツール群を厳選しています。これらの必見ツールを使えば、正確な収益ダッシュボードの作成や販売プロセスの分析、製品指標の迅速な追跡が可能となり、生産性を大幅に向上させることができます。今すぐチェックして、データに基づいた意思決定に最適なツールを見つけましょう!238文字
9 ツール
xix.ai
作曲
曲のドラフト作成に最適なAIメロディ作成ツール
2026年最新版 高評価のAIメロディ作成ツールで曲のドラフト作成!XIX.AIは、厳格な実世界テストを経て最高の作成体験を提供する、革新的な強力なコレクションを厳選しました。詳細な無料版と有料版の比較、正確なランキング、そして素晴らしい曲のドラフトを楽に作成し、創造的な生産性を大幅に向上させるためにぜひ試すべきオプションが見つかります。今すぐ探索して、あなたに最適なツールを見つけましょう!
8 ツール
xix.ai
チャットボット
面接練習用のベストなAI会話トレーニングツール
2026年最新版・最高評価のAI会話トレーニングツールが、面接練習に最適です。XIX.AIにてご提供しています!この厳選コレクションには、現実世界での厳格なテストを経て正確なフィードバックを提供する強力なツールが含まれています。無料版と有料版の比較や詳細なランキングをご覧いただき、自信とスキルを高めるための必須オプションをお選びください。今すぐ探索して、面接成功に最適なツールを見つけましょう!
12 ツール
xix.ai
デザインとアート
クリエイティブな実験に最適なAIスタイル転送ツール
2026年版 クリエイティブな実験に最適な、最新・最高評価のAIスタイル転送ツール!XIX.AIは、実地テストと厳格なランキングを通じて卓越した結果をもたらす、強力で画期的な「必試」ツールを厳選しました。これらのトップソリューションは、コンテンツ制作を加速させ、無限の創造的可能性を切り拓くことで、クリエイターの生産性を大幅に向上させます。 今すぐチェックして、あなたにぴったりのツールを見つけ、今日から創作を始めましょう!
9 ツール
xix.ai

 コメント (3)
0/500
![HarryMartinez]()
Honestly, these reasoning benchmarks feel like measuring how well a parrot can mimic logic. Still cool though. 🦜
![WillieRamirez]()
Die Forschung zu Reasoning-Fähigkeiten bei LLMs ist echt spannend! Besonders interessant finde ich die Frage, ob solche Modelle irgendwann wirklich logische Schlüsse ziehen können oder ob sie nur Muster reproduzieren. Die ethischen Implikationen, wenn solche Systeme in kritischen Bereichen eingesetzt werden, machen mir aber auch etwas Sorgen. 🤔
![WillGarcía]()
2025年のAGI推論?ちょっと未来すぎるかな🤔 でもスタンフォードの研究はやっぱり面白いね。今のLLMってまだ「覚えたこと」しか答えられない気がする。本当の意味で考えられるようになるまで、まだまだ壁がありそう。個人的には、推論能力が上がると、AIとの会話がもっと自然になるのかなって期待してるよ。
人工知能の追求が加速している。本稿では、スタンフォード大学、ハーバード大学、マサチューセッツ工科大学(MIT)、エヌビディア(NVIDIA)、カーネギーメロン大学(Carnegie Mellon University)などの研究機関による革新的な手法を取り上げ、大規模言語モデルの推論能力を強化するための最先端の研究を紹介する。核となるアイデアを紐解き、現在の限界に対処し、AGI研究の将来の軌跡を考察し、最終的に真の一般知能への道を解明する。
キーポイント
最近の研究は、大規模言語モデルの推論能力を向上させることに集中している。
新しい技術には、抽象的な概念を識別するためにLLMを訓練し、モデル集約時に高度な情報を利用することが含まれる。
主な焦点は、事前学習と事後学習の両方のデータを戦略的に活用することで、早期に推論基盤を確立することである。
進展は見られるものの、特にオープンエンドな問題解決には大きなハードルが残されている。
マルチエージェントシステムにおける単純な多数決を超える進歩は、より強力で信頼性の高い結果を得るために不可欠であると考えられている。
厳密な実験と高品質のデータセットは、AGIモデルの推論品質を向上させるための基本である。
低次元のモデル空間における教師ありの事前学習は、汎用性の高いモデルを開発する上で極めて重要である。
多様性を育成し、統計的バイアスを排除することは、よりレジリエントなAIシステムに貢献する。
LLM推論研究の展望
人工知能と推論の最新研究
AGI分野は急速に進歩しており、主要な学術機関や研究機関から多くの情報が寄せられている。現代の研究は、専門的なAIと人間のような広範な知能との間の溝を埋めようとしています。その中心的な目的は、複雑な課題に取り組み、適切な判断を下すための高度な推論能力をLLMに身につけさせることである。
推論への挑戦LLMはテキスト生成や翻訳では優れた能力を発揮するが、推論には大きな課題がある。通常、次のようなことが要求される:
- 抽象化:問題を本質的な原理や概念にまで絞り込むこと。
- 推論:与えられた情報から論理的な結論を導き出す。
- 計画:望ましい目的に到達するための段階的なアプローチを策定すること。
現在の多くのモデルでは、これらのタスクは困難である。特に、あるフォーマットでデータを処理し、別の予期せぬフォーマットで出力する必要がある場合はなおさらである。この複雑さが、強固なAGI開発の大きな障壁となっている。
主要研究機関とその貢献
著名な研究機関がLLM推論研究をリードしている:
- スタンフォード大学:スタンフォード大学:LLMを訓練し、問題解決を助ける抽象的な概念を発見する方法を開拓している。
- ハーバード大学高次のデータ関係を組み込んだLLMの集計技術を推進。
- マサチューセッツ工科大学協調AIシステムにおいて、基本的な多数決を超えるアプローチを開発。
- エヌビディア推論スキルを最初から構築するために、事前学習データと事後学習データを最適に組み合わせる方法を研究。
- カーネギーメロン大学推論に基づく問題の解決に特化したトレーニング方法論に焦点を当てている。
これらの協力的で多様な取り組みは、AGIを実現するための多面的な挑戦を強調している。
主要論文の分解
抽象度を発見するLLMのトレーニング
ある重要な研究は、LLMに抽象的な原理を理解させることに集中している。その目的は、問題解決能力と論理的推論能力を高めることである。研究者たちは、モデルが問題に対処するために抽象的な概念を生成する手法を考案した。問題を抽象的に概念化することで、LLMはその問題をよりよく理解し、効果的な解決策を考案することができる。カーネギーメロン大学とスタンフォード大学のこの共同研究は、問題の基本構造を明らかにし、解決への道筋をより明確にするトレーニング方法を重視している。
トレーニングの詳細
- この方法論は、問題の核となる要素を理解することに重点を置いている。
- これは、シングルステップの推論から、階層化された戦略へのシフトを表している。
- 重要な革新は、戦略のプランニングとその実行を分離したことである。
利点
- 分業を確立し、異なるコンポーネントの専門的な最適化を可能にする。
- 各コンポーネントが関連データに基づいて学習することで、効率的な学習を促進。
- 複雑さが単純化され、モデルが情報を処理しやすくなる。
多数決を超える:高次情報を活用したLLM集約
この研究は、マルチエージェントシステムにおいて多数決のみに頼る一般的なやり方を批判している。コンセンサスには限界がある。この論文では、可能な限り最良の結果をより正確に予測するために、高次の情報を利用することを提案している。
一般的なコンセンサスよりも、航空宇宙トピックに関するロケット科学者の意見を重視するのと同様に、このアプローチでは、個々のAIエージェントの専門知識と他者との相関関係に基づいて、その貢献に重み付けを行う。この研究は、MIT、ハーバード大学、シカゴ大学の共同研究である。
多数決を超えた投票
- 各モデルの既知の精度などの一次情報を利用する。
- また、モデルの答えが互いにどのように関連しているかに関係する二次情報も取り入れる。
- この手法では、「モデルBとCがXと答えたとすると、モデルAがYと答えたことにどの程度の意味があるのか」といった質問を評価し、集合知を十分に活用する。
フロントローディング推論:学習前データと学習後データの相乗効果
NVIDIA、カーネギーメロン大学、ボストン大学、スタンフォード大学による共同研究では、フロントローディング推論と、事前学習データと事後学習データの相互作用を探求している。その目的は、モデルの効率と性能を最大化するために、異なるデータタイプを導入する最適なタイミングを決定することです。
- 事前トレーニング中に推論データを導入することで、より持続的な改善につながる。
- 教師ありのファインチューニングだけでは不十分であり、データの質と多様性のバランスが大幅な改善の鍵となる。
- 適切な実装により、モデルはより小さなテストセットでも良好なパフォーマンスを示し、全体的なパフォーマンスが向上する。
これらの研究結果の適用方法
実装のための実践的ステップ
完全な実装にはかなりのリソースが必要かもしれないが、開発者はいくつかの基本原則を採用することができる:
- 質の高い事前学習データを優先する:最初のトレーニング段階では、多様で綿密に管理されたデータセットに投資する。
- 階層的推論アーキテクチャを探求する:戦略的計画と戦術的実行を区別するモデル設計を採用する。
- 洗練された評価指標の導入:基本的な精度にとどまらず、モデル間の関係を把握する評価指標を導入することで、真のパフォーマンス評価を行う。
これらの原則を適用することで、より頑健で有能なモデルを開発することができ、AGIに向けた漸進的な進展に貢献することができる。
大規模言語モデルの抽象化ジェネレーターの探求
長所
戦略策定と実行を分離することによるパフォーマンスの向上。
分業により、専門化とより効率的な学習プロセスが可能になる。
優れた結果を達成する可能性。
結果を向上させながら、必要なテストデータの量を減らすことができる。
短所
現在のところ、多くの実験は数学的推論タスクに限定されている。
人間のようなインタラクションを含むシナリオでのさらなるテストが必要。
モデルは通常ゼロからトレーニングされるため、リソースを消費する。
非常に複雑な問題に取り組む際、モデルのガイダンスが限られている。
よくある質問
AGIとは何ですか?
AGI(Artificial General Intelligence)とは、人間レベルで幅広いタスクを理解し、学習し、知識を適用する能力を持つAIの理論的形態を指す。特定の機能のために設計された狭い範囲のAIとは異なり、AGIは適応可能な問題解決能力と推論能力を発揮します。
モデル用の高品質なデータセットはどのように作成できますか?
高品質なデータセットの作成は、多くの場合、手作業によるレビューと分析を必要とする、資源集約的なプロセスである。一つのアプローチは、様々な次元でデータの質を評価し、バランスをとるためにマルチエージェントシステムを採用することである。高品質で多様性のあるデータセットは、より安定した、より一般化されたモデルにつながり、より幅広い入力を扱うことができる。
フロントローディング推論」とはどういう意味か?
フロントローディング推論」とは、LLMの基礎的な事前学習段階で推論機能を組み込む戦略のことです。このように早い段階から推論に重点を置くことで、抽象的思考や複雑な問題解決のための強固な基盤を最初から構築することができます。
関連する質問
マルチエージェントLLMシステムにおける多数決の限界は何ですか?
多数決はシンプルなベースラインを提供しますが、欠点もあります。多数決は、個々のモデルの精度のばらつきを考慮しておらず、モデルが似たようなアーキテクチャを共有している場合、同じシステムエラーを永続させ、イノベーションを阻害する可能性がある。高次の情報を活用することで、より微妙で正確な意思決定が可能になる。
データチューニングに推論データを注入する最善の方法とは?
最も効果的なアプローチは、最初のプレトレーニングフェーズで推論にフォーカスしたデータを統合することです。この基本的なステップは、高度な推論能力を持つモデルを開発するための最も耐久性のある改善をもたらします。








 DeepMindのCEOハサビス氏:1日6時間睡眠し、通常午前1時頃に活力を感じます。
フォーチュンは最近、Google DeepMindのCEOであるデミス・ハサビスへのインタビューを掲載し、彼の休息と生産性に対する非伝統的なアプローチを明らかにした。ハサビスは、睡眠時間が非常に短いことを明かし、覚醒時間を2つの明確な作業ブロックに構造化していると語った。彼の睡眠習慣について、ハサビスは「6時間の睡眠を目標としているが、私の習慣は典型的ではない。一日中効果的に機能できる」と述べた。彼は、6時間未満の睡眠は脳の健康に悪影響を及ぼすことを強調した。2010年にDeepMindを共
 OpenAIとAnthropic、収益の伸び悩みにもかかわらず市場シェア争いを繰り広げる
OpenAIが収益目標を達成できなかったとする最近の報道を受け、今週火曜日にハイテク株に売り圧力が生じたにもかかわらず、AI研究機関への民間投資家は依然として堅調だ。経験豊富な出資者たちは、メディアによる否定的な報道にもかかわらず、投資額を減らすつもりはないことを明らかにしている。アナリストらは、現在のAI競争はまだ初期段階にあると見ており、「勝者総取り」という結末はあり得ないと見ている。高いコン
カリフォルニア州の自動運転車規制:違反切符、ジオフェンス、そして100万マイルという新たな時代
Guident社は南フロリダでAuveTechのシャトルを運行しており、同社の遠隔監視技術を活用して、ウェストパームビーチでの4マイルのルートとボカラトンでの1マイルのルートを管理している。 | 提供:Guidentカリフォルニア州は、自動運転車の規制環境を再定義しつつあり、テクノロジー業界の「迅速に動き、失敗を恐れない」という考え方から、厳格な説明責任と厳しい走行距離要件へと移行している。Gui

2026年最新版・最高評価のAIロールプレイチャットアプリ|語学練習、面接対策、日常会話の流暢さ向上に!XIX.AIは、無料と有料の比較、実世界でのテスト、毎週更新されるランキングを提供する革新的なコレクションを厳選しています。これらの必須ツールは、ライティングスキルの向上、流暢さの課題克服、そしてあらゆる日常シナリオにおけるコミュニケーション効率の改善をサポートします。今すぐ探索して、あなたの言語成長に最適なツールを見つけましょう!
10 ツール
xix.ai

2026年最新・最高評価のAIステム分離ツール。リミックス制作、サンプリング準備、カラオケマスター向けに厳選されました。これらの強力で画期的なツールは、実環境でのテストを経て、正確なオーディオ分離を実現し、生産性を大幅に向上させます。 XIX.AIでは、ニーズに合った「必試」のソリューションを見つけるお手伝いをするため、無料版と有料版の比較ガイドを毎週更新して提供しています。今すぐチェックして、AIの力を最大限に活用しましょう。
8 ツール
xix.ai

2026年最新かつ最も優れたAI SQLコピロットが最高評価でランクイン!XIX.AIは、毎週更新される実際の環境でのテストに対応した、強力で革新的なツール群を厳選しています。これらの必見ツールを使えば、正確な収益ダッシュボードの作成や販売プロセスの分析、製品指標の迅速な追跡が可能となり、生産性を大幅に向上させることができます。今すぐチェックして、データに基づいた意思決定に最適なツールを見つけましょう!238文字
9 ツール
xix.ai

2026年最新版 高評価のAIメロディ作成ツールで曲のドラフト作成!XIX.AIは、厳格な実世界テストを経て最高の作成体験を提供する、革新的な強力なコレクションを厳選しました。詳細な無料版と有料版の比較、正確なランキング、そして素晴らしい曲のドラフトを楽に作成し、創造的な生産性を大幅に向上させるためにぜひ試すべきオプションが見つかります。今すぐ探索して、あなたに最適なツールを見つけましょう!
8 ツール
xix.ai

2026年最新版・最高評価のAI会話トレーニングツールが、面接練習に最適です。XIX.AIにてご提供しています!この厳選コレクションには、現実世界での厳格なテストを経て正確なフィードバックを提供する強力なツールが含まれています。無料版と有料版の比較や詳細なランキングをご覧いただき、自信とスキルを高めるための必須オプションをお選びください。今すぐ探索して、面接成功に最適なツールを見つけましょう!
12 ツール
xix.ai

2026年版 クリエイティブな実験に最適な、最新・最高評価のAIスタイル転送ツール!XIX.AIは、実地テストと厳格なランキングを通じて卓越した結果をもたらす、強力で画期的な「必試」ツールを厳選しました。これらのトップソリューションは、コンテンツ制作を加速させ、無限の創造的可能性を切り拓くことで、クリエイターの生産性を大幅に向上させます。 今すぐチェックして、あなたにぴったりのツールを見つけ、今日から創作を始めましょう!
9 ツール
xix.ai

Honestly, these reasoning benchmarks feel like measuring how well a parrot can mimic logic. Still cool though. 🦜
Die Forschung zu Reasoning-Fähigkeiten bei LLMs ist echt spannend! Besonders interessant finde ich die Frage, ob solche Modelle irgendwann wirklich logische Schlüsse ziehen können oder ob sie nur Muster reproduzieren. Die ethischen Implikationen, wenn solche Systeme in kritischen Bereichen eingesetzt werden, machen mir aber auch etwas Sorgen. 🤔
2025年のAGI推論?ちょっと未来すぎるかな🤔 でもスタンフォードの研究はやっぱり面白いね。今のLLMってまだ「覚えたこと」しか答えられない気がする。本当の意味で考えられるようになるまで、まだまだ壁がありそう。個人的には、推論能力が上がると、AIとの会話がもっと自然になるのかなって期待してるよ。












