
opção
RyanLopez
RyanLopez
25 de Maio de 2026

Uma equipe conjunta da Universidade Tsinghua e da Tencent venceu o campeonato global no desafio de otimização de inferência de modelos MoE da MLSys2026. Eles desenvolveram uma solução de otimização completa para modelos MoE com trilhões de parâmetros em hardware NPU, utilizando estratégias inovadoras como partição E-Shard e concorrência PSUM/GEMV. Com a ajuda de um otimizador automatizado chamado Knight, seu método reduziu o tempo total de inferência de 14,91 segundos para 3,56 segundos, alcançando uma aceleração de desempenho de 4,1 vezes. Isso representa um paradigma engenhosístico importante para a implementação de modelos MoE de grande escala em futuras plataformas de computação de super-nós.
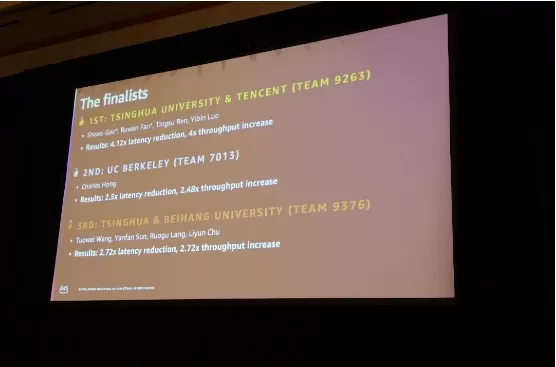
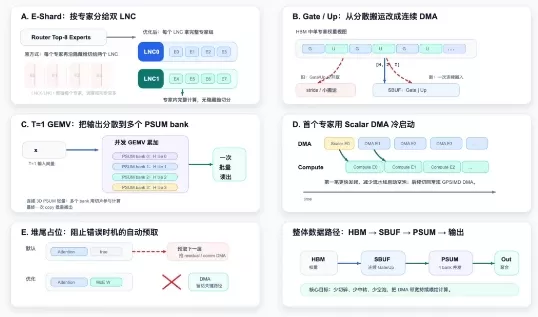
Uma equipe conjunta da Universidade Tsinghua e da Tencent venceu o campeonato global no desafio de otimização de inferência de modelos MoE da MLSys2026. Eles desenvolveram uma solução de otimização completa para modelos MoE com trilhões de parâmetros em hardware NPU, utilizando estratégias inovadoras como partição E-Shard e concorrência PSUM/GEMV. Com a ajuda de um otimizador automatizado chamado Knight, seu método reduziu o tempo total de inferência de 14,91 segundos para 3,56 segundos, alcançando uma aceleração de desempenho de 4,1 vezes. Isso representa um paradigma engenhosístico importante para a implementação de modelos MoE de grande escala em futuras plataformas de computação de super-nós. Uma equipe conjunta da Universidade Tsinghua e da Tencent venceu o campeonato global no desafio de otimização de inferência de modelos MoE da MLSys2026. Eles desenvolveram uma solução de otimização completa para modelos MoE com trilhões de parâmetros em hardware NPU, utilizando estratégias inovadoras como partição E-Shard e concorrência PSUM/GEMV. Com a ajuda de um otimizador automatizado chamado Knight, seu método reduziu o tempo total de inferência de 14,91 segundos para 3,56 segundos, alcançando uma aceleração de desempenho de 4,1 vezes. Isso representa um paradigma engenhosístico importante para a implementação de modelos MoE de grande escala em futuras plataformas de computação de super-nós.
Comentários (0)
0/300
OR