
option
Maison
Flash info
Contenu
RyanLopez
RyanLopez
25 mai 2026

Une équipe conjointe de l’Université Tsinghua et de Tencent a remporté le championnat mondial dans la compétition MoE Model Inference Optimization Challenge organisée par MLSys2026. Ils ont développé une solution d’optimisation complète pour les modèles MoE à des milliards de paramètres, exploitant du matériel NPU. Cette solution intègre des stratégies innovantes telles que la partitionnement E-Shard et la concurrence PSUM/GEMV. Avec l’aide d’un optimiseur automatique appelé Knight, leur approche a permis de réduire le temps total d’inference de 14,91 secondes à 3,56 secondes, soit une accélération de 4,1 fois. Ce résultat offre un modèle technique essentiel pour l’utilisation de grands modèles MoE sur les futures plateformes de calcul super-nœuds.
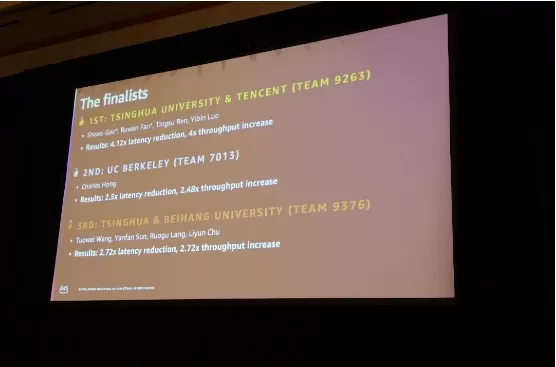
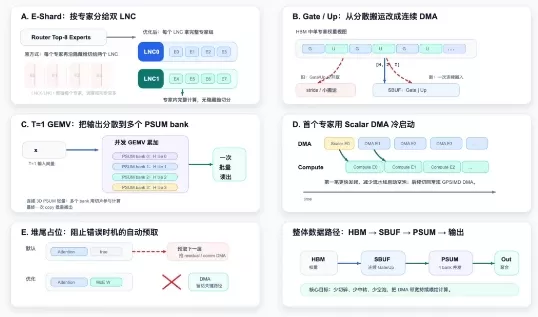
Une équipe conjointe de l’Université Tsinghua et de Tencent a remporté le championnat mondial dans la compétition MoE Model Inference Optimization Challenge organisée par MLSys2026. Ils ont développé une solution d’optimisation complète pour les modèles MoE à des milliards de paramètres, exploitant du matériel NPU. Cette solution intègre des stratégies innovantes telles que la partitionnement E-Shard et la concurrence PSUM/GEMV. Avec l’aide d’un optimiseur automatique appelé Knight, leur approche a permis de réduire le temps total d’inference de 14,91 secondes à 3,56 secondes, soit une accélération de 4,1 fois. Ce résultat offre un modèle technique essentiel pour l’utilisation de grands modèles MoE sur les futures plateformes de calcul super-nœuds. Une équipe conjointe de l’Université Tsinghua et de Tencent a remporté le championnat mondial dans la compétition MoE Model Inference Optimization Challenge organisée par MLSys2026. Ils ont développé une solution d’optimisation complète pour les modèles MoE à des milliards de paramètres, exploitant du matériel NPU. Cette solution intègre des stratégies innovantes telles que la partitionnement E-Shard et la concurrence PSUM/GEMV. Avec l’aide d’un optimiseur automatique appelé Knight, leur approche a permis de réduire le temps total d’inference de 14,91 secondes à 3,56 secondes, soit une accélération de 4,1 fois. Ce résultat offre un modèle technique essentiel pour l’utilisation de grands modèles MoE sur les futures plateformes de calcul super-nœuds.
commentaires (0)
0/300
OR